

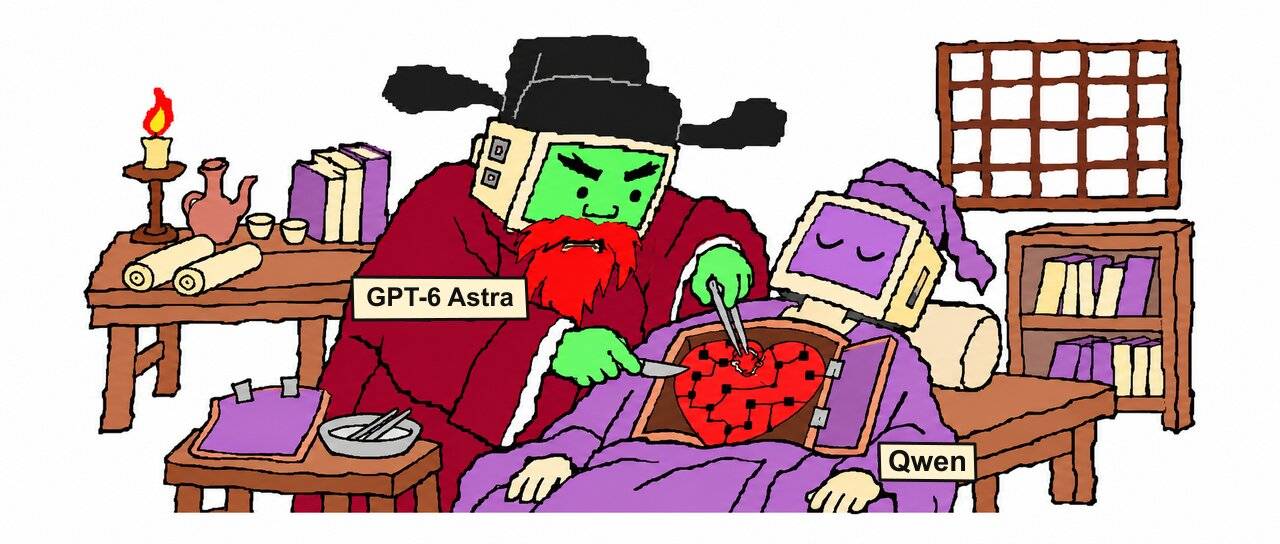
GPT-6 Astra 爆改 Qwen 大脑:只动 0.016% 参数,数学成绩疯涨
内容提要
MIT CSAIL 提出“权重空间编程”:让 GPT-6 Astra 直接读取并修改神经网络权重,无需梯度训练。仅改动 Qwen3.5-0.8B 约 0.016% 的参数,MATH-500 成绩从 7.9% 升至 48.1%,GSM8K 从 13.8% 升至 67.1%。但分析指出,提升主要源于修复模型重复推理的缺陷,而非注入新的数学能力;对少循环的 Gemma 提升有限,方法通用性仍待验证。
延伸解读
提分背后:修复缺陷而非注入新能力
Qwen3.5-0.8B 数学成绩的飙升,主要源于 GPT-6 Astra 修复了模型严重的重复推理问题。原文指出,在初始检查的 96 个练习答案中,有 85 个因循环生成而无法给出最终答案。Astra 定位并删除了 MLP 层中导致循环的特定方向,使触及 token 上限的回答比例从 93.0% 降至 33.1%。研究团队明确表示,这更像是移除了妨碍模型完成回答的障碍,而非向模型注入了新的数学知识。
通用性存疑:对少循环模型提升有限
该方法的效果高度依赖模型是否存在可被修复的缺陷。对于很少出现推理循环的 Gemma 3 270M,Astra 的修改并未带来明确提升:MATH-500 基线为 6.8%,修改后仅为 7.0%。这提示权重空间编程目前更像一种针对特定故障的修复工具,而非普遍提升模型能力的通用手段。其能否稳定适用于不同模型和任务,仍需更多实验验证。
争议焦点:需与简单基线对比
有质疑者指出,Astra 使用的思路与已有的激活引导方法相近,且提供给它的长提示词已明显暗示循环问题。因此,一个关键的对照实验是:直接关闭 Qwen 的思考模式能否取得类似提升?如果调整推理设置就能大幅减少循环,那么权重编辑的额外价值就需要重新评估。此外,该方法还应与正常梯度训练进行比较,而非仅与表现很差的原始模型对比。
能力边界:读写权重并非稳定通用技能
原文记录了多项失败案例,表明直接读写权重仍是前沿模型刚展现的能力,而非所有大模型都具备的通用技能。例如,在识别“谄媚模型”的实验中,Astra 仅比较权重时无法作出判断,直到被允许观察注意力模式才识别出差异。普林斯顿大学博士生 Xingyu Dang 的测试也报告,开源模型在这类任务上表现困难。这意味着权重空间编程的可靠性仍有明显局限。
Q&A
GPT-6 Astra 修改 Qwen 模型权重后,数学成绩具体提升了多少?
仅修改了 Qwen3.5-0.8B 的 131072 个参数(约 0.016%),MATH-500 成绩从 7.9% 升至 48.1%,GSM8K 从 13.8% 升至 67.1%,IFEval 指令遵循从 21.0% 升至 62.3%。
权重空间编程与传统微调有什么本质区别?
传统微调通过梯度训练更新权重,而权重空间编程让大模型直接读取和修改神经网络权重,无需梯度训练或环境反馈,仅通过自然语言目标定位并修改参数。
为什么说 Qwen 数学成绩的提升主要来自修复重复推理缺陷?
Astra 发现模型大量回答陷入重复推理,96 个练习答案中 85 个生成到 32768 token 上限仍未给出答案。它定位到 MLP 层的一个特定方向并删除该方向以抑制循环,从而让模型能完成回答,而非注入新数学知识。
这种方法对 Gemma 模型有效吗?
效果有限。对于很少出现推理循环的 Gemma 3 270M,Astra 修改后 MATH-500 成绩仅从 6.8% 升至 7.0%,没有明确提升,说明方法通用性仍待验证。
GPT-6 Astra 如何在不训练的情况下修改小车控制网络?
研究团队用 PPO 训练小车网络约 10 亿步但成功率仍为 0。Astra 收到权重、场景说明和失败记录后,一次回复提交参数补丁,仅修改 3.5% 的权重,加入“先后退蓄力再全速前进”的控制路径,使成功率从 0 提升至 100%。
权重空间编程目前存在哪些主要争议或局限?
争议包括:提升可能主要源于减少循环,与激活引导方法相近;长提示词已暗示循环问题;需与关闭思考模式或梯度训练对比;开源模型读写权重能力有限;在识别“谄媚模型”时仅比较权重无法判断,需观察注意力模式,说明直接读懂权重尚不稳定通用。
