
视频问诊系统上线后需持续监控与优化。关键指标包括通话成功率、端到端延迟、卡顿率、音画同步及用户投诉,并关注终端和网络分布。问题定位分三步:看影响范围、比对数据、复现问题。优化策略建议首月每周、稳定后每月迭代,单变量灰度调整。定期抽查问诊录像可发现隐性体验问题。
出海IM项目监控需关注五类指标:业务、技术、资源、合规和成本。监控体系应分为客户端、接入、逻辑、存储和基础设施五层,并设计合理的告警体系以快速响应故障。持续运营需定期演练、真实对账SLA、监控容量趋势及合规成本,以确保稳定性反映用户真实体验。
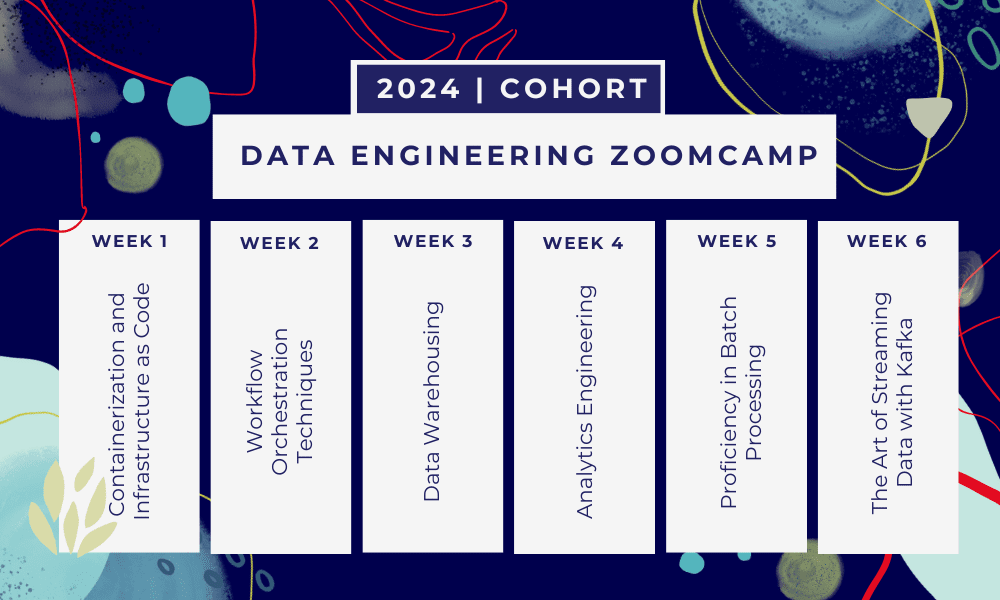
流式处理的五个配置原则包括:1) 状态恢复需使用共享存储,不能依赖单节点;2) 写出频率与数据量需平衡,建议每次写50-500MB;3) 分区数应与计算资源匹配,避免浪费;4) 有状态操作需设水位线控制状态增长;5) 上线前搭建监控指标,关注消费延迟、批处理耗时和状态存储大小。
A/B测试的失败通常源于实验实践不当,而非产品创意问题。常见陷阱包括数据质量差、提前查看结果和错误的指标优化。解决方案包括进行数据卫生检查、使用序列测试、实施CUPED方法以减少噪声,并设定监控指标以防止意外后果。成功的团队注重自动化和严格的实验流程,以确保数据的可靠性和有效性。
本文探讨了监控指标体系的设计,包括USE、RED、Golden Signals和业务KPI四种方法论。USE关注资源监控,RED关注请求处理,Golden Signals强调服务健康,业务KPI则衡量业务价值。文章强调建立完备指标体系的重要性,以避免监控盲区和告警疲劳,并提供了可直接应用的指标清单。
pgagroal 2.0.0发布,新增事件系统、管理协议,改进监控指标和Grafana仪表板,支持UTF-8密码,优化测试环境和文档。项目多次改进,提升了性能和稳定性,吸引更多开发者关注。
DMS(数据库迁移服务)是亚马逊云科技提供的托管数据迁移与同步服务,支持异构数据库的迁移和双向同步。文章介绍了DMS的核心组件、运维策略和监控指标,强调标准化运维流程和监控机制的重要性,以确保数据同步的稳定性和业务连续性。
华为云发布openGemini v1.2.0版本,通过内核优化提升了IoT场景的性能,包括查询效率、数据存储和功能丰富化。新增监控指标帮助分析和优化数据库性能。优化了数据编码、存储和临时文件磁盘占用,提升了写入性能和存储空间利用率。新增了SHOW TAG KEYS支持条件过滤和流式聚合功能。新增多个监控项,用于性能优化和根因分析。修复了多个Bug和漏洞。
Kubernetes 1.30发布了ValidatingAdmissionPolicy,作为验证入站请求的新声明性替代方案。文章介绍了如何使用该策略替代简单的webhook,以确保容器安全设置符合要求。通过示例展示了创建和绑定策略的过程,并进行验证。最后强调了新特性的清晰性和可读性,以及监控策略执行的指标。
本文介绍了Thymeleaf+SpringBoot2的高吞吐量调优技巧,包括监控指标、连接池和HTTP客户端调优、MongoDB调优以及Thymeleaf缓存。通过合理设置指标、调整连接池和HTTP客户端设置、优化MongoDB集群和启用Thymeleaf缓存等方法,可以提高系统的性能和吞吐量。
阿里云应用实时监控服务(ARMS)的智能告警能力可解决监控指标选择、告警阈值设置和起伏不定指标配告警的问题。ARMS提供监控指标推荐表和智能阈值推荐功能,支持区间检测和上下边界预览。运维工程师可通过ARMS配置高质量的告警规则,保障核心业务系统的稳定性。
cnosdb 2.3.2版本发布,新增监控指标和客户端分块模式,改进了Flight-sql实现和元观察优化查询交互,升级了datafusion版本,向Flatbuffers模型添加了额外方法。ReadySet是基于Rust的轻量级SQL缓存引擎,能将复杂SQL读取转变为快速查找,自动保持缓存与数据库同步,无需额外代码。
Serverless架构具有低成本、快速上线、自动扩展、高安全性和适合微服务等特点。需要监控执行时延、调用次数和错误率,以及其他云平台服务和账单。分布式监控系统如AWS的X-Ray可以解决函数事件驱动和短生命周期带来的困难。本文总结了Serverless系统中的经验和问题,并强调监控的重要性。
本文介绍了Cassandra的概述、特点、适用场景和监控关键指标及告警规则。Cassandra是一个开源的分布式数据库,具有可扩展存储、易管理、高可用性、适合写密集型应用、支持统计和分析、支持异地多活等特点。适用于大数据量、高写入频率、高可用性和容错性、跨数据中心和地理位置的数据复制和同步、需要分布式事务、灵活数据模型的应用场景。推荐监控CPU、内存、硬盘使用率、客户端连接数、Cassandra数据量、客户端读写分布比例等关键指标,并设置相应的告警规则。介绍了自建Prometheus监控和阿里云可观测监控Prometheus版两种监控方案。
本文介绍了使用Prometheus实现应用监控的实践,包括确定监控对象、选择监控指标、标识维度和联动技巧。
本文介绍了使用老版本 ZooKeeper 导致数据不一致的案例及原因,并建议增加磁盘容量或使用 MSE ZooKeeper 的全托管服务避免问题。MSE ZooKeeper 提供监控指标和 TopN 大盘,方便用户快速定位问题。
阿里云技术专家和高级研发工程师在 Flink Forward Asia 2022 数据集成专场上分享了基于 Flink CDC 构建现代数据栈的实践和改进。阿里云内部基于 Flink CDC 的现代数据栈解决了数据库和日志数据集成的痛点。未来 Flink CDC 2.4 版本将支持 Batch 模式、限流配置和更丰富的监控指标。文章提供了两个场景的 demo 展示。
Qdrant提供Prometheus/OpenMetrics格式的监控指标,支持通过两个端点获取:/metrics用于节点指标,/sys_metrics用于集群指标。监控内容包括应用、集合、快照和API响应等,帮助用户有效管理数据库状态。
完成下面两步后,将自动完成登录并继续当前操作。