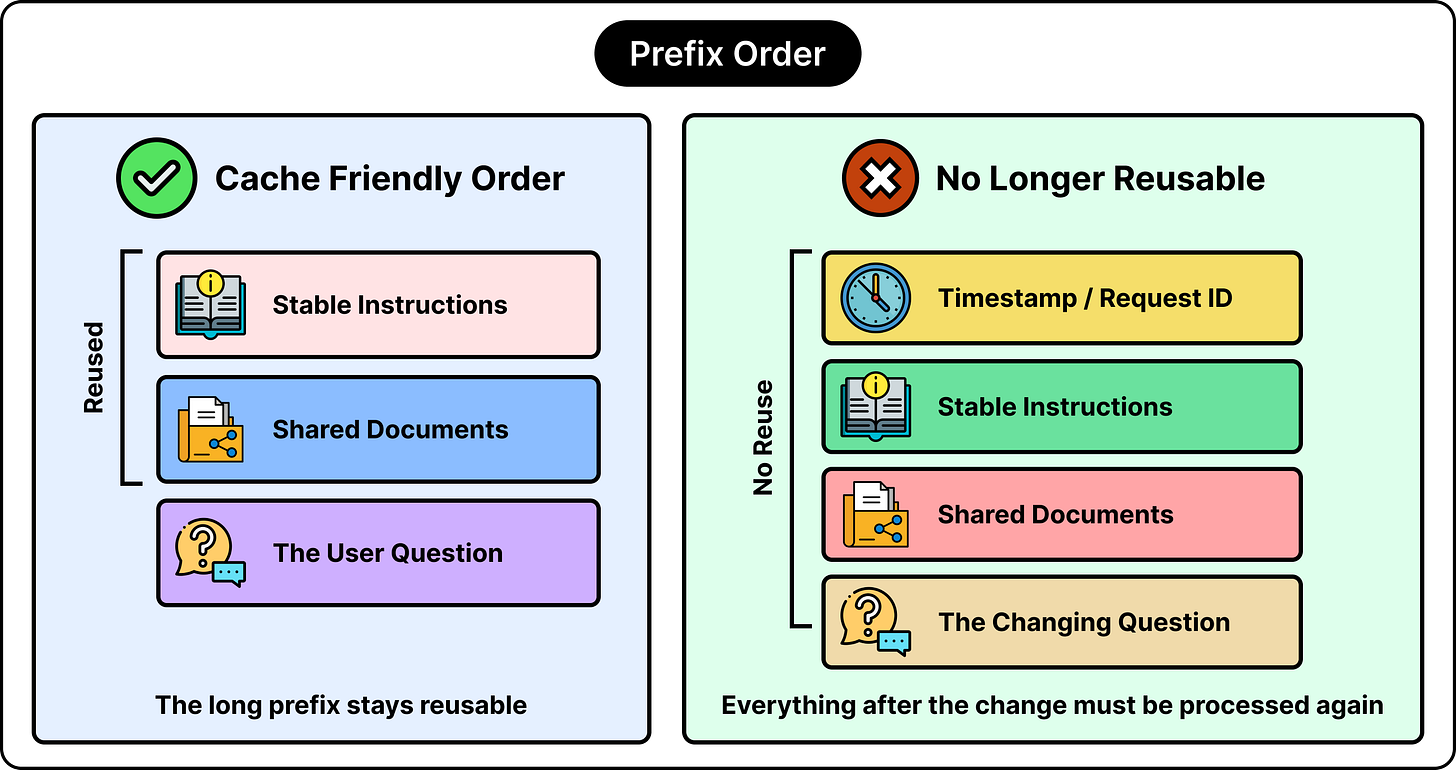
文章比较了LLM应用中的提示缓存与语义缓存。提示缓存复用请求开头共享内容(如指令、产品手册)已计算的KV状态,要求前缀完全一致,可降低输入处理成本,但输出仍需重新生成。语义缓存用嵌入模型匹配相似问题并复用旧答案,难点在相似度阈值:过严漏掉改写问题,过松返回错误答案,且需结合用户、权限、版本等元数据过滤,并靠TTL、版本化等策略失效缓存。两者可互补:先查语义缓存,未命中再调用LLM并利用提示缓存。
本文介绍为RAG流水线构建语义缓存:用Qdrant存储历史问题向量,命中则跳过知识库检索和LLM调用,节省时间与成本。相似度阈值需按用例校准,建议用金标集划分训练、验证、测试集调优。高阈值只能覆盖近似重复问题,可用Jev分类器处理灰色地带。缓存需设置过期时间,并在源文档变更时失效。
语义缓存通过识别相似查询来减少API调用,从而降低成本和响应延迟。它将查询转换为向量以查找相似的缓存响应。正确设置相似度阈值和选择合适的嵌入模型非常重要,错误配置可能导致错误答案。有效的缓存架构和监控能提升性能,适用于FAQ系统和客户支持。
完成下面两步后,将自动完成登录并继续当前操作。