


LLM 提示缓存与语义缓存之比较
内容提要
文章比较了LLM应用中的提示缓存与语义缓存。提示缓存复用请求开头共享内容(如指令、产品手册)已计算的KV状态,要求前缀完全一致,可降低输入处理成本,但输出仍需重新生成。语义缓存用嵌入模型匹配相似问题并复用旧答案,难点在相似度阈值:过严漏掉改写问题,过松返回错误答案,且需结合用户、权限、版本等元数据过滤,并靠TTL、版本化等策略失效缓存。两者可互补:先查语义缓存,未命中再调用LLM并利用提示缓存。
延伸解读
提示缓存:前缀顺序决定成败
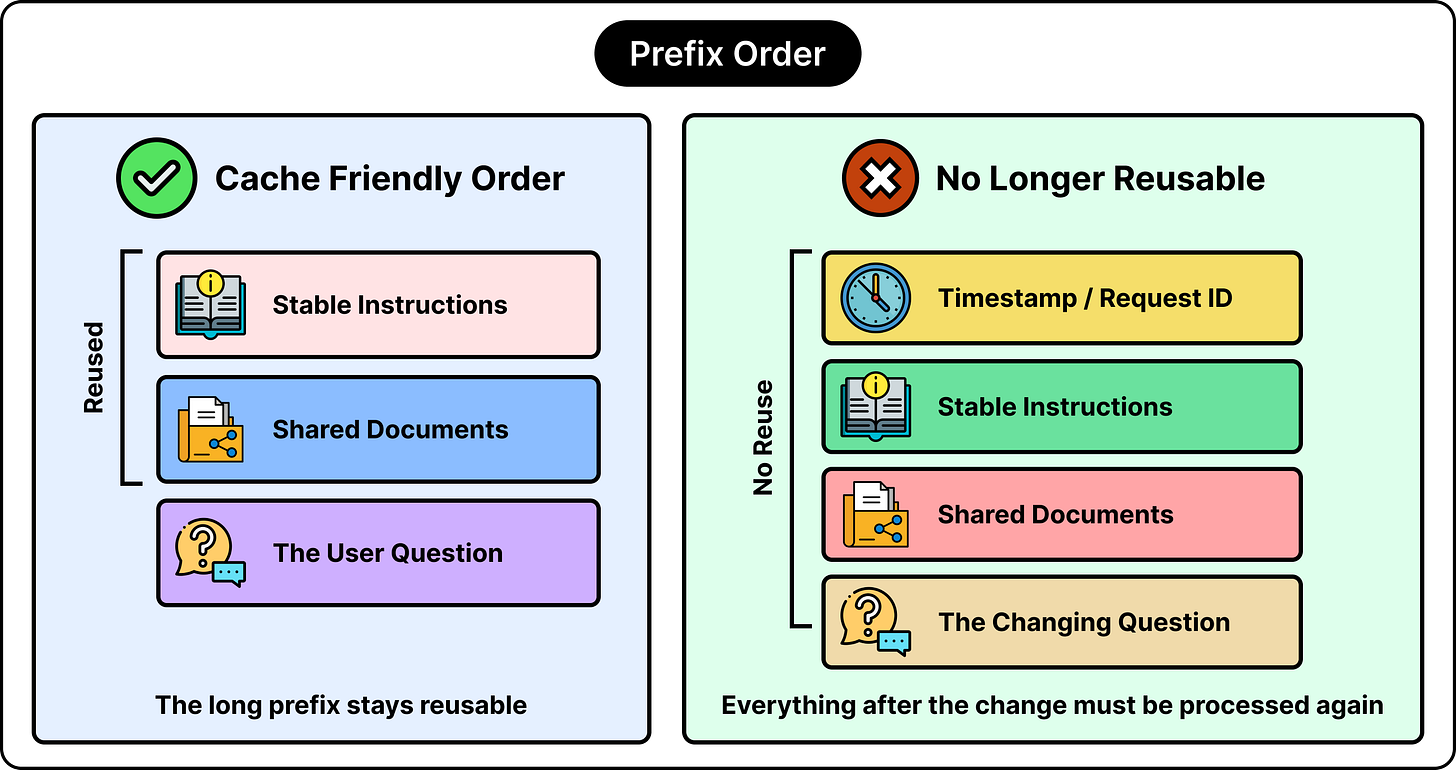
提示缓存要求共享内容必须放在请求开头,且前缀完全一致。文章指出,即使前缀中插入看似无关的时间戳或请求ID,也会改变后续内容的内部表示,导致无法复用。因此,固定指令、产品手册等稳定内容应置于可变问题之前,且措辞、文档顺序、请求设置都不能变动,否则缓存失效。
语义缓存:相似度阈值需按场景调优
语义缓存的核心难点是相似度阈值。阈值过严会漏掉合理改写的问题,过松则可能返回错误答案。文章强调,相似度分数不等于答案正确概率,且数字、否定、日期、产品版本等细微差异可能导致语义相近但答案不通用。因此需通过标注数据评估阈值,并监控缓存命中率与答案适用率,不能仅追求高命中率。
语义缓存不能只看问题本身
相同问题在不同上下文下可能需要不同答案,例如订单状态依赖用户和当前状态,离线支持依赖“它”指代的对象,语言不同也不能直接复用英文答案。文章指出,语义缓存需结合用户、权限、产品版本、语言、对话状态、数据版本等元数据过滤,且这些条件需在应用层强制执行,不能依赖嵌入模型自动识别。
缓存失效:TTL与版本化各有取舍
缓存答案可能因源信息变化而过时,例如退货政策从30天改为14天。文章介绍两种失效策略:TTL设定过期时间,但无法保证过期前的新鲜度;版本化可基于策略版本使旧答案失效,但全量版本更新会一次性废弃所有缓存,而细粒度失效需追踪答案与文档的依赖关系。此外,生成答案的指令、输出格式等设置变化也应触发失效。
Q&A
LLM 提示缓存和语义缓存到底有什么区别?
提示缓存复用请求开头共享内容(如指令、产品手册)已计算的 KV 状态,要求前缀完全一致,主要降低输入处理成本,但输出仍需重新生成;语义缓存用嵌入模型匹配相似问题并复用旧答案,可跳过整个 LLM 调用,但需处理相似度阈值和元数据过滤。两者工作阶段不同:提示缓存在模型内部输入处理阶段,语义缓存在应用层调用 LLM 之前。
为什么 LLM 请求的输入 token 也会产生很高成本?
因为输入不仅包含用户当前问题,还可能包含大量指令、示例答案、产品文档、历史对话等。例如一个 10 个单词的问题可能伴随数千个输入 token 的请求。这些输入 token 需要模型处理,因此产生成本,尤其是当相同的大段内容在每次请求中重复发送时。
提示缓存对共享内容的位置有什么要求?
共享内容必须放在请求的最前面(前缀位置),因为因果语言模型中 token 的表示依赖于前面的内容,后面的问题不会影响前缀的表示。如果在前缀前插入时间戳、随机请求 ID 或不同问题,会改变后续内容的处理方式,导致无法复用缓存。此外,指令必须完全一致,不能有措辞、顺序或请求设置的改变。
语义缓存的相似度阈值应该怎么设定?
阈值需要根据具体应用权衡:过严会拒绝许多合法的改写问题,降低命中率;过松会接受不合适的答案,增加错误风险。没有通用最优阈值,应通过评估流程确定,测试集需包含合法改写和困难近匹配案例,并同时测量缓存命中率和答案适用比例。
语义缓存为什么不能只靠问题相似就返回旧答案?
因为相同问题在不同上下文下可能需要不同答案,例如“我的订单状态是什么”取决于客户和订单当前状态,“它支持离线访问吗”取决于“它”指代什么。此外,权限、产品版本、语言、对话状态、源数据版本等都会影响答案适用性。语义缓存需要结合元数据过滤来限制搜索范围,不能仅依赖嵌入相似度。
如何让提示缓存和语义缓存配合使用?
两者互补,可组合使用:应用先查语义缓存,若命中则直接返回旧答案,无需调用 LLM;若未命中,再调用 LLM 并利用提示缓存复用共享前缀的 KV 状态。还可以在语义查找前增加精确答案缓存,廉价处理完全相同的重复请求。缓存查找不一定在流程最前,如需验证源版本,该检查应更早进行。
语义缓存什么时候需要失效?有哪些失效策略?
当源信息变化(如退货政策从 30 天改为 14 天)、产品版本更新或生成答案的指令/输出格式改变时,旧缓存答案可能不再正确,需要失效。常用策略包括:设置 TTL 限制缓存存活时间;使用版本化(如 policy_version)使旧版本答案不可用;以及基于依赖关系选择性失效,只使受影响的答案失效,而非整个知识库。
