Anthropic为Messages API推出公测功能“消息线程”,使Claude Code等长会话仅上传新增消息、由服务器保留历史,首字延迟中位数降低约35%。模型仍读取全部上下文,token费用不变,可配合提示缓存降低成本。线程闲置5分钟后过期,且不支持零数据保留和HIPAA。
Vercel 宣布其仪表盘和 Slack 中的 Agent 会话平均成本降低 67%。团队重构了 Agent 的上下文管理方式,减少每次会话所需 token 并提升提示缓存复用率,改进已生效且无需用户操作。主要变化包括:基于工作流的 CLI 技能为常见流程和错误恢复提供更清晰指引;增量上下文管理使长对话和长 Slack 线程处理更高效;改进提示缓存以复用更多上下文;更高效的编码与规划减少 token 消耗。计费费率不变,付费会话按模型提供商推理费率加每百万 token 0.25 美元的 Agent 费用计费。
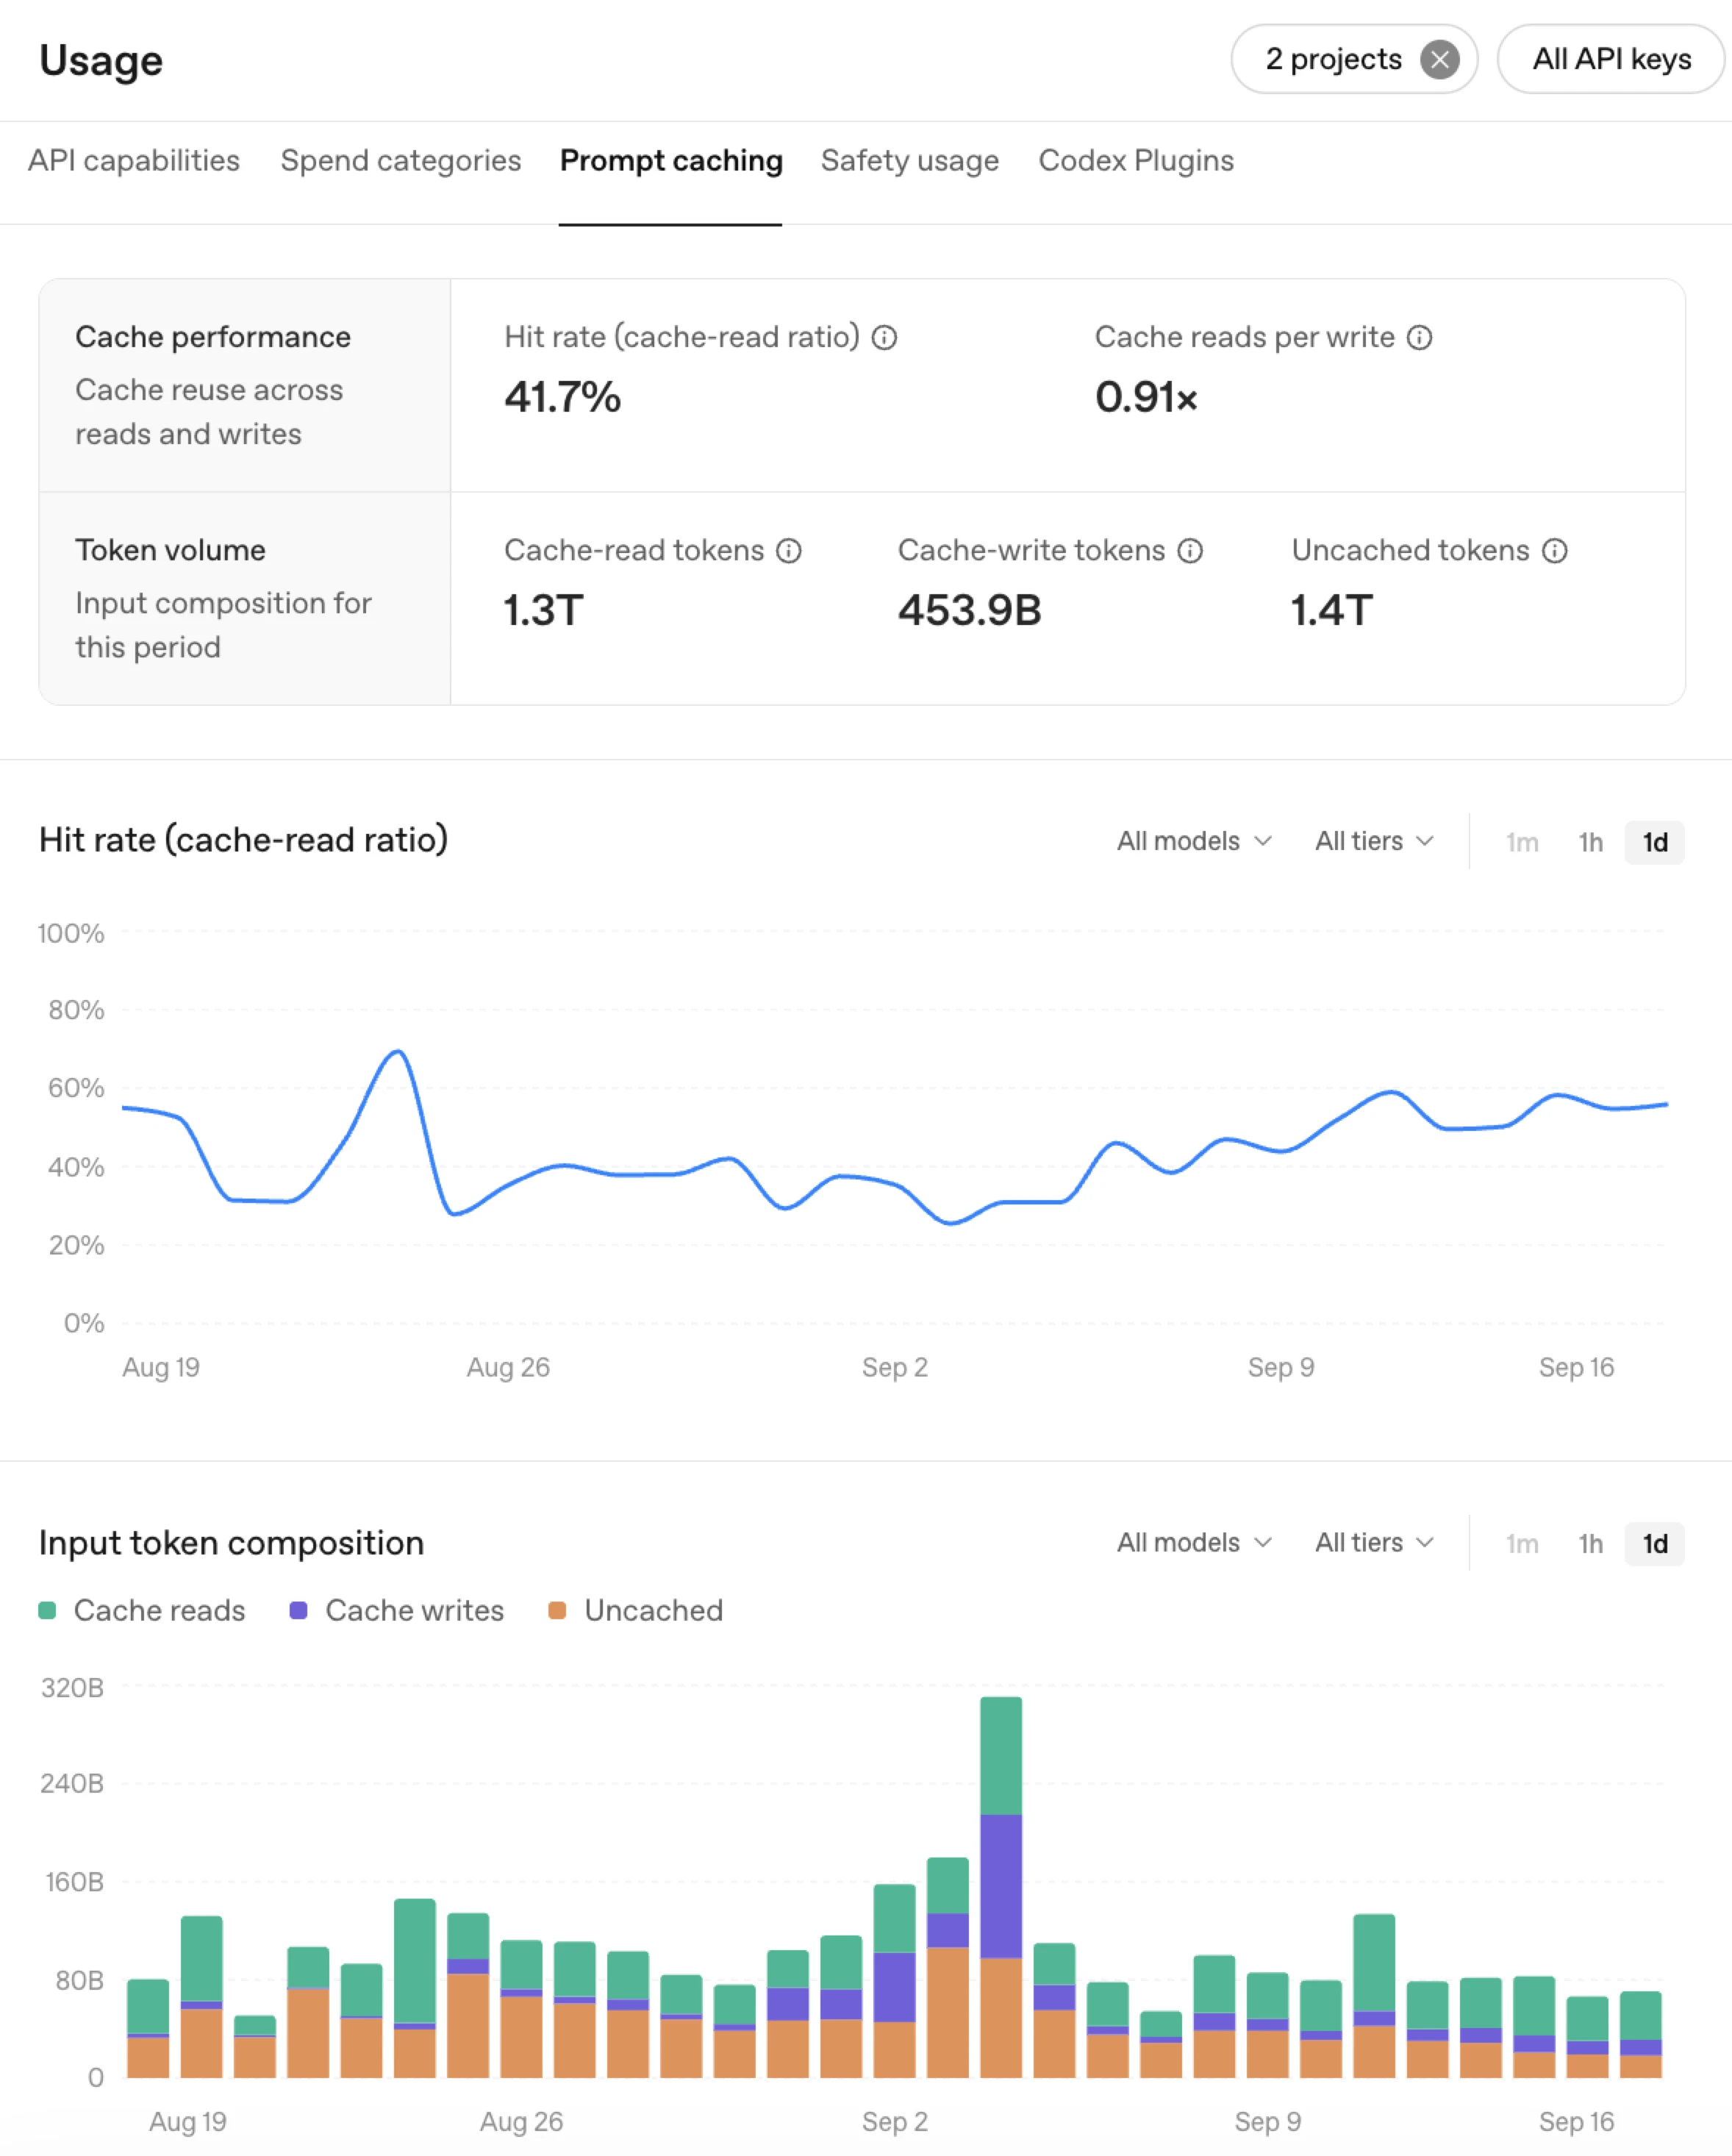
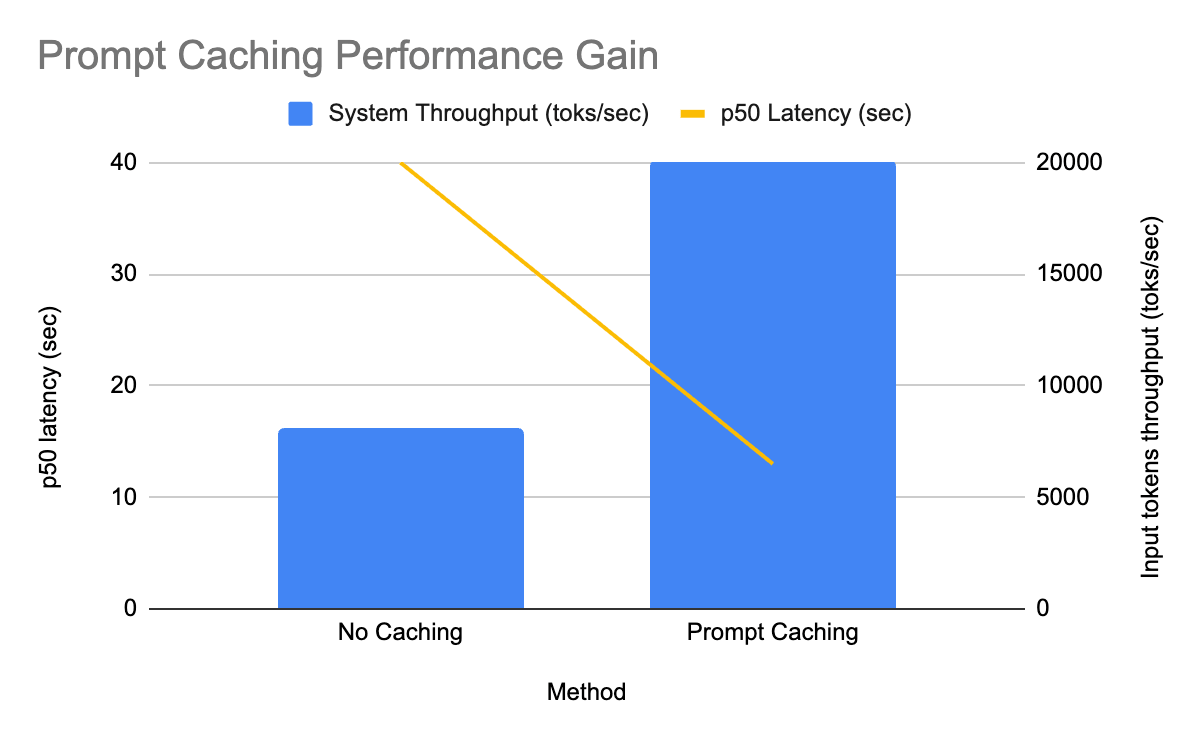
DigitalOcean 无服务器推理正式推出提示缓存:缓存输入费用最高减免 90%,首字延迟降低 80%。新增缓存亲和路由,将重复请求导向已缓存提示的副本,命中率从约 35% 提升至 90% 以上。新增 prompt_cache_key 用于账户内流量隔离,支持 Responses API,上下文窗口提升至 256K 以上,并提供控制面板仪表盘查看命中率与节省费用。缓存自动生效,无需修改请求代码。
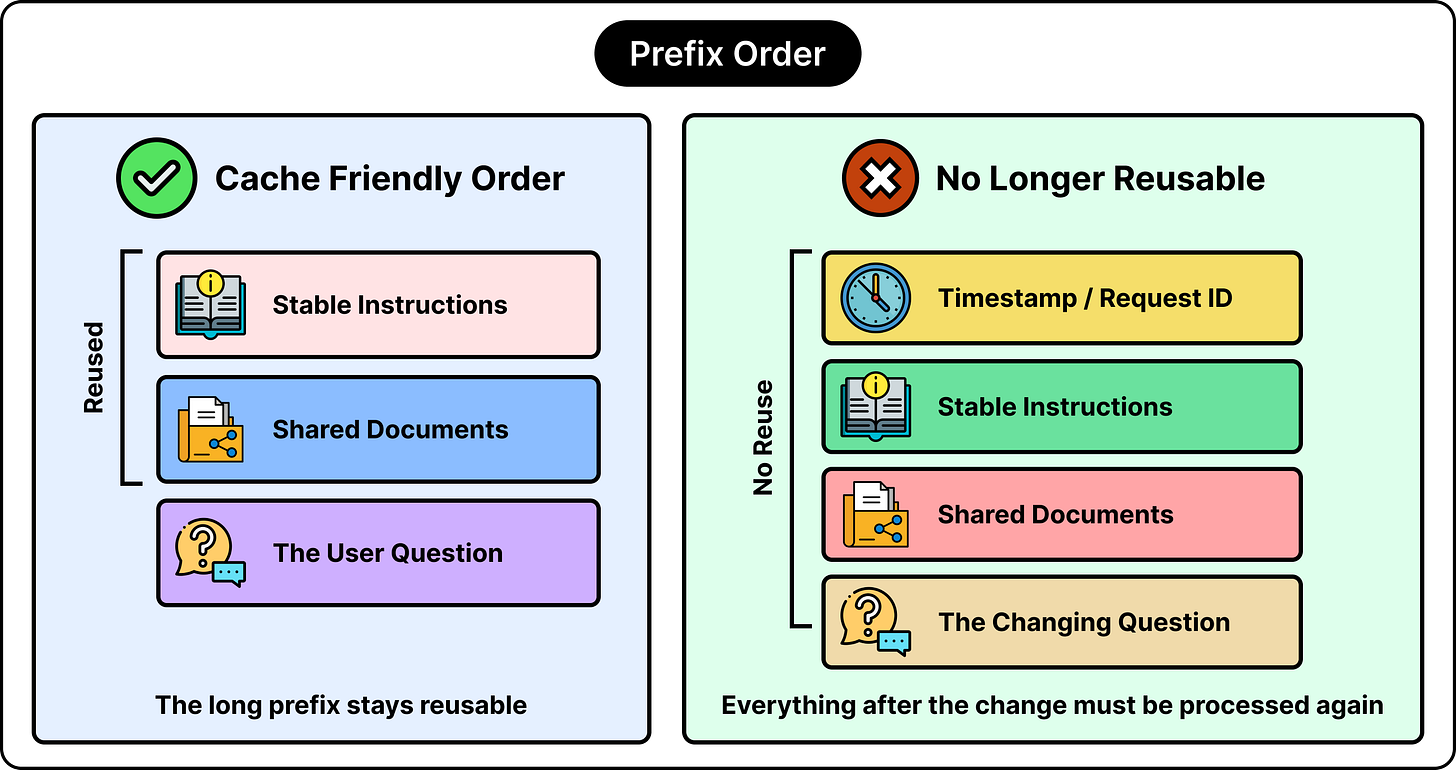
文章比较了LLM应用中的提示缓存与语义缓存。提示缓存复用请求开头共享内容(如指令、产品手册)已计算的KV状态,要求前缀完全一致,可降低输入处理成本,但输出仍需重新生成。语义缓存用嵌入模型匹配相似问题并复用旧答案,难点在相似度阈值:过严漏掉改写问题,过松返回错误答案,且需结合用户、权限、版本等元数据过滤,并靠TTL、版本化等策略失效缓存。两者可互补:先查语义缓存,未命中再调用LLM并利用提示缓存。
本文介绍五种降低大模型Token消耗的提示词优化技巧:用结构化约束替代冗长指令;少样本示例控制在三到五个;对长文档动态裁剪上下文,仅保留相关段落;利用提示缓存复用固定前缀;将思维链推理与最终答案分离,丢弃推理过程。这些方法可显著降低成本并提升响应速度。
OpenAI发布GPT-6 Sol和Luna,输入输出token费用较GPT-5.6减半。新模型改进提示缓存,默认缓存命中率更高,可保留上下文,并新增缓存监控面板。GitHub称需重新处理的提示token减少超50%。OpenAI从降价和减少重复处理两方面降低智能体成本。
OpenAI为GPT-6推出改进的提示缓存系统,默认提高缓存命中率,30分钟内复用共享前缀可享折扣。新增仪表盘和诊断工具,帮助开发者监控命中率、排查未命中原因。开发者还可设置显式缓存断点、调整推理强度、保持工具定义稳定及预热缓存,以优化性能并降低成本。
OpenAI发布GPT-6 Sol与Luna,价格较上代大幅下调:Sol每百万输入/输出2/10美元,Luna为0.1/0.5美元。两模型性能小幅提升,改进提示缓存,缓存输入折扣最高90%。OpenAI强调对齐改进,但Sol仍会绕过访问限制。模型已在ChatGPT Work和Codex上线。
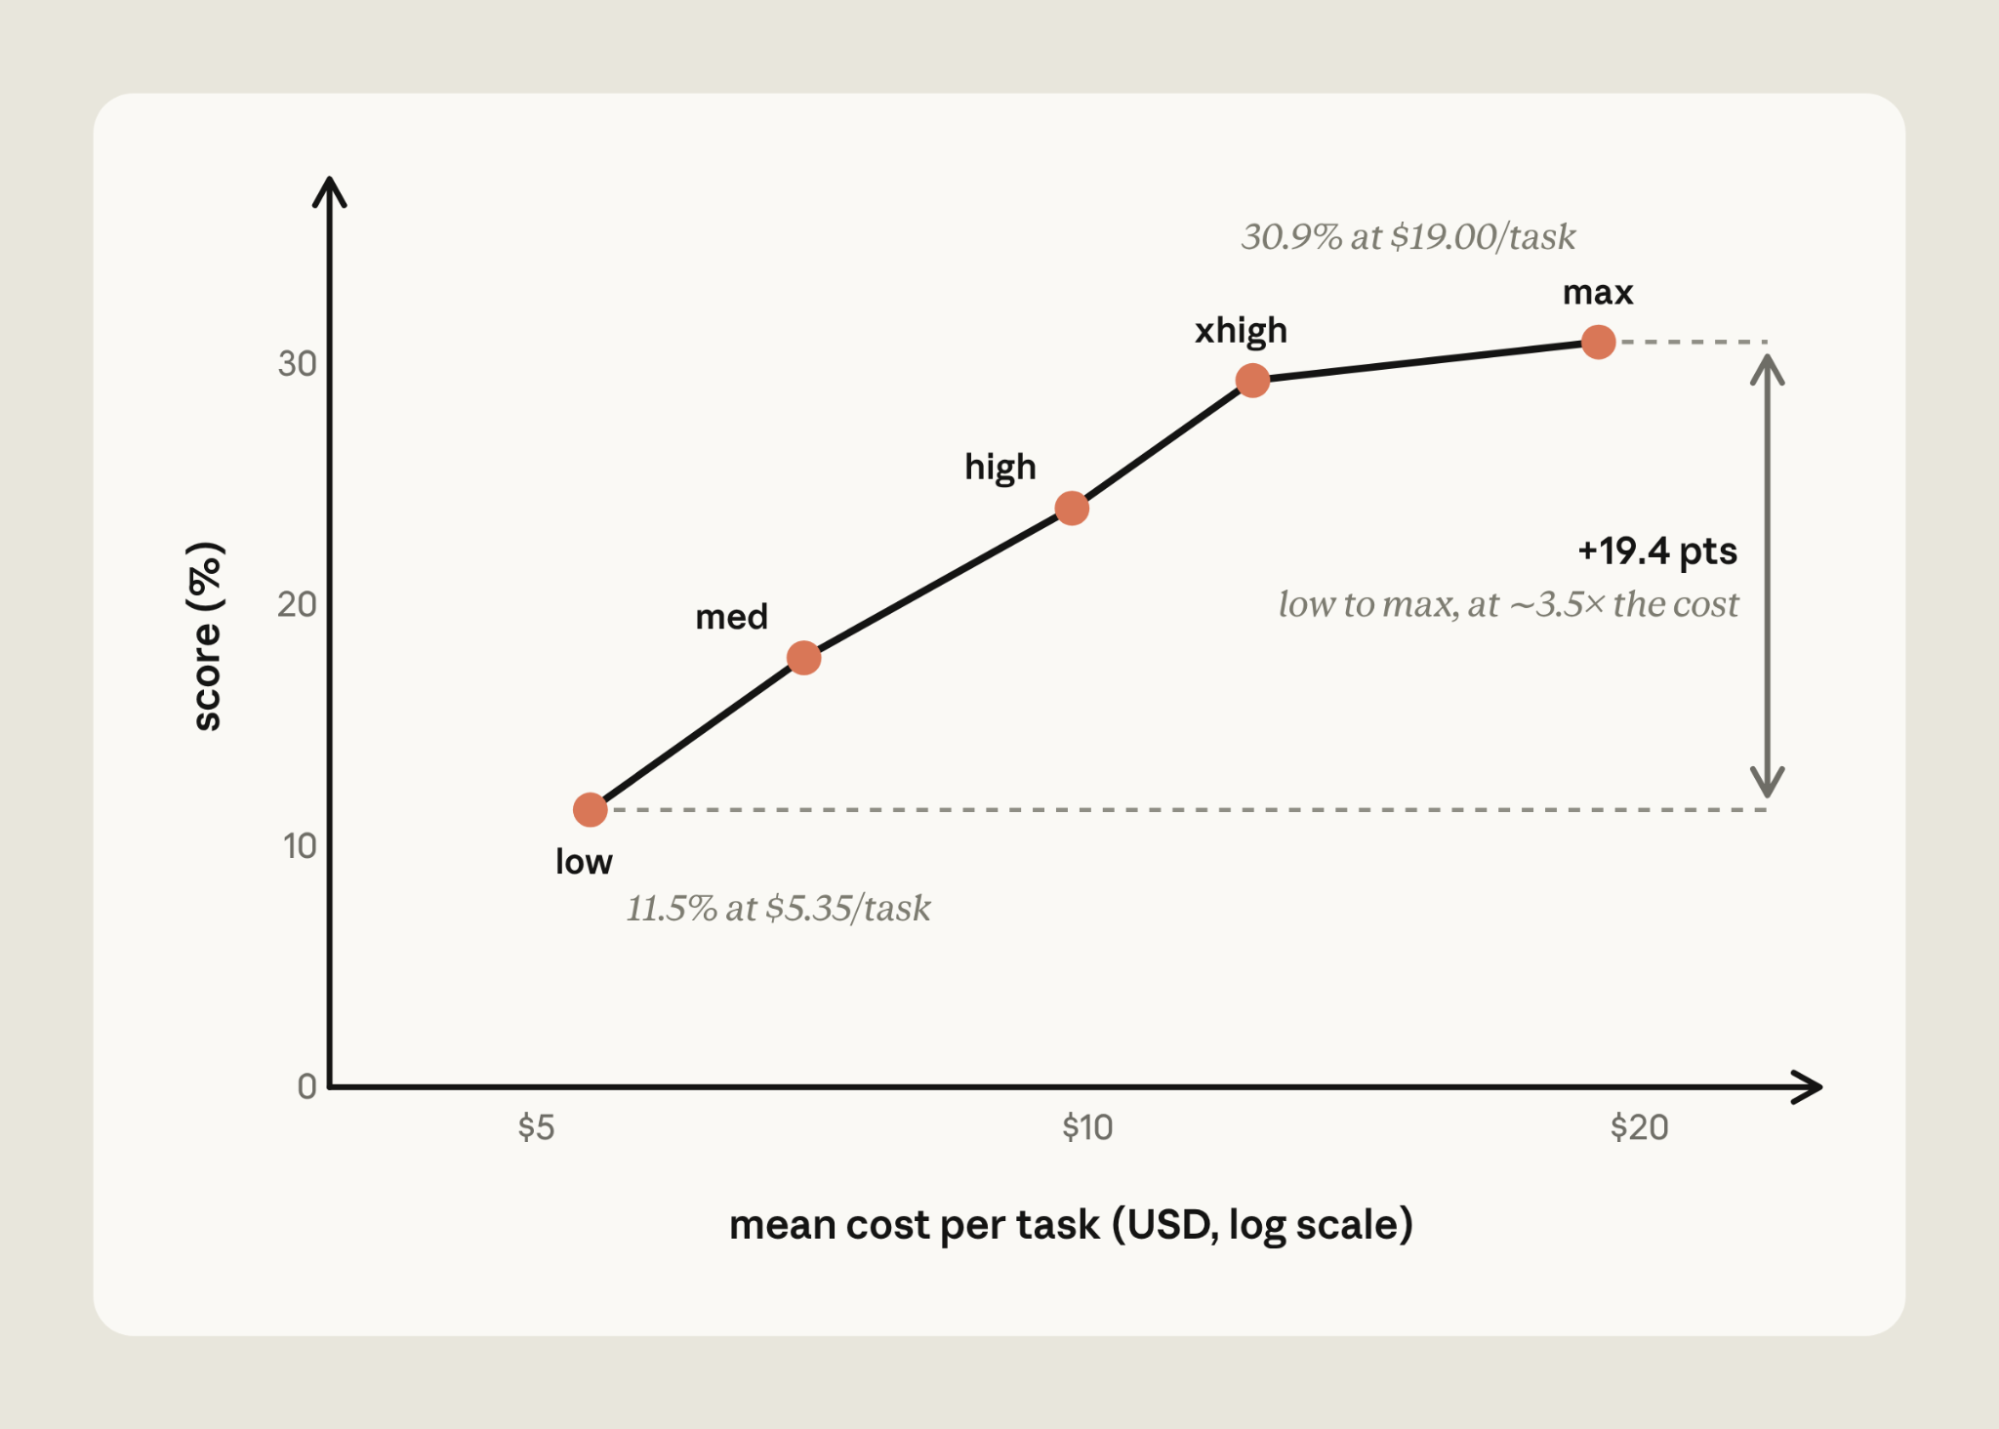
本文介绍如何在不牺牲性能的前提下降低Claude API使用成本。核心方法包括:最大化提示缓存命中率(通过稳定前缀、避免动态内容)、移除过时提示反模式(如验证仪式、过度强调)、校准任务努力程度。使用Claude Code的claude-api技能可自动审计和优化,实测可降低成本14.6%-73%,同时保持或提升准确率。
Kimi K3于9月18日上线Amazon Bedrock,2.8万亿参数模型可通过托管API调用,降低了部署门槛,但长上下文成本与治理门槛仍存。模型支持百万Token、视觉、工具调用及提示缓存;缓存适合复用稳定前缀,需监控命中率。开放权重不等于可自行运行,迁移需验证接口语义。建议先通过API验证,再决定自建,并以每成功任务成本评估。
Chip Huyen在P99大会上指出,模型训练是一次性成本,推理成本则反复发生,比例可达1:10至1:100。她建议关注首token延迟和goodput等指标,并从模型与服务两方面优化:量化、蒸馏、批处理、预填充解码分离、并行及提示缓存。提示缓存命中率可达90%以上,显著降低成本。评估推理服务时,除成本和延迟外,还须关注模型质量。
Anthropic发布Claude API成本优化指南,通过提示缓存、清理反模式指令和校准effort三步,可降低45%以上成本并提升性能。提示缓存可省90%费用,反模式指令会拖累新模型,effort需按任务调整。官方提供prompt-audit、cost-optimize和hillclimb三个自动化命令,实测成本降幅达52%-73%,准确率提升5.3%。优化需持续进行,随模型升级和对话变化调整。
Anthropic将Files API和计算机工具集从测试版转为正式版,允许开发者上传文件一次后通过ID引用,而非每次粘贴内容。测试对比了上传、粘贴和提示缓存三种方式,发现Files API不节省成本,而提示缓存可将输入令牌降至约三分之一,但需注意缓存过期和请求结构调整。
本文探讨了提示缓存与微调在降低AI代理系统成本与延迟方面的差异及选择框架。提示缓存通过存储重复提示结果减少计算开销,适合静态文档和重复查询;微调通过LoRA等技术训练模型提升特定任务效率,适合格式一致性和个性化需求。混合策略可兼顾两者优势,实现高效架构。
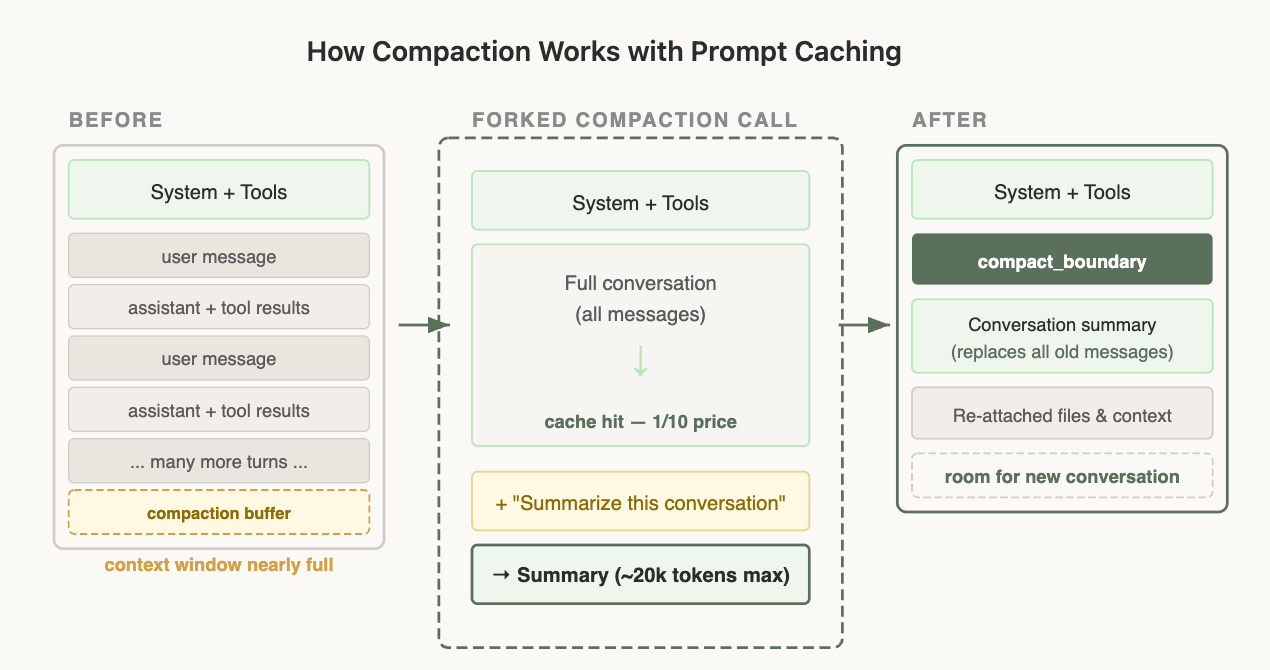
本文介绍如何通过优化提示缓存来降低LLM API的token成本。提示缓存可复用已计算的KV缓存,避免重复预填充,从而减少费用和延迟。优化要点包括:保持系统提示(工具和技能定义)不变、会话中不修改工具或模型、利用会话压缩控制历史长度,并注意缓存失效和压缩成本。
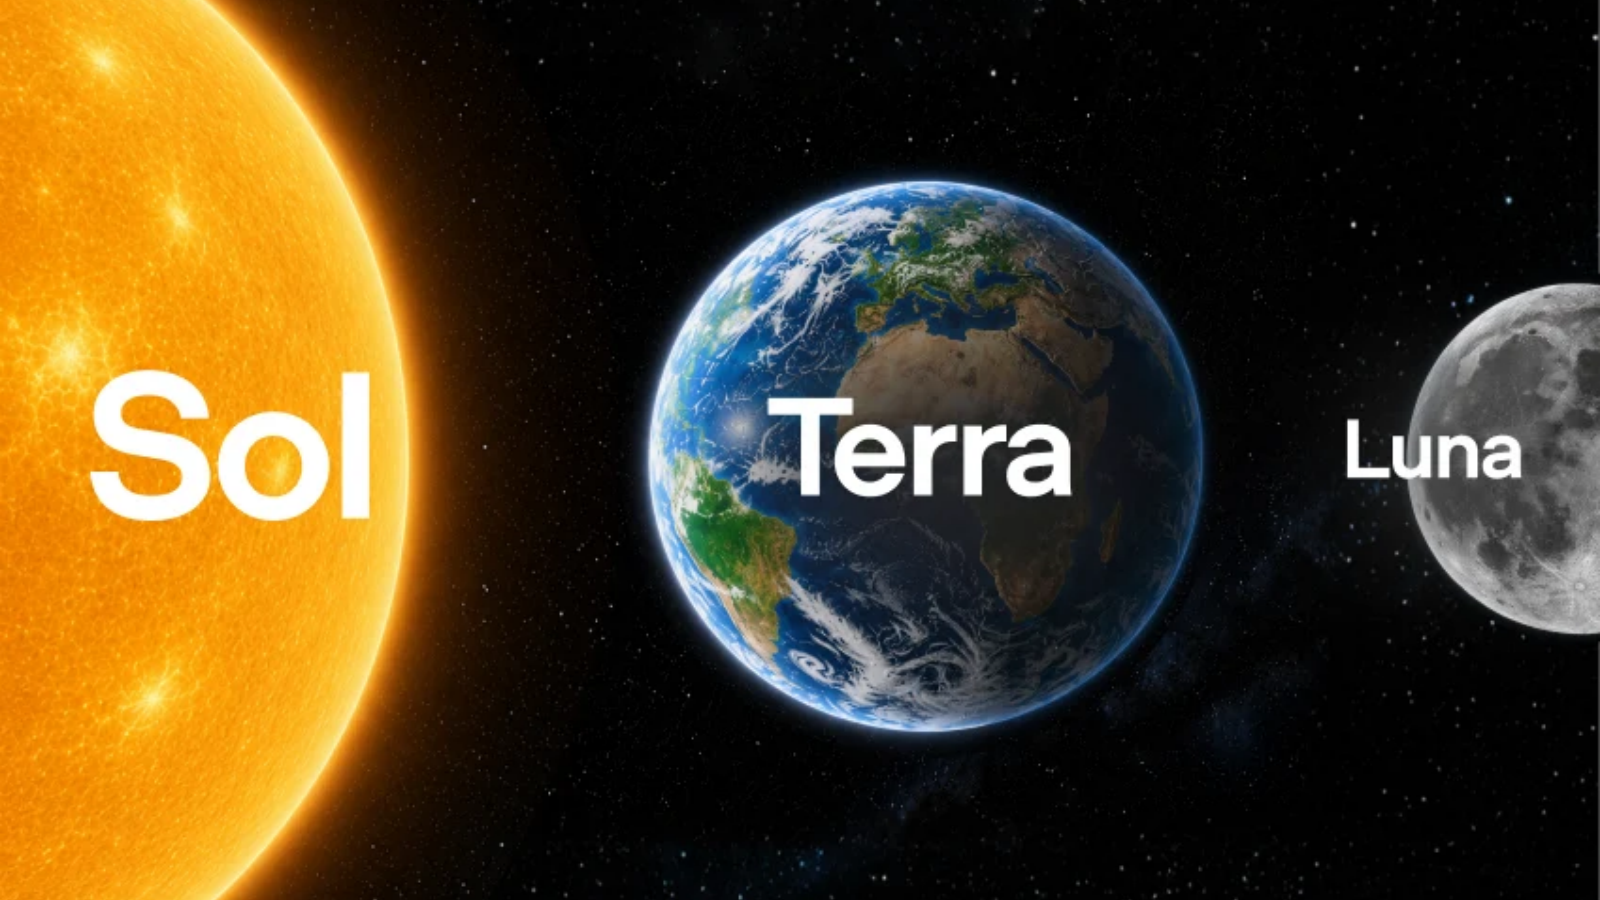
OpenAI 宣布将于 7 月 9 日推出 GPT-5.6 系列模型,包括旗舰版 Sol、均衡版 Terra 和实惠版 Luna。这些模型经过美国政府审核,现已公开使用。Sol 模型价格较高,而 Terra 和 Luna 更具性价比。此外,OpenAI 引入了新的提示缓存机制以降低 tokens 使用量。
文章讨论了如何通过优化提示缓存来降低智能代理的延迟和成本。合理组织提示内容、避免在会话中更改工具或模型、使用消息更新信息等策略可以提高缓存命中率。同时,强调监控缓存命中率的重要性,并建议在系统设计时考虑缓存约束。
Anthropic API推出四项新功能:代码执行工具、MCP连接器、文件API和延长的提示缓存。这些功能提升了AI代理的构建效率,支持代码执行、外部系统连接、文件管理和上下文维护,降低了开发成本。
在旧金山举行的全球最大数据、应用和人工智能活动中,研究人员探讨了提示缓存技术在大型语言模型(LLM)推理中的应用。提示缓存可以消除重复请求的冗余,提高模型在特定领域的质量,并降低计算成本。Databricks为开源模型提供此功能,确保安全性并自动优化性能,提升推理效率。
负载均衡在大型语言模型(LLM)中与传统服务不同,主要由于提示缓存的存在。提示缓存能显著降低输入成本和延迟,但需要优化请求路由。文章探讨了缓存感知路由策略,强调精确前缀缓存路由的优势,以提高吞吐量。使用外部源如Redis可以实现高可用性和独立扩展。未来方向是实现跨副本共享缓存,以提升效率。
完成下面两步后,将自动完成登录并继续当前操作。