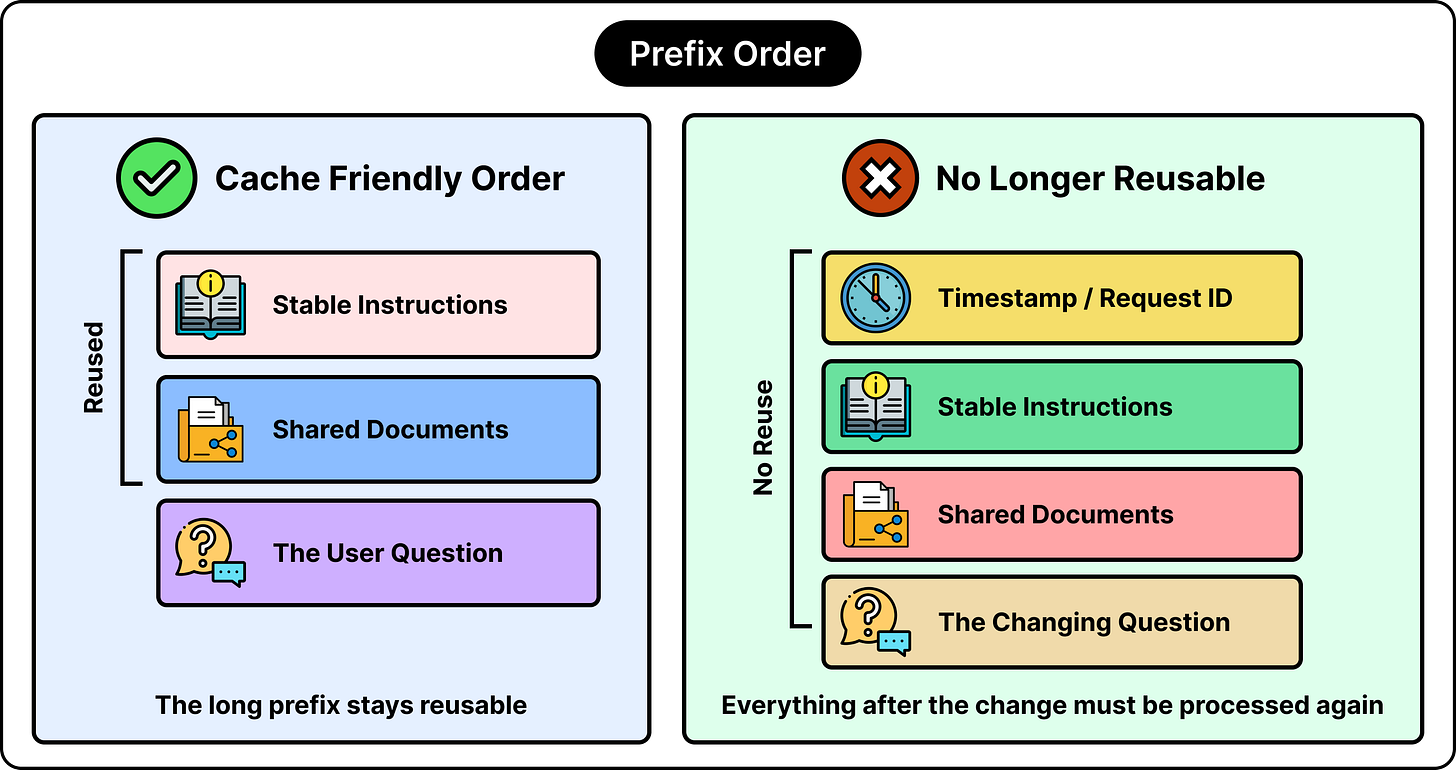
文章比较了LLM应用中的提示缓存与语义缓存。提示缓存复用请求开头共享内容(如指令、产品手册)已计算的KV状态,要求前缀完全一致,可降低输入处理成本,但输出仍需重新生成。语义缓存用嵌入模型匹配相似问题并复用旧答案,难点在相似度阈值:过严漏掉改写问题,过松返回错误答案,且需结合用户、权限、版本等元数据过滤,并靠TTL、版本化等策略失效缓存。两者可互补:先查语义缓存,未命中再调用LLM并利用提示缓存。
TimThumb是轻量级PHP图片缩放脚本,可按URL参数动态缩放、裁剪并缓存图片,常用于WordPress主题生成缩略图。其原理是读取原图,按w/h/zc等参数处理并缓存输出。旧版本存在严重安全漏洞,须升级至2.8.14以上,限制图片来源、关闭任意外链抓取、正确设置缓存目录权限并禁止执行PHP。新项目建议优先使用WordPress原生缩略图或现代图片处理方案。
以无索引查询为例:当表大于 shared_buffers 的四分之一时,Postgres 默认启用 synchronize_seqscans,新的顺序扫描会从上次停止处开始。首次扫描耗时 78 毫秒、读取 31598 页;后续仅 0.07 毫秒、读取 14 页,快约 1100 倍,这并非缓存所致。单次 EXPLAIN ANALYZE 只是样本量为 1,应多次运行并比较标准差与均值之比,以识别异常单次结果或累积效应。
为WordPress老博客添加多语言功能时,可采用前端翻译挂件方案:不改动原有代码,调用大模型将页面翻译成目标语言,并按词语或段落缓存译文以提升效率。该方案接入快,适合老项目,但翻译准确度和效率不如预先写好译文。
分布式缓存架构中,缓存是介于数据源与访问者之间的高速存储,关键指标为命中率,受键集合大小、内存空间和生存时间影响。常见类型包括代理缓存、CDN、通读缓存和旁路缓存。需防范缓存雪崩、穿透,并做好预热。Redis支持复杂数据结构、主从复制和16384槽集群,优于Memcached。
NVIDIA公布HSTU推荐部署流程,采用PyTorch AOTI编译、FlexKV缓存与Dynamo-Triton服务,八层模型满命中时延迟最高改善5.93倍,但收益取决于用户历史前缀复用率,50%命中时加速不足2倍。建议先验证输出一致性,再测试各命中率下的延迟、缓存失效与显存淘汰,并将推荐质量纳入验收,按每千次请求节省的GPU毫秒决策。
Vercel CDN 不再缓存 Vary 头包含 Cookie 的源站响应,因为 Cookie 值多样会导致缓存条目过多且难以复用。响应仍正常返回,但不会被存储。可通过 x-vercel-cache 为 MISS 及日志中的 vary_key_denied:cookie 识别。若响应与 Cookie 无关,应移除 Vary 中的 Cookie;若依赖 Cookie,则保留并设置 Cache-Control: private。其他 Vary 头的缓存行为不变。
FastAPI 推出官方 Redis 集成 fastapi-redis-sdk,遵循依赖注入模型,连接管理绑定应用生命周期,原生支持同步与异步依赖。提供 HTTP 缓存行为与缓存控制头,并支持限流、条件缓存、动态 TTL 等高级模式。该 SDK 兼容自托管与 FastAPI Cloud,后者已公测,Redis Cloud 作为原生集成可直接连接或免费创建数据库。
jevcache 是围绕 TypeSafe Jev 模型的命令行缓存工具,将 Jev 返回的类型化决策按脱敏状态指纹存入本地账本,命中即返回,不再调用模型。Jev 只做选择不生成文字,速度快、成本低,但概率值存在漂移。jevcache 缓存离散答案而非概率,可发布共享决策,但需注意阈值漂移与指纹粒度问题。
knitr 缓存功能改进:新增 process_cache() 泛型,使 terra 栅格等指针对象可安全缓存;缓存改用 xfun 的 .rds 格式,兼容旧缓存;dependson 支持依赖未缓存代码块,通过将上游代码纳入缓存键实现失效,autodep 同样适用。
本文介绍小语言模型窄域自动化优化的第二种策略:复用提示前缀的键值缓存。窄域任务提示中静态指令占绝大部分,逐条重算全部前缀十分浪费。作者用Qwen2.5-0.5B在600条工单上测试,将静态前缀预填充一次并缓存,每条仅处理变化的后缀,并需正确设置注意力掩码、缓存位置,处理后裁剪缓存。结果运行时间从184.85秒降至80.07秒,减少约57%,预测完全一致。
大语言模型重复调用会重复计费,可通过缓存避免:先对请求、上下文、模型设置等做哈希精确匹配,未命中再用向量相似度语义检索,命中后回填精确缓存。需按场景设阈值和过期时间,实时数据、个性化及创意任务不宜缓存。实测可省约六成调用成本。
AI模型部署耗时主要来自加载权重、KV Cache初始化和CUDA内核编译。作者在T5000芯片上预编译CUDA内核,将cache、triton、nv等目录打包为缓存包,用户下载后无需重复编译,部署时间从40分钟缩短至16分钟。
DeepSeek开源C++20库DeepJIT,为英伟达CUDA与华为昇腾NPU提供统一的内核JIT编译、缓存与启动接口,统一的是编译外围流程而非编译器本身。核心亮点是含自定义签名的多级缓存与分布式共享缓存,可减少集群重复编译。相比Triton、CuPy各有取舍,目前缓存预热和Python API尚未完成。
深度求索宣布DS V4 Flash模型将于9月10日降价,缓存命中降幅60%,未命中降33%,输出仅降11%。相比8月17日涨价前,仅闲时缓存价格持平,其他模式仍贵100%至300%,整体降幅有限。
本文讨论长上下文推理服务的缓存与调度优化。核心原则是缓存未命中比命中贵几个数量级,因此设计围绕复用展开:单实例内通过块哈希实现前缀缓存;KV池采用write-back策略在GPU、DRAM、SSD间分层存储;集群层面用一致性哈希实现缓存亲和,并按请求类别分配预算以应对长请求突发。
A社发布Claude Fable/Mythos 5.1模型,支持1M上下文窗口和128K输出,能力显著提升,尤其在科学和编程领域。API价格不变,但缓存读取价格暴降75%。Mythos 5.1放宽安全限制,仅限认证机构使用。
Cloudflare实习生Aashi Patel开发了Cache Transcoding系统,利用Zstandard压缩算法在Pingora中编码缓存资产,将可压缩文本平均缩小至原大小的三分之一。该系统以少量CPU开销换取存储和带宽节省,测试中处理了超百万请求,验证了架构可行性,未来将优化压缩级别和参数。
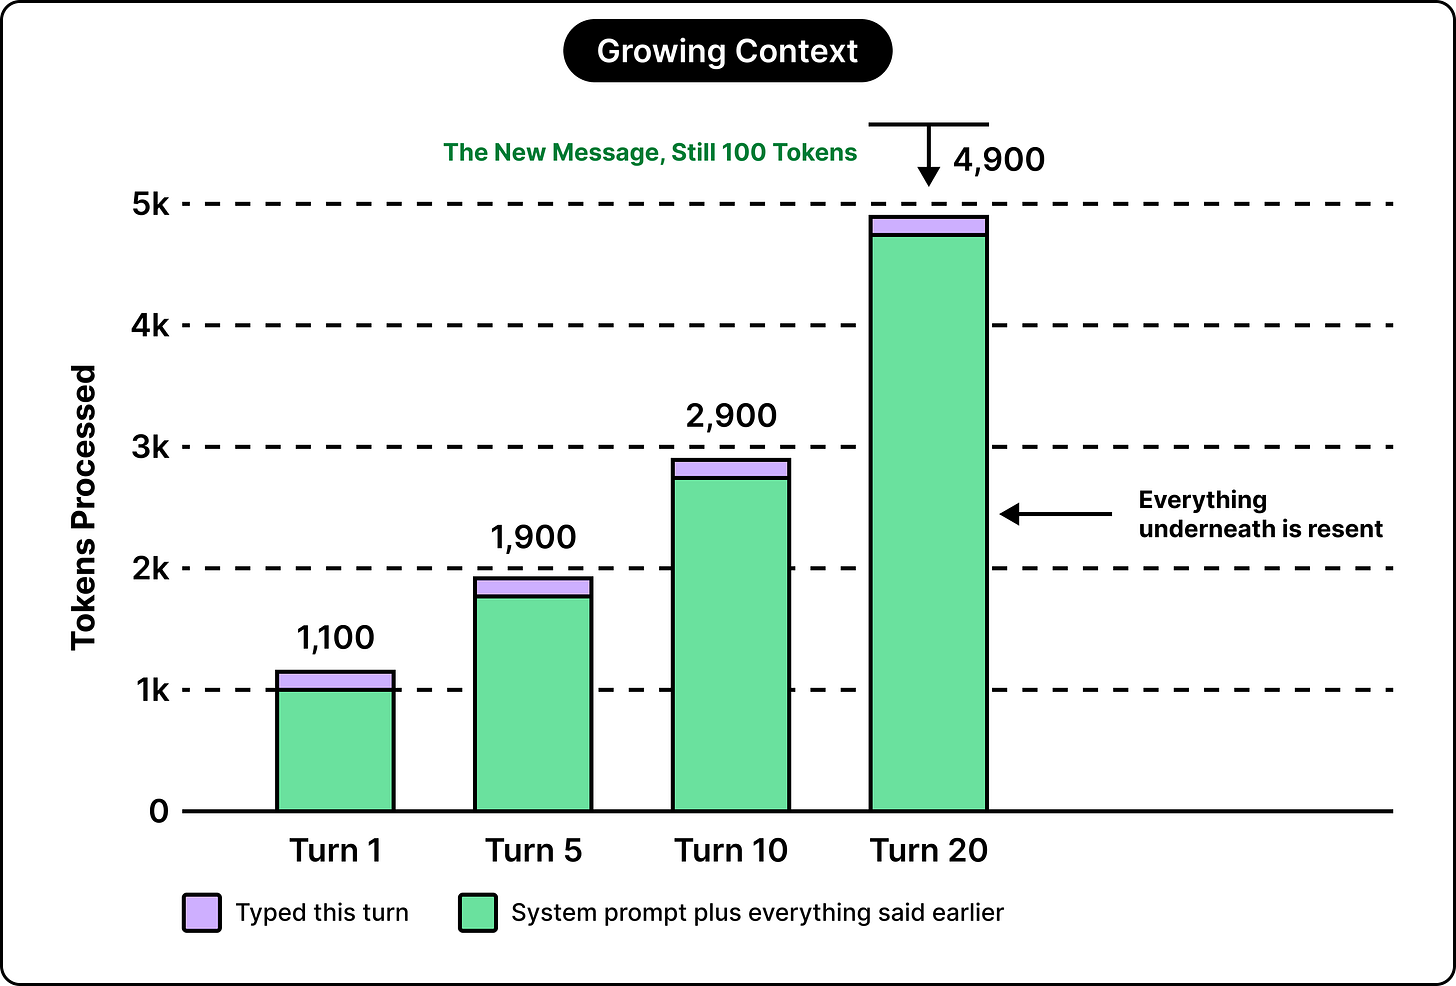
AI聊天机器人从按下回车到输出首个词之间,经历约十几个阶段:组装包含系统提示、工具定义、记忆和对话历史的文档,进行输入安全检查,将文本分词,排队与其他请求共享硬件,然后分预填充和解码两阶段生成。长对话因重新处理全部历史而变慢变贵,缓存和流式技术优化了性能,工具调用则形成循环。
在静态网站前添加CDN缓存后,网站反而变慢,慢页面从38个增至75个。原因是缓存未命中时CDN处理更耗时,且爬虫总是冷请求,命中率极低。计算发现需67%命中率才能持平,但实际接近零。建议部署前先计算盈亏平衡命中率,并诚实评估真实命中率。
完成下面两步后,将自动完成登录并继续当前操作。