文章以小螃蟹与机器人的对话为引,区分AI的“知识”与“记忆”:知识来自训练参数或检索资料,用于回答规则与事实;记忆则是应用层保存的任务状态与历史。短期记忆依赖当前上下文,长期记忆需经提取、保存、再读取。模型参数不等于个人记忆,普通对话不会自动修改参数。若记错,需更新状态、保留来源并允许纠正。
本文介绍 Koog 1.3 的知识增强设施:Embeddings 模块通过 LLMEmbedder 生成向量,但 DeepSeek 客户端不支持嵌入,需搭配 Ollama 或云端服务;rag-base 定义存储抽象,rag-vector 提供文档向量化与检索原型,仅适合本地测试;检索可作为工具供 agent 按需调用,实现 agentic RAG;LongTermMemory 将检索与入库功能化,支持自动或手动模式,需注意分桶、去重与持久化限制;生产环境应基于 rag-base 自研向量库适配器。
Databricks研究扫描npm恶意包,发现3.8%捆绑二进制文件,此类包比纯源码包更难被LLM识别,失败率为14.4%对6.2%。测试九个模型发现四种系统性失败模式:合理化、忽视、含糊和虚构。引入能力配置文件注入领域知识后,检测失败率从50%降至4%,消除所有误判为良性的结果,使廉价模型达到昂贵模型的检测精度。
知识库正在把企业的知识管理变成一场昂贵的文件搬家! 企业从几个人扩张到几十人,沟通开始变慢,经验开始丢失,管理者便会想到知识库、企业维基和人工智能(AI),但文件越来越齐全,员工却未必越来越懂业务,真正决定企业能否传承经验的,往往是评
WorkSwarm推出个人知识空间,可自动采集本地文件夹、知乎、飞书、GitHub等来源资料,整理为有目录、有出处的知识库,供智能体渐进式读取,实现一次采集、反复使用,减少重复查找和token消耗,提升任务准确率。测试显示,启用后任务耗时与token消耗均明显下降。
本文提出基于AWS托管服务的GraphRAG汽车售后知识助手方案,融合知识图谱与向量检索,解决维修手册多语言、多模态、难关联查询等痛点。方案涵盖文档解析、实体抽取、混合检索与可溯源问答,可缩短手册启用周期、降低技师依赖,并可推广至其他知识密集型领域。
本文总结后端数据库知识,涵盖MySQL基础(SQL分类、DDL/DML/DQL、约束、连接)、JDBC原理与核心类、预编译、DAO模式、事务ACID与隔离级别、连接池、JNDI、ThreadLocal,以及MongoDB安装与使用;性能优化部分介绍三范式、索引、分表、读写分离、SQL优化及索引失效场景。
本文介绍Linux基础知识:对比Linux与Windows差异,讲解分区、挂载及常见目录;列举ls、cd、rm、cp、find、grep、tar等常用命令;说明vi的三种模式及操作;并给出简单Shell脚本示例,强调多动手实践。
文章系统梳理网络知识:DNS负责域名与IP解析;HTTP为无状态协议,涵盖请求方法、报文、状态码及1.1与1.0差异;Cookie存于客户端,Session存于服务器;HTTPS通过SSL实现加密与认证;TCP包括三次握手、四次挥手、流量控制与拥塞控制;IP负责寻址与路由;TCP/IP采用分层封装;并介绍XSS、SQL注入、CSRF等Web攻击及IGMP、ICMP、ARP协议。
A24宣布制作SCP基金会电影,但未联系SCP Wiki团队,也未承诺按知识共享许可发布,引发恐怖社区不满。Neon随后宣布将制作自己的SCP电影,主动联系Wiki团队,并承诺以CC BY-SA许可发行。该片并非官方作品,Wiki团队未参与制作也不获报酬,仅对Neon的沟通与合规表示赞赏。影片细节极少,预计2027年上映。
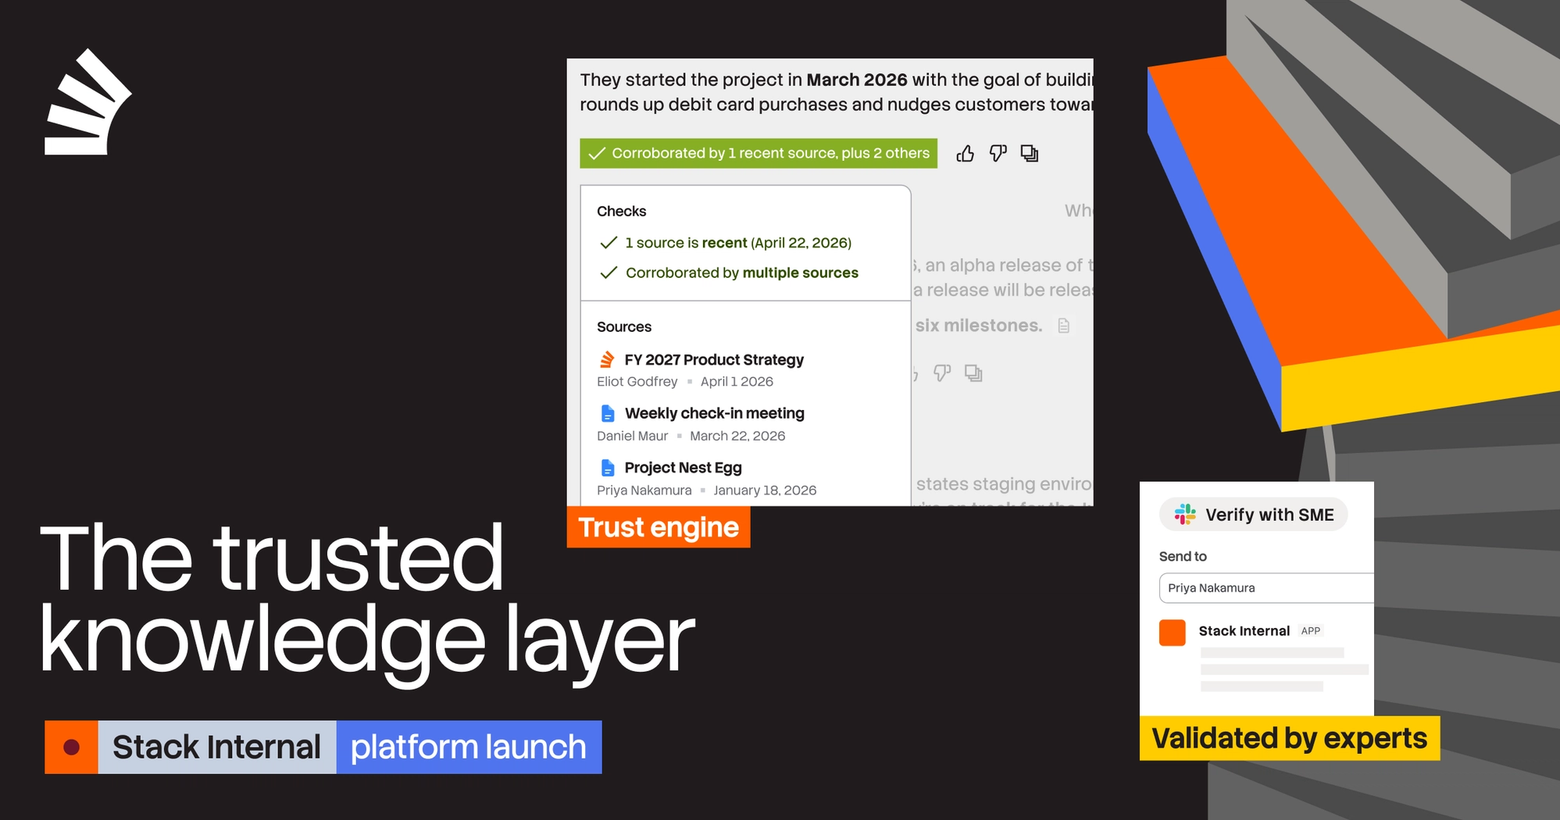
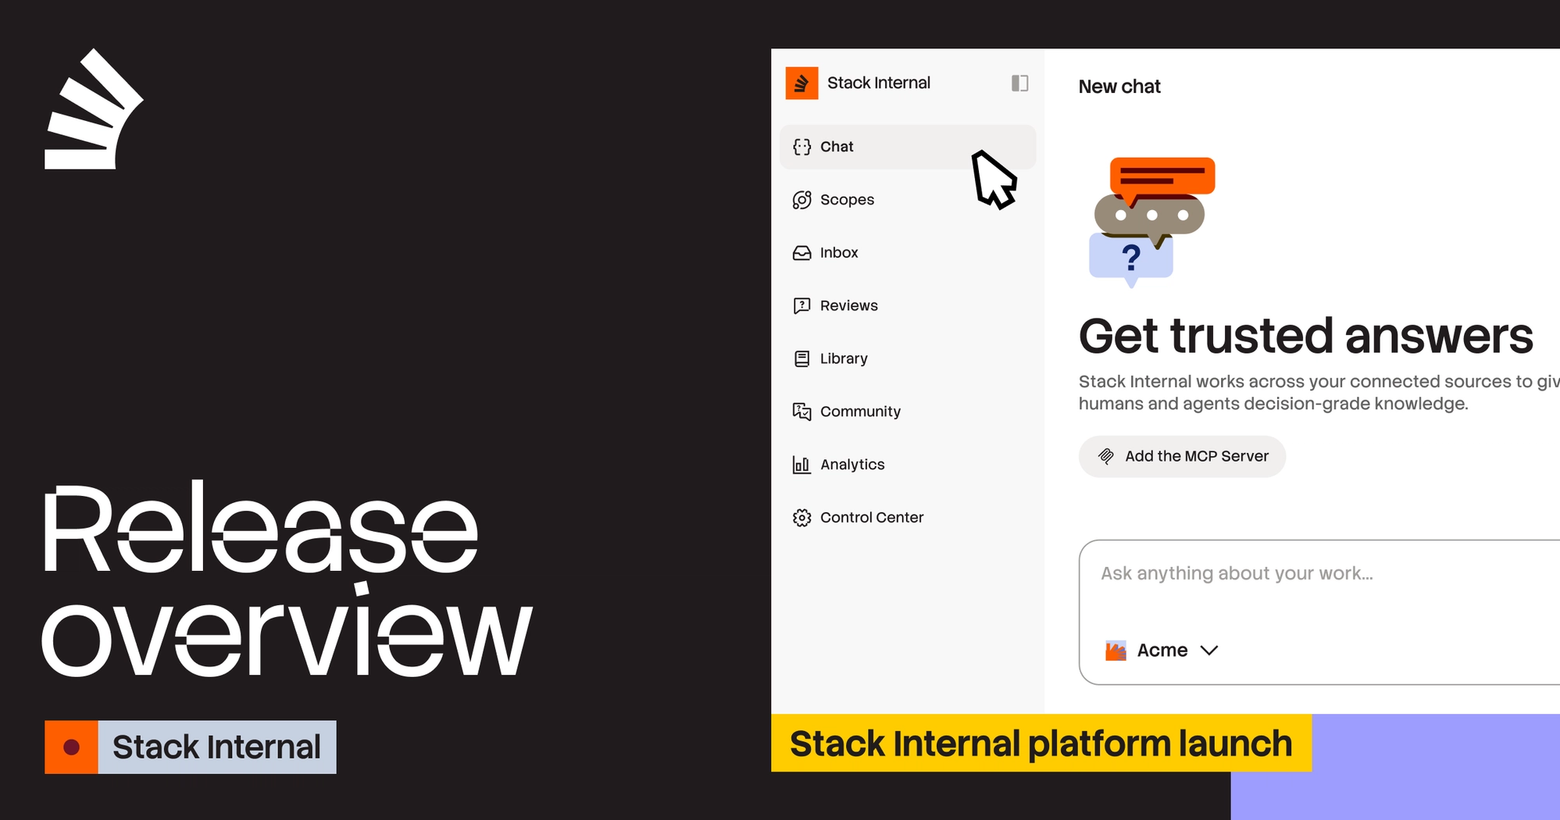
Stack Overflow 推出 Stack Internal 平台,旨在解决 AI 检索信息后仍难形成可靠决策的问题。文章提出“决策级知识”需具备来源、适用条件、权限、分歧提示和人工裁决五要素。AI 可快速检索比对,但专家应在关键分歧时介入验证,并将结论沉淀为可复用、可修正的知识,供聊天、API 和 MCP 调用。
Stack Internal 正式发布,支持免费创建 Starter 工作区,可连接三个数据源并协作。新增 Microsoft Teams 连接器,Slack 和 Google Docs 支持权限控制,并提供通用摄取 API。系统依据来源、时效、专家验证等信号评估知识,自动标记冲突、检测领域专家并触发 Slack 验证流程。MCP 服务器可将可信知识推送到 Claude、Cursor 等工具。企业版新增自定义角色、审计日志和知识健康仪表盘。
H.A.N. 是一款本地优先的 Markdown 笔记本,通过 WebRTC 点对点同步,无需账号、云存储和服务器费用。它利用 URL 哈希片段传递密钥实现零知识加密,以 16KB 分片和背压控制解决传输限制,并通过清单比对、墓碑和冲突分叉处理同步冲突。信令由 Cloudflare Workers 短暂中转,连接后即断开,实现端到端加密与零基础设施成本。
作者利用抖音官方推荐系统资料,通过免费AI工具制作行业大会风格的录播视频,零成本分享知识。他反思AI时代博客价值,认为“活人感”稀缺,决定继续写作但减少说教,侧重表达个人想法。未来计划建立个人档案,并尝试将虚拟人做成IP,用于科普分享。
AI正在改变漏洞管理方式,但仅按严重性评分修复并不足够。文章强调应从传统漏洞修补转向暴露管理,结合代码可达性、依赖树和SBOM等上下文评估真实风险。开发者需审计传递依赖、检查代码路径、生成SBOM,并采用补偿控制和最小权限原则,优先处理实际可利用的漏洞。
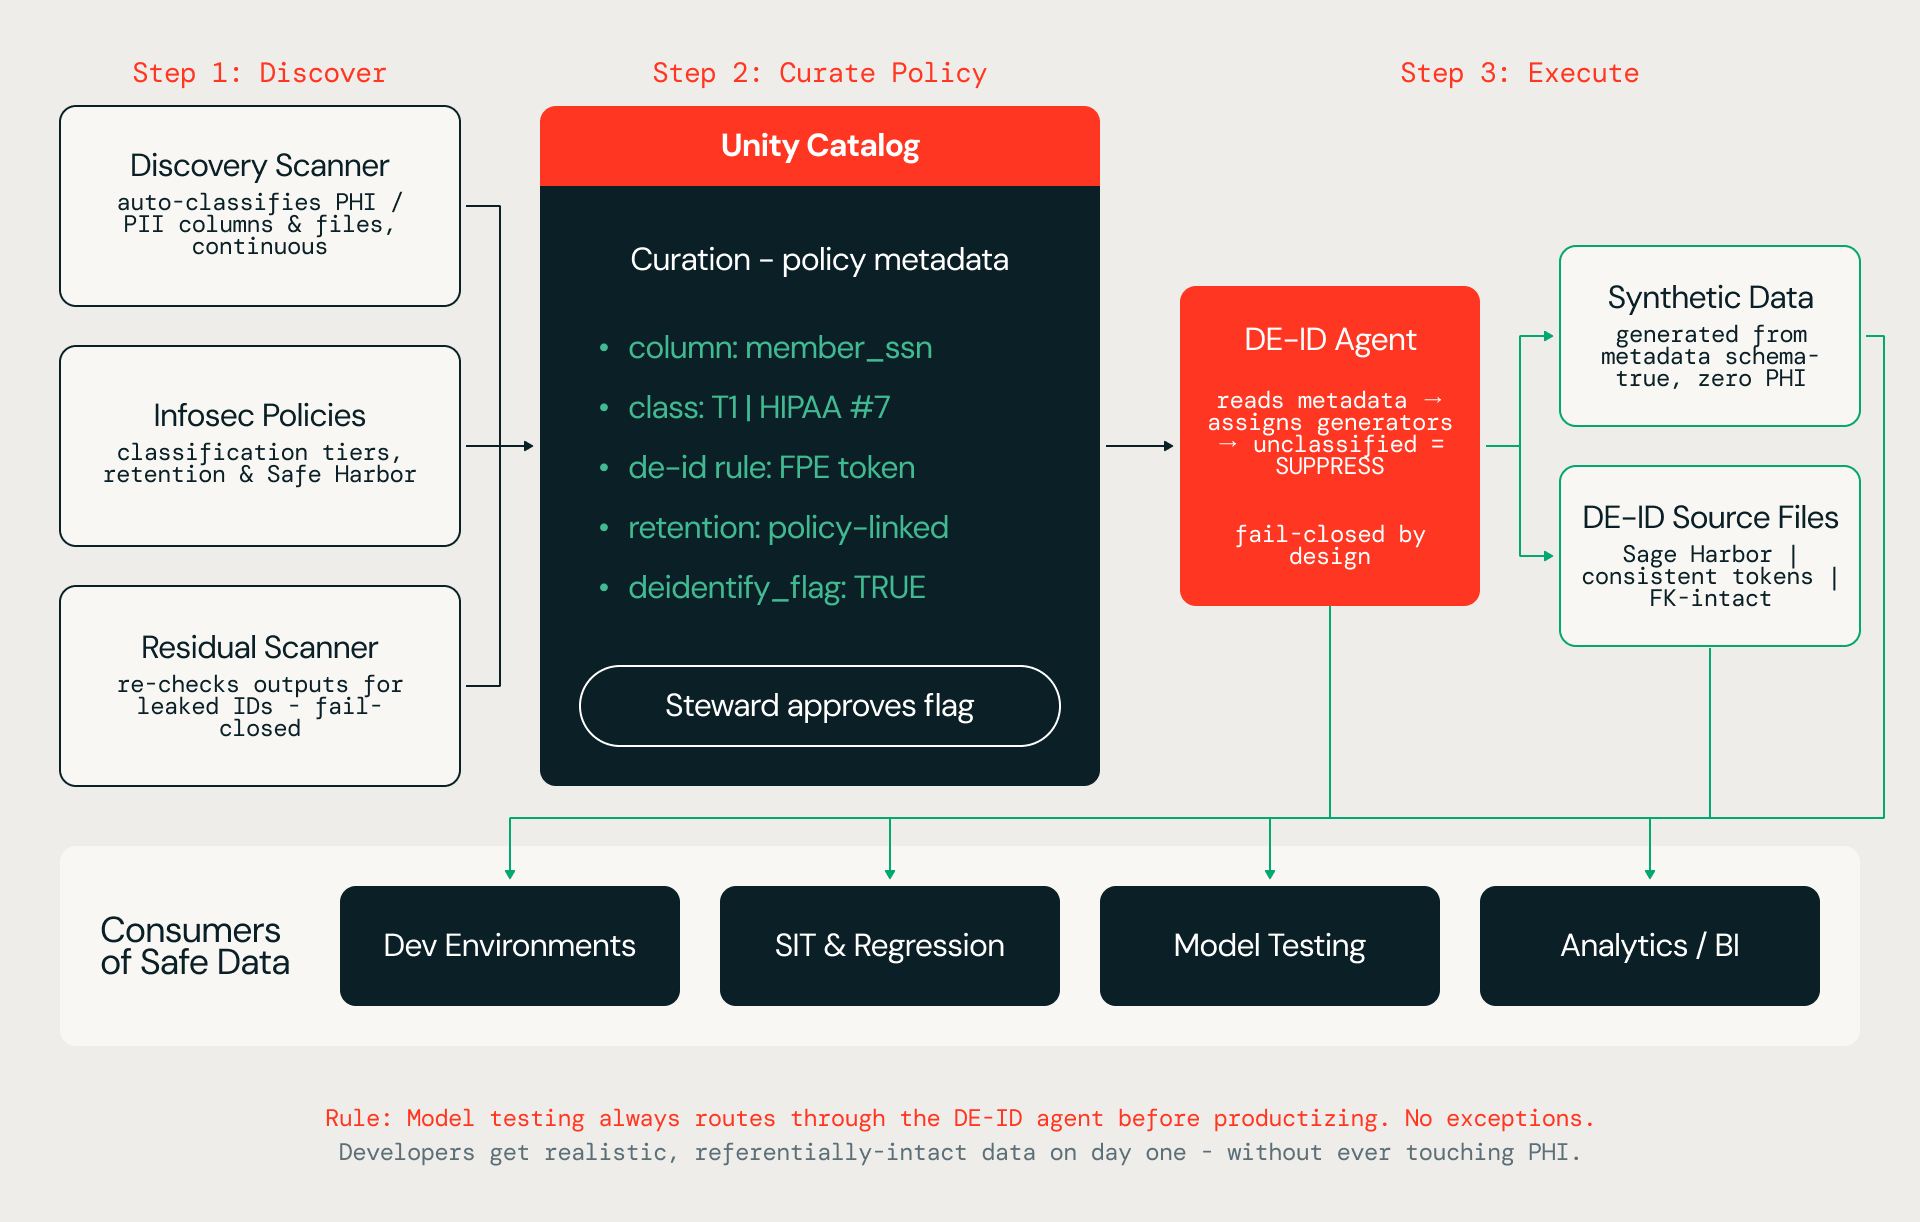
本文探讨数据治理如何支撑AI战略,强调治理工件(如分类标签、数据契约)应作为语义基础而非合规负担。通过五支柱框架和代理自动化,治理能提升AI准确性、降低成本并增强信任。文章主张安全与治理结合以实现可问责的AI部署,建议从小范围试点逐步扩展。
在今年的科隆前夕,钻石猫工作室公开了他们的第一部作品《伊始之猫》。前段时间,我们参加了B站主办的“游先看”活动。在活动现场,钻石猫工作室为我们介绍了《伊始之猫》的设计初衷以及项目由来。作为去年10月才刚刚成立的新公司,钻石猫工作室如果只算研发的话,团队内部只有6名成员。尽管这其中大部分员工此前的工作经历都是二游开发,但大家想在《伊始之猫》里尝试的玩法,是极其考验团队能力的动作战斗+知识锁“脑...
产品数据记录应用或网站内的用户行为、系统性能及业务指标,帮助团队以事实替代猜测做决策。应尽早开始追踪,并持续维护事件命名与参数,避免收集无法行动或含个人隐私的数据。数据需安全处理,定期审计,以支持产品优化和业务增长。
少数派整理了一系列围绕开学季的内容与资源,包括信息检索技巧、文献整理方法、笔记方法等,为读者的论文写作和学术生活提供帮助。文章还介绍了一些付费课程和工具供选择。
本文介绍LLM Wiki在企业合规知识问答中的实践,面临三道坎:并发编译导致38%页面重复,通过串行规划解决;目录摘要有损压缩导致查询遗漏,用BM25全文检索补充,命中率从70%提升至92.7%;人工修正被重编译覆盖,用语义pin保存修正意图。最终强调LLM Wiki适合少而精的知识,非RAG替代品。
完成下面两步后,将自动完成登录并继续当前操作。