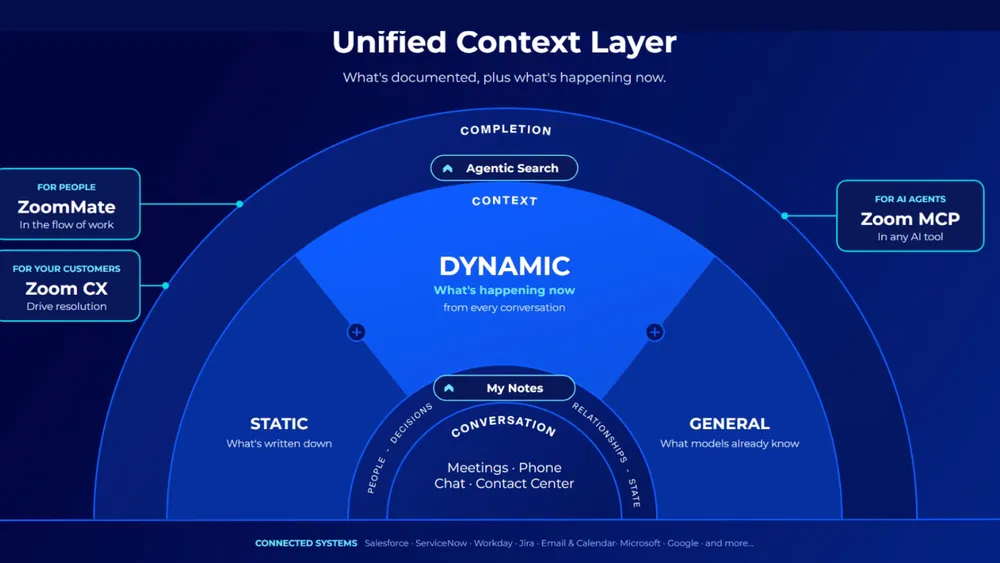
Zoom在Zoomtopia 2026发布统一上下文层,可捕捉会议、通话、聊天等对话中的隐性信息,构建动态知识图谱,供智能搜索与AI代理使用。该层整合第一方数据及Salesforce等第三方系统。Zoom同时推出客户档案,融合对话、CRM与案例数据,实现个性化服务,并强调不取代CRM而是扩展。Source Hub将于2027年初上线,初期支持Salesforce。
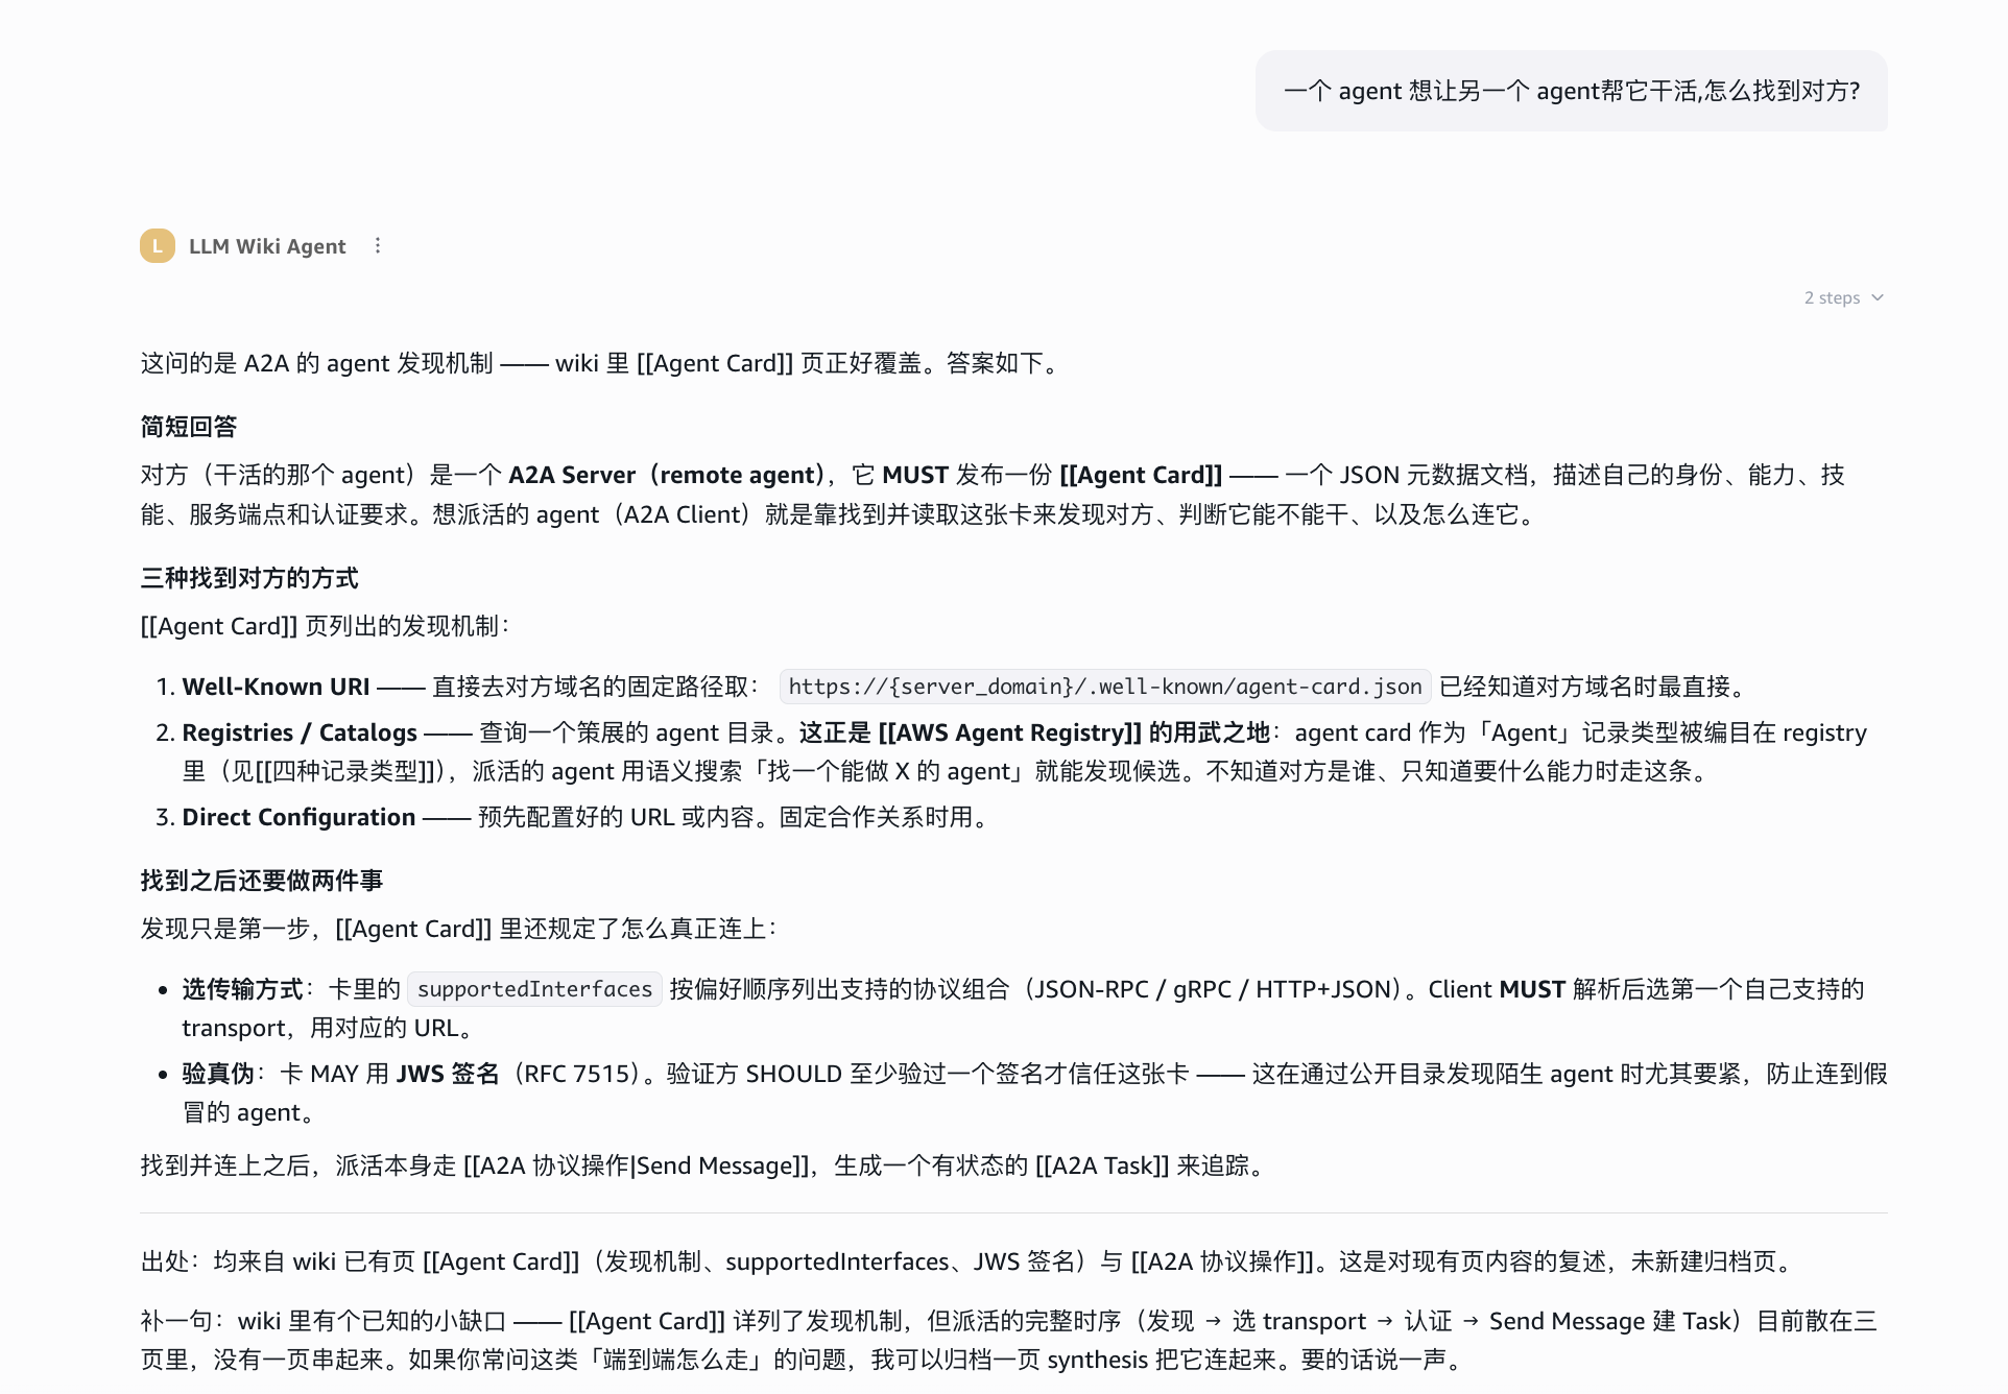
本文介绍在 Amazon Quick 桌面端落地 Karpathy 的 LLM Wiki 范式:先编译后查询,让知识沉淀。方案分三层——原始资料、LLM 拥有的 wiki、人机共写的 schema,并实现 Ingest、Query、Lint 三个操作。借助 Quick 内置索引、知识图谱与 wiki-inspect MCP,无需自建向量库,即可自动检索、抽取实体并定时体检。
本文提出基于AWS托管服务的GraphRAG汽车售后知识助手方案,融合知识图谱与向量检索,解决维修手册多语言、多模态、难关联查询等痛点。方案涵盖文档解析、实体抽取、混合检索与可溯源问答,可缩短手册启用周期、降低技师依赖,并可推广至其他知识密集型领域。
基于证据路由的 、AI 知识图谱驱动的、衰老与长寿机制的系统级剖析发现:TP53、mTOR 和 SIRT1 是连接衰老和长寿种子集的排名靠前的桥梁候选基因。 衰老和长寿研究正在积累海量数据,基因、蛋白质、代谢物和药物之间的关系越来越复杂。浙江大学团队于2026年推出的 HALDxAI,试图把分散的研究连接成可追踪证据的知识网络。它整合了44万余条
向量检索擅长按语义找相似文本,但无法证明事实关联。当答案依赖多跳关系(如漏洞库→服务→客户→合同→通知政策)时,应引入Graph RAG:将业务记录建模为节点和有向边,显式记录USES、SUPPORTS、GOVERNED_BY等关系。图回答“什么相连”,原文回答“政策怎么说”,二者缺一不可。遍历需限制边类型、跳数、租户边界与时效,缺失边应如实报告而非推断。
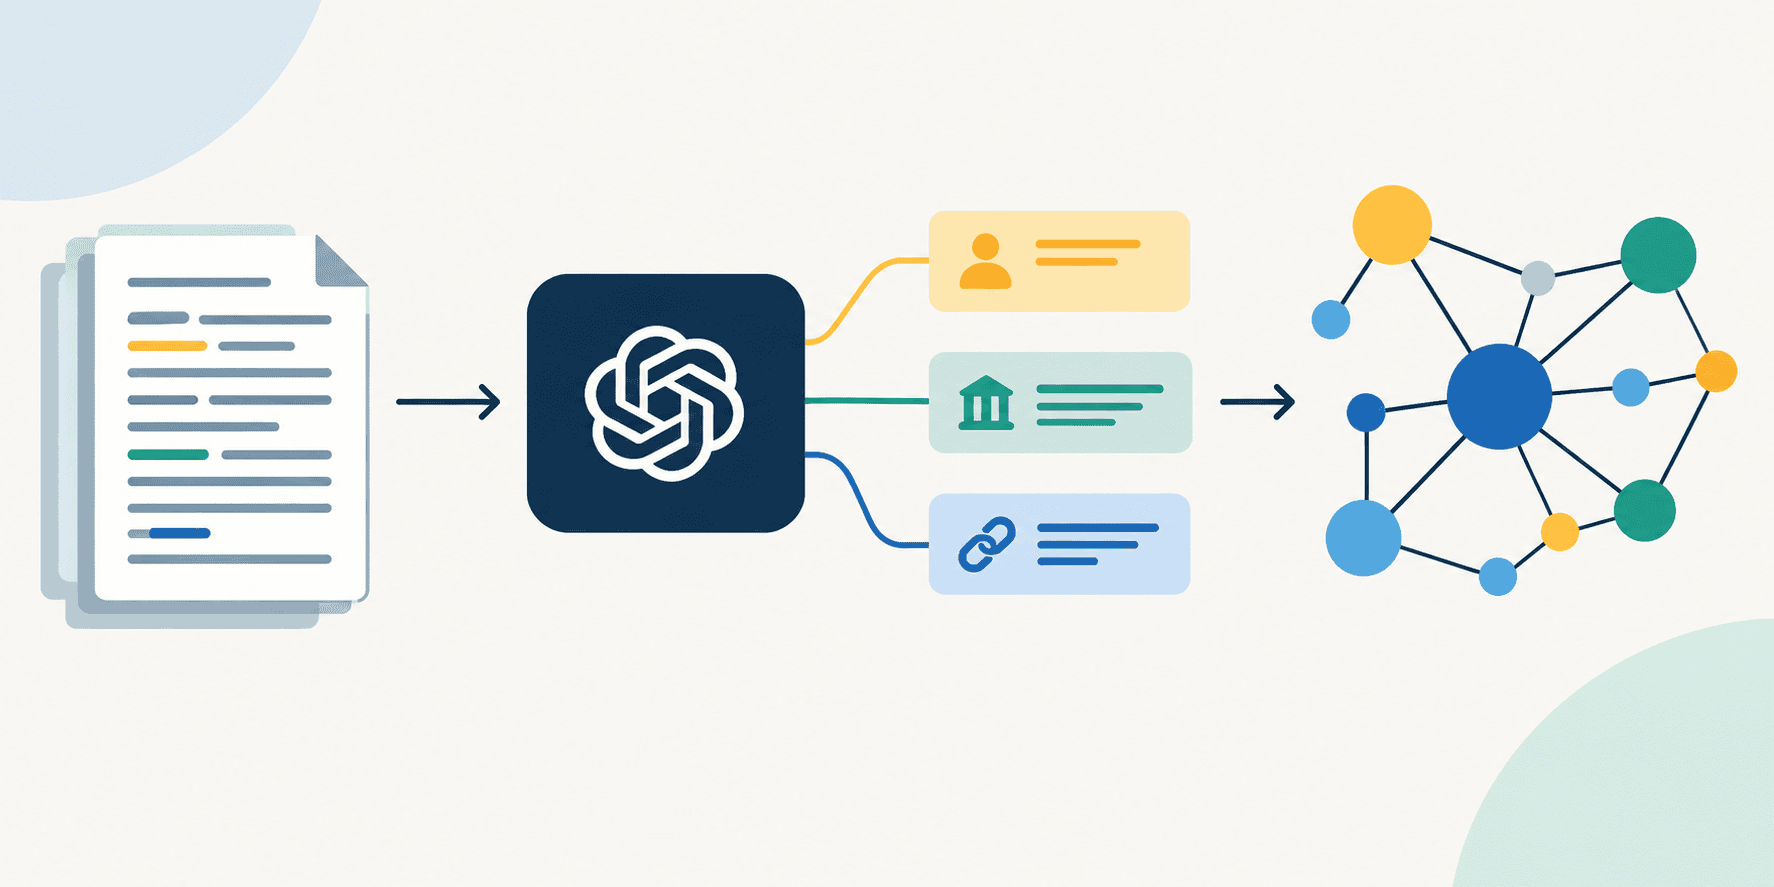
本文介绍用本地LLM从非结构化文本自动抽取知识图谱:通过Ollama运行Llama 3.2,采用少样本提示和JSON输出模式,将维基百科文本转为SPOC四元组(主语、谓语、宾语、上下文),并载入QuadStore图数据库,供Graph-RAG检索,以减少幻觉。
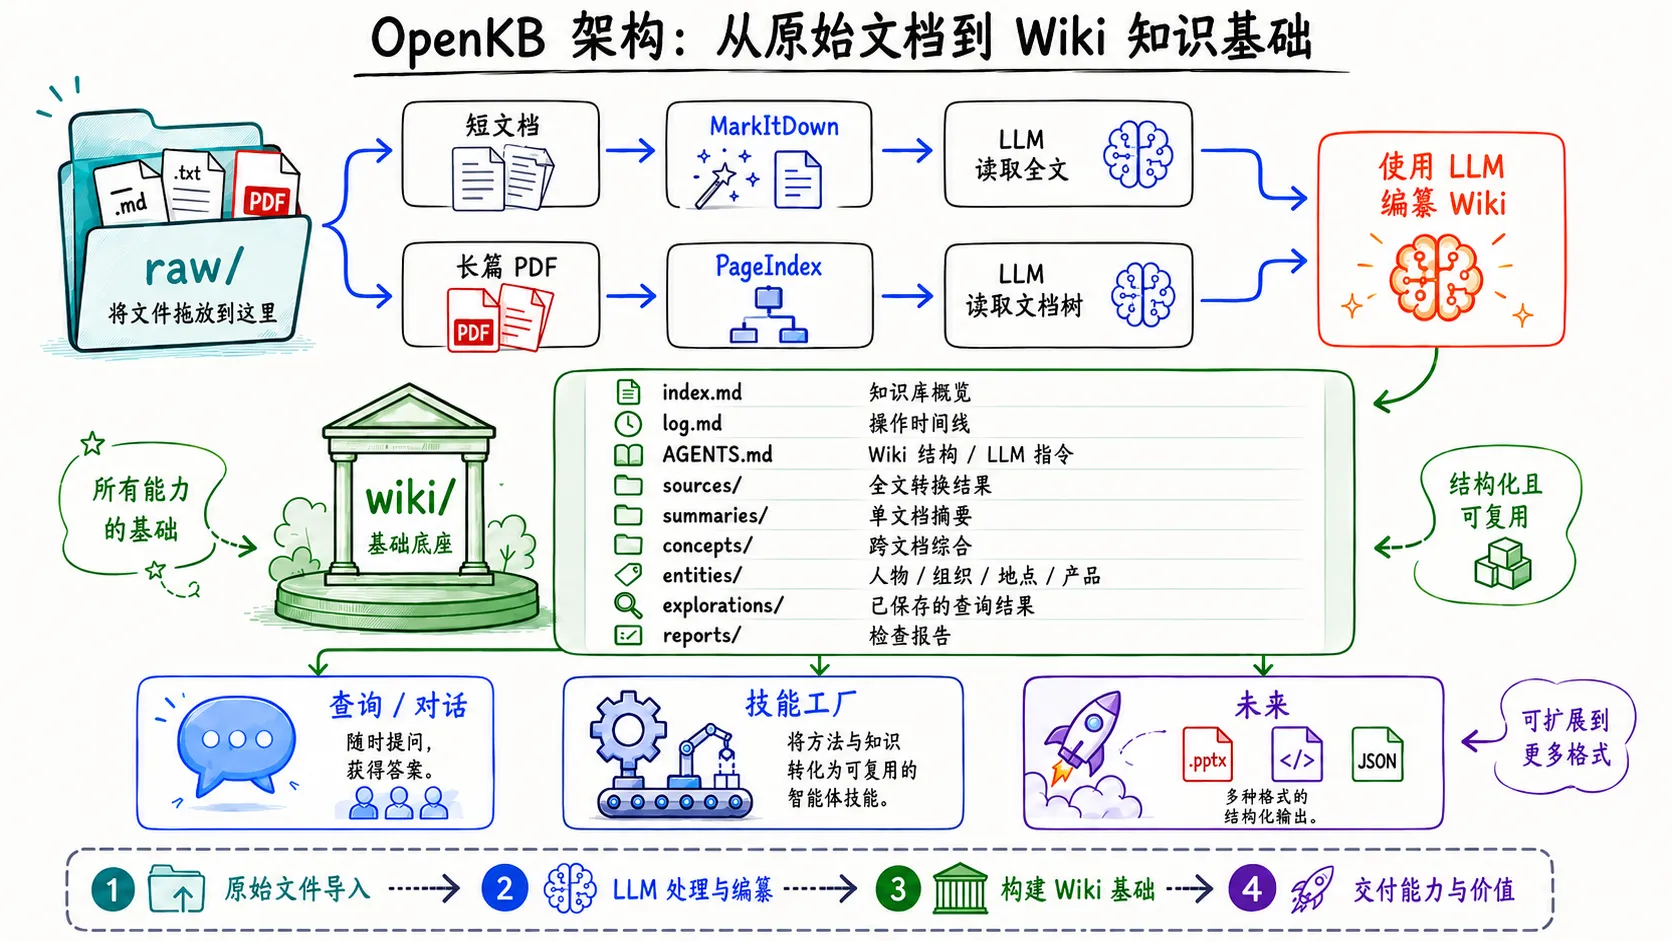
LLM-WIKI 是 Karpathy 提出的理念:让大模型将阅读、理解、问答持续沉淀为持久、互链、带引用的 Markdown 知识库,实现知识复利。OpenKB 是其开源实现。结合 scys-mcp 采集生财有术精华帖等数据,用 AI Agent 驱动 OpenKB 编译入库,可构建知识图谱与问答系统,并定期 lint 维护。
联合国与谷歌上线UN System Data Commons,通过知识图谱连接分散的统计数据,并支持Agent经MCP取数。其关键价值是保留来源元数据,使每个数字可追溯机构、年份与统计口径。文章提醒避免混淆变量与来源,应保存查询参数和facet,先固定问题再生成结论,不可直接比较不同口径数据。
联合国推出基于谷歌Data Commons的开源平台“UN System Data Commons”,将各机构分散的全球统计数据整合为AI就绪知识图谱,支持自然语言查询和AI助手自动生成图表报告,数据经联合国专家验证,目标2027年覆盖80%数据集。
Harness 现场 CTO 指出,AI 编码工具使代码审查成为瓶颈,测试团队难以应对激增的拉取请求。为此,Harness 推出重建的代码仓库和 AI 代码审查产品,利用知识图谱提供上下文,优先展示关键变更,并强调保留确定性工具,以缓解审查压力。
企业AI中,单纯RAG系统存在查询歧义、检索遗漏和无法表达不确定性等问题。解决方案分三代演进:混合检索结合向量与关键词搜索;知识图谱增强实体关联;代理式AI实现动态推理、安全边界、消歧、并行检索和保守置信度评分。核心原则是确定性优先、低延迟、强制置信度评估和隐私硬约束,未来趋势是多代理编排。
涛思数据发布TDengine IDMP 2.0.1.0版本,新增文档知识库图谱与数据预测触发器。系统自动提取实体关系生成中英双语图谱,使企业知识从“可搜索”走向“可理解”;预测触发器可提前识别趋势异常,实现实时监控“向前看”。此外,还优化邮件服务、数据迁移及性能。
研究探讨模型升级对Agent记忆迁移的影响。固定schema的知识图谱迁移几乎无损,而自然语言笔记与模型强耦合,精度波动大。记忆持久性取决于表示格式。RAG损耗源于embedding版本,修复记忆库不如重写。结论基于小模型和合成数据,需谨慎推广。
实体驱动型SEO通过识别核心实体、构建主题集群、优化内部链接和结构化标记,取代传统关键词优化。它利用知识图谱关联推理,让页面获得未明确关键词的排名。实施分五步:识别实体、建集群、布线链接、加Schema标注、验证迭代,并强调一致性、避免误区,以提升AI搜索曝光。
标准RAG仅靠文本分块和向量搜索,无法处理多跳问题或全局总结。GraphRAG通过构建知识图谱,提取实体和关系,结合向量检索与图遍历,实现结构化推理。本文介绍用Python和Neo4j实现GraphRAG,包括定义模式、构建管道和查询,虽成本高但能提升企业AI的推理能力。
本文介绍如何用Python和Neo4j构建知识图谱,涵盖建模、数据加载与查询优化。核心在于利用图数据库的索引无关邻接实现高效多跳查询,优于SQL的多次连接。内容包括节点/关系建模原则、UNWIND批量加载、索引与约束设置、查询计划分析,以及结合向量搜索构建AI知识图谱的方法,并附完整可运行脚本。
作者介绍了其个人知识图谱实验系统,用于追踪兴趣事件,并分享了当前生活状态:等待升职、NIW审批和肇事赔偿等结果,因九月是关键节点,感到无力与烦躁,甚至产生不切实际的想法寻求乐趣。
GraphRAG通过知识图谱和社区检测,弥补了标准RAG在全局查询上的不足。它构建实体关系图,生成分层社区报告,支持局部和全局搜索。尽管索引成本高,但提升了答案的全面性和多样性。LazyGraphRAG降低了成本,Agentic RAG则按需选择策略。
Semantica 是面向可审计AI的图原生基础设施,利用知识图谱记录决策因果链,支持溯源、推理和双时态快照。它无需LLM即可构建图,提供30多种数据源摄取、确定性推理及W3C PROV-O导出。尽管内存态存储和中文抽取存在局限,但为信贷、医疗等监管场景提供可靠审计账本。
本文介绍AI记忆管理方案,对比Hermes生态中Mnemosyne与Hindsight。Mnemosyne轻量本地运行,分层存储记忆,适合日常;Hindsight重型推理,构建知识图谱,适合复杂任务。两者均运行时注入、数据可迁移,选择取决于深度与成本权衡。
完成下面两步后,将自动完成登录并继续当前操作。