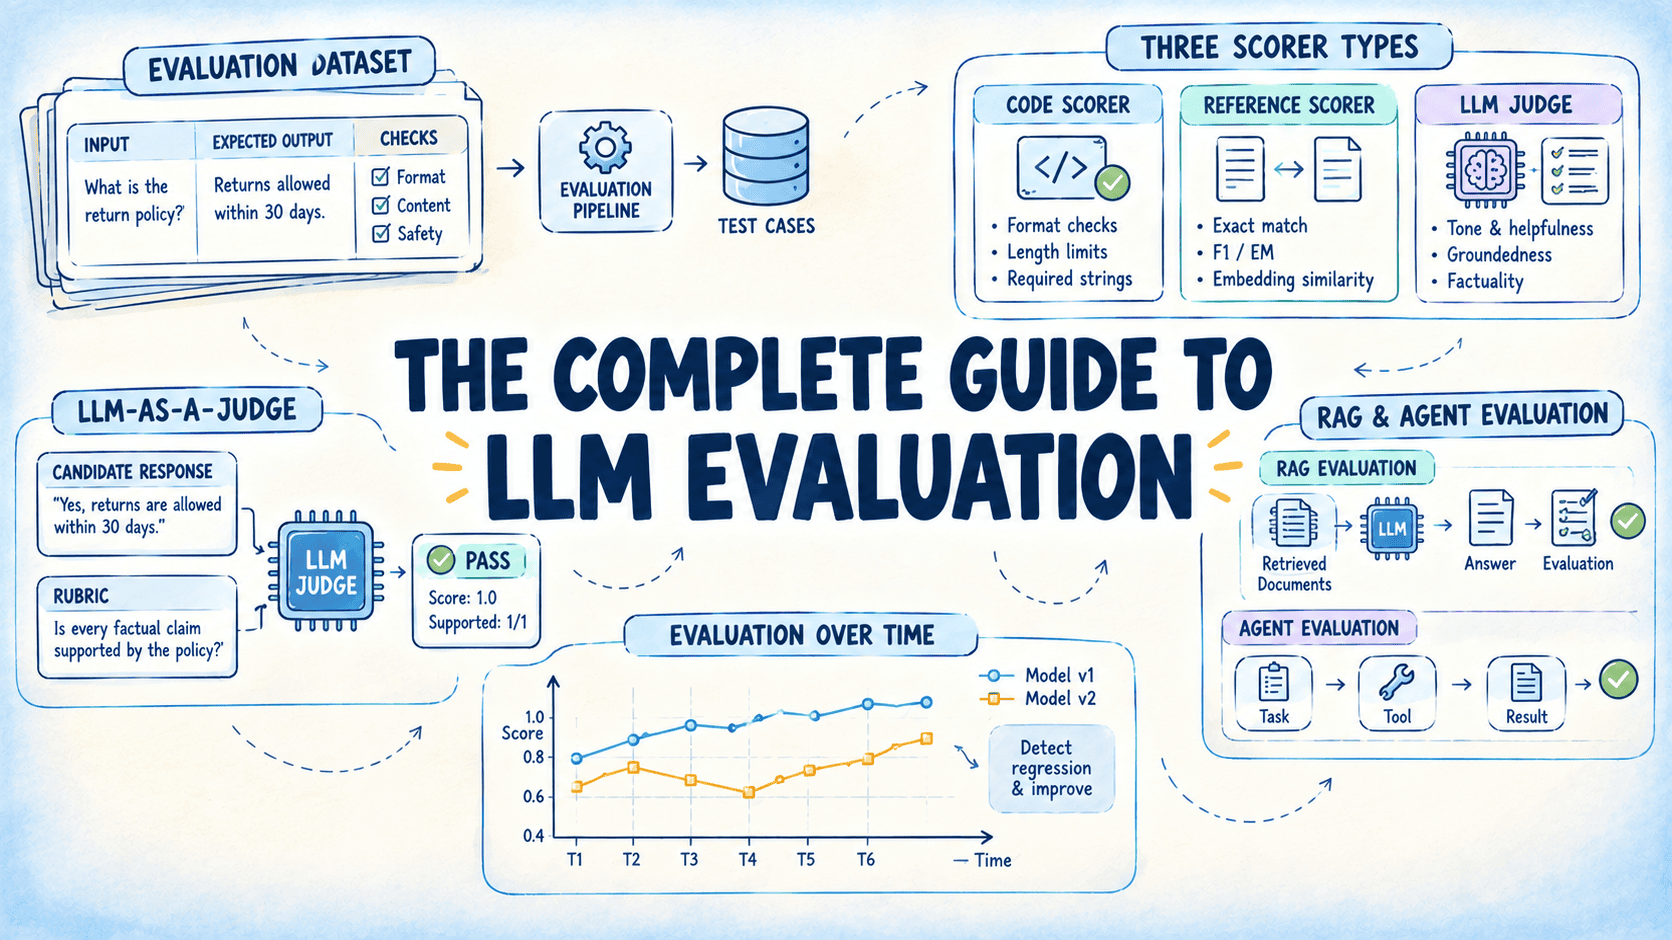
文章讨论LLM应用评估:评估用于迭代,测试用于发布把关。评分器分代码、参考答案和LLM裁判三类,能用规则就用代码。LLM裁判需明确评分标准、先推理后结论、温度设0;QAG把标准拆成是非题,G-Eval用概率加权打分,成对比较需交换顺序。裁判须用人工标签校准,以Cohen's kappa衡量。RAG应分别评估检索与生成;智能体先看任务完成,再诊断工具、参数和轨迹。发布前用25–50个版本化用例做离线评估,上线后抽样在线评估。
完成下面两步后,将自动完成登录并继续当前操作。