

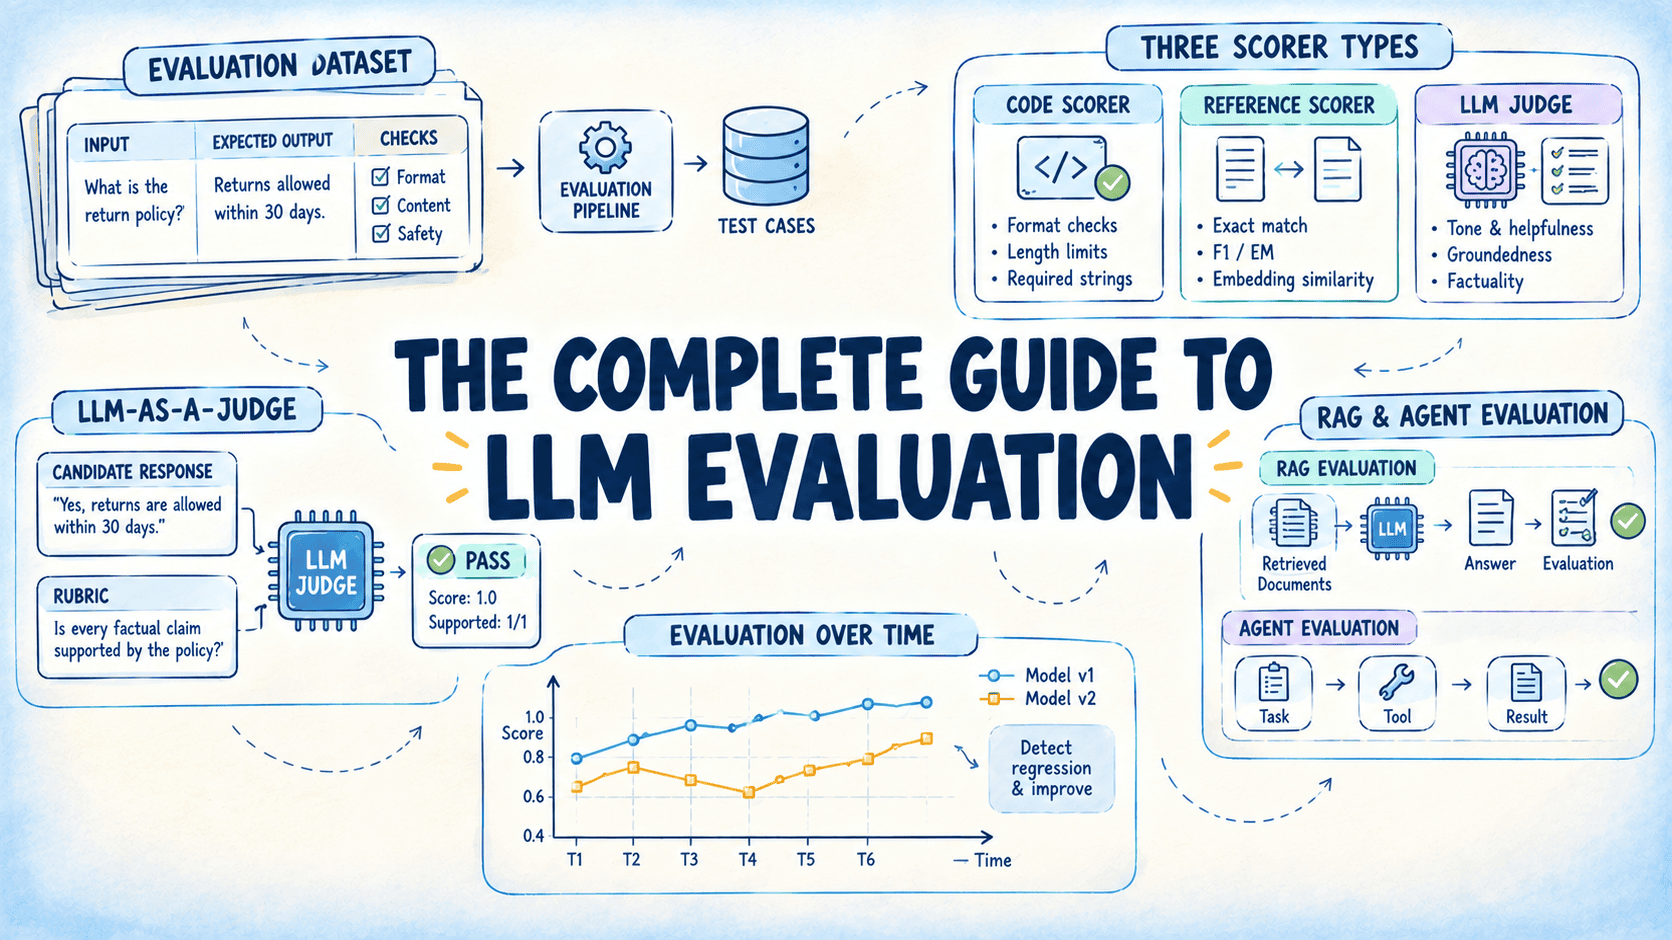

LLM评估完全指南
内容提要
文章讨论LLM应用评估:评估用于迭代,测试用于发布把关。评分器分代码、参考答案和LLM裁判三类,能用规则就用代码。LLM裁判需明确评分标准、先推理后结论、温度设0;QAG把标准拆成是非题,G-Eval用概率加权打分,成对比较需交换顺序。裁判须用人工标签校准,以Cohen's kappa衡量。RAG应分别评估检索与生成;智能体先看任务完成,再诊断工具、参数和轨迹。发布前用25–50个版本化用例做离线评估,上线后抽样在线评估。
延伸解读
评估与测试的分工:迭代用评估,发布用测试
文章明确区分评估与测试:评估衡量模糊标准下的相对质量,用于指导迭代;测试用二元检查(如JSON有效、禁用词不出现)为发布把关。若用忠实度0.7这样的阈值阻塞部署,每周都会陷入阈值争论。实际落地时,应把评估分数用于比较版本优劣,把测试作为发布前的硬性门槛,两者互补而非替代。
LLM裁判的可靠性:校准比提示词更重要
文章指出裁判存在位置、冗长和自我偏好等偏差,缓解手段包括交换顺序、禁止奖励长度、使用不同模型家族的裁判。但最关键的是用30–50条人工标签校准,并以Cohen's kappa衡量一致性,因为原始一致率在多数案例通过时会误导。kappa低于约0.6时,应阅读分歧、修改评分标准,并把标注集当作裁判本身的回归测试。
RAG与智能体:分组件评分才能定位故障
RAG的检索与生成会独立失败,文章建议分别评估上下文精确率、召回率、忠实度和答案相关性。高忠实度低召回说明检索不足,高精确率低忠实度则指向生成或提示问题。智能体应先看任务完成率,再用工具正确性、参数正确性和轨迹诊断失败原因。这种分组件方式让团队能判断是哪一环出了问题,而非只看到一个端到端分数。
发布前后的评估节奏:25–50个版本化用例
文章建议离线评估使用25–50个代表性用例,覆盖正常请求、边缘案例、对抗输入和应拒绝的离题问题,并与代码一起版本化。发布标准应提前写明:最低分数、相对当前生产版本的最大回退幅度、所有安全检查通过。上线后抽样在线流量,用无参考检查(忠实度、语气、格式)配合延迟和成本监控,以捕捉数据集未预见的输入和模型更新带来的质量漂移。
Q&A
LLM评估和传统测试有什么区别?为什么不能只靠抽查几个输出?
LLM输出每次运行都会变化,且“正确”取决于上下文,单元测试的相等断言无法判断语义等价。评估衡量模糊标准下的相对质量(如版本B是否比A好),测试用二元检查(如JSON有效、禁用词不出现)来把关发布。应使用评估指导迭代,用测试保护发布。
LLM裁判的评分标准(rubric)应该怎么写才可靠?
可用的裁判提示包含四部分:标准定义、裁判可用的输入、操作步骤、严格的输出格式。步骤中先列出事实主张再判断是否被支持,结论放在推理之后;输出用结构化JSON便于解析和记录推理;温度设为0减少采样噪声,对边界情况可运行奇数次取多数 verdict。
QAG和G-Eval分别适合什么场景?它们如何计算分数?
QAG适合可分解为可检查事实的标准:裁判回答是/否问题,代码计算支持主张数除以总主张数得到分数。G-Eval适合主观标准(如连贯性、有用性):先用Auto-CoT分解评估步骤,再读取分数token“1”到“5”的概率并计算概率加权期望值(如60/40分给4和5则得4.4),需要token对数概率,没有时可采样多次取平均。
如何校准LLM裁判并衡量它与人类判断的一致性?
人工标注30到50个输出,让裁判对同一组评分并比较。原始一致率在多数案例通过时会误导(如90%通过时总说PASS的裁判也有90%一致率),应使用Cohen's kappa校正偶然一致:0为随机水平,1为完美,约0.6以上通常视为实质性一致。kappa低时阅读分歧、修改rubric,并将标注集作为裁判的回归测试。
RAG系统应该怎么评估?检索和生成分别看哪些指标?
RAG的检索器和生成器会独立失败,应分开评分。检索看上下文精确率(相关块是否排前)和上下文召回率(是否找全答案所需内容);生成看忠实度(每个主张是否被检索上下文支持)和答案相关性(是否回答所问)。高忠实度低召回说明检索不足需修检索;高精确率低忠实度说明文档好但模型编造需改提示或模型。
智能体(Agent)评估应该先看什么?任务完成率下降时如何诊断?
先看任务完成:用户目标是否达成,流畅回复但未解决工单就是失败。完成率下降时用三个诊断分数定位原因:工具正确性(是否选对工具,通常与预期工具列表精确匹配)、参数正确性(参数是否格式良好且合理)、轨迹(路径是否合理,无冗余调用或循环)。多轮系统还需在对话线程层面给裁判完整历史并评分结果。
发布前后的LLM评估应该怎么运行?离线评估集要多大?
离线评估在发布前运行:从代表性查询构建25到50个用例,覆盖正常请求、边缘案例、对抗输入和应拒绝的离题问题,随代码版本化并随使用变化刷新;提前写发布标准(最低分数、相对当前生产版本的最大回归、所有安全检查通过),在每个PR上运行并报告改进与回归。在线评估在发布后抽样实时流量,用无参考检查(忠实度、语气、格式)并记录延迟和成本,将生产失败转化为黄金用例。
