


AI 训练与推理场景下 AWS 存储服务选型实践
内容提要
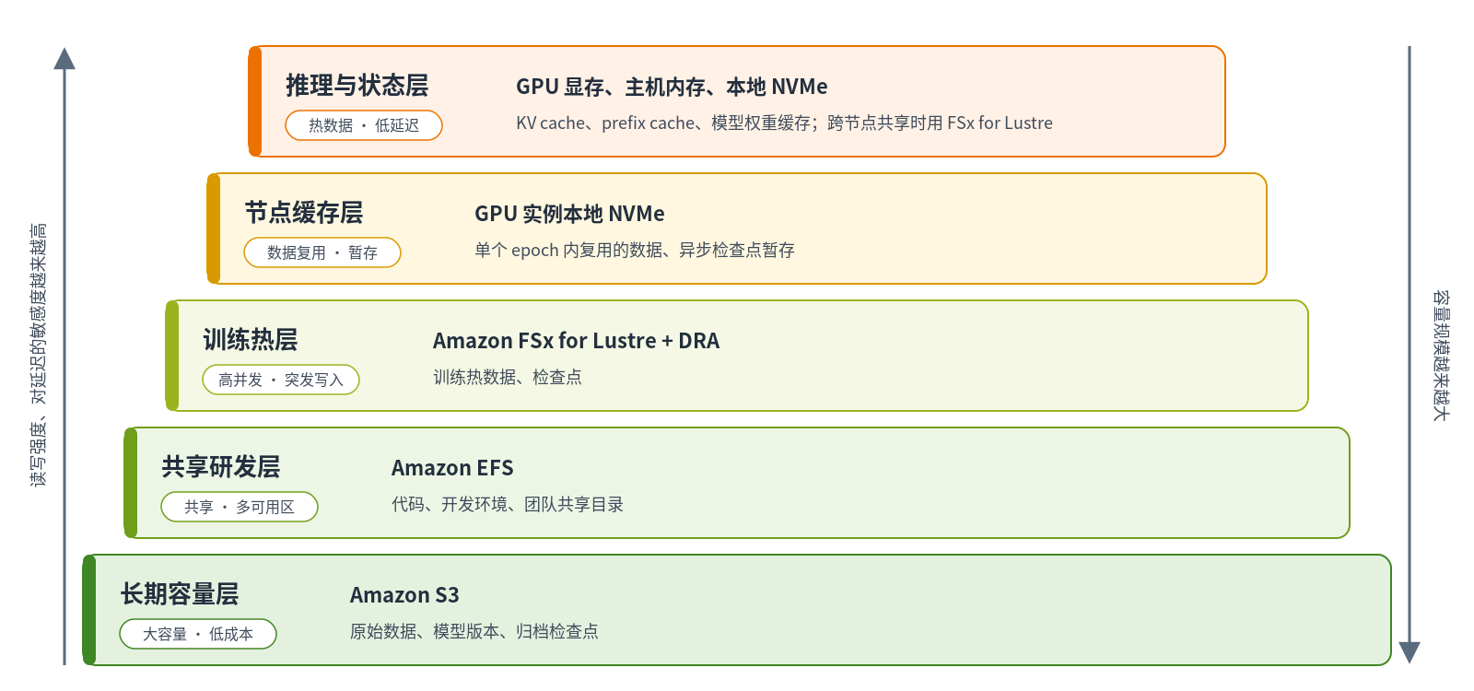
本文讨论AI训练与推理场景下的AWS存储选型,主张按数据访问特征分层:Amazon S3作为数据底座,存储原始数据、模型版本与归档检查点;FSx for Lustre作为训练热层,承担高并发读取与检查点突发写入,并通过DRA与S3同步;Amazon EFS作为共享研发层;本地NVMe承担节点缓存与推理KV cache。选型需综合考量性能、VPC IP消耗、成本、POSIX语义与配额管理,并按“先语义、再性能、最后成本运维”的顺序,用真实负载实测验证。
延伸解读
选型顺序:语义先行,避免性能误判
文章强调选型应遵循“先语义、再性能、最后成本运维”的顺序。因为 Mountpoint for Amazon S3 仅支持部分文件语义,若业务需要原地修改、追加写入或文件锁,它可能直接不适用,此时再比较带宽没有意义。先确认访问接口(对象 API、NFS 或完整 POSIX),能快速排除不兼容方案,避免在错误候选上浪费实测精力。
成本陷阱:EFS Elastic 按读写量计费
Amazon EFS Elastic 模式除存储费外,读取每 GB 收 $0.03、写入每 GB 收 $0.06。文章举例:100 TiB 数据每月读 10 遍,读取费会从 3,072 美元涨到 30,720 美元,与存储费相当;若每小时写一次 2 TB 检查点,月写入费约 86,400 美元。因此读写量大且稳定的负载更适合 Provisioned 模式,选型时不能只看每 GB 单价。
FSx for Lustre 的隐藏约束:IP 与配额
FSx for Lustre 的 VPC IP 消耗随容量和吞吐档位增长。文章估算,未启用 EFA 时 1,000 TiB 文件系统仅服务端就需约 443 个 IP,超过 /24 子网可用地址数,需提前规划更大子网。此外,账户级 Persistent 2 默认配额为 100,800 GiB,文中两个场景均超限,需提前申请提额。这些非性能因素容易在规模扩大后成为瓶颈。
分层组合可能比全量高性能存储更划算
文章在 S3 存储全量 100 TiB 的前提下对比:FSx for Lustre 用 125 档位存全量数据月成本 $17,268,而用 1000 档位只存 20% 热数据月成本 $15,264,后者便宜约 12%,基线吞吐却高约 67%。但该结论依赖热数据能被准确识别并放入 FSx,冷数据首次访问需经 DRA 从 S3 加载,会慢一些。
Q&A
AI训练和推理场景下,AWS的S3、EFS和FSx for Lustre分别适合放在哪一层?
文章建议分层使用:Amazon S3作为数据底座,存放原始数据、模型版本和归档检查点;FSx for Lustre作为训练热层,承担高并发读取和检查点突发写入,并通过DRA与S3同步;Amazon EFS作为共享研发层,存放代码、开发环境和团队共享目录;本地NVMe承担节点缓存和推理KV cache。
在AWS上做AI存储选型时,除了性能还要重点评估哪些维度?
除了IOPS、吞吐、延迟、成本和可用性这些基础性能指标,AI场景还需关注:数据形态(小文件还是大分片)、并发模型(聚合带宽与单客户端上限)、检查点突发写入的保存与恢复时间、与EKS的生态集成及VPC IP地址消耗、多租户配额管理能力,以及数据生命周期冷热分层。
为什么说AI训练场景下不能只看存储的峰值带宽来选型?
因为AI工作负载的I/O特征差异很大:小文件与深层目录先撞上元数据瓶颈,大分片并行读取要区分聚合带宽和单客户端带宽,检查点则是所有rank同时突发写入。同样是100 TiB数据,按不同I/O特征评估可能得出完全不同的选型结论,只比峰值带宽很容易选错。
FSx for Lustre和Amazon EFS在VPC IP地址消耗上有什么差别?
以100个GPU节点为例,Amazon EFS的IP消耗基本不随集群规模变化,约5个(挂载目标加控制器副本);而FSx for Lustre的IP消耗随容量和吞吐档位增长,未启用EFA时1,000 TiB仅服务端就需约443个IP,超过一个/24子网可用地址数,需提前规划更大子网。启用EFA可显著减少所需IP。
Amazon EFS的Elastic模式和Provisioned模式在成本上怎么选?
Elastic模式除存储费外,读取每GB收$0.03、写入每GB收$0.06,数据集每完整读一遍就多付一次读取费,读写量大且稳定的负载成本会很高;Provisioned模式按预置吞吐每MiB/s每月$6计费,适合持续读取量大的场景。例如持续读取1 MiB/s,Elastic模式每月读取费约$76,而Provisioned模式为$6。
用FSx for Lustre时,是存全量数据还是只存热数据更划算?
文章测算显示,在S3存全量的前提下,用高吞吐档位只存热数据往往更划算:热数据占20%时,用1000档位只存热数据比用125档位存全量便宜约12%,基线吞吐却高约67%。前提是热数据能被准确识别并放得进FSx for Lustre,冷数据首次访问需通过DRA从S3按需加载或提前预热。
多个团队共用训练平台时,FSx for Lustre和EFS在配额管理上有什么区别?
FSx for Lustre支持按用户、组和项目设置存储容量和文件数量配额,可设硬限制和带宽限期的软限制,配合root squash防止root绕过;Amazon EFS不支持用户、目录或项目级配额,只能通过访问点做目录级隔离,无法限制容量;Mountpoint for Amazon S3则依靠IAM和存储桶策略做访问控制,没有POSIX配额。
AI存储选型应该按什么顺序推进,最后如何验证?
建议按“先语义、再性能、最后看成本和运维”的顺序:先根据应用需要的对象API、NFS或完整POSIX语义排除不兼容方案;再统计文件数量与大小分布、目录深度、元数据操作次数和吞吐需求确定性能指标;然后分析数据生命周期;最后把容量、I/O、网络、运维等折算成每次训练任务成本。结论需用真实训练代码和数据格式实测验证,不能只用fio等基准工具。
