AI发展给数据中心存储架构带来挑战,传统数据湖难以支撑推理负载的持续并行访问。QLC NAND闪存凭借更高密度与能效,可支持256TB级SSD,降低占地与功耗。未来需采用分层存储,高性能层靠近计算,高容量QLC支撑数据湖,实现算力、内存与存储的均衡扩展。
Redis发布Search on Flex预览版,将搜索索引存于分层存储,仅热元数据保留在内存,内存占用约为纯内存索引的10%。查询、索引和客户端接口不变,配合QPF可扩展吞吐,目标为约10倍延迟、10%内存。适用于TB级RAG、欺诈筛查等场景,可替代独立搜索引擎,并支持在Flex与RAM间灵活调整。
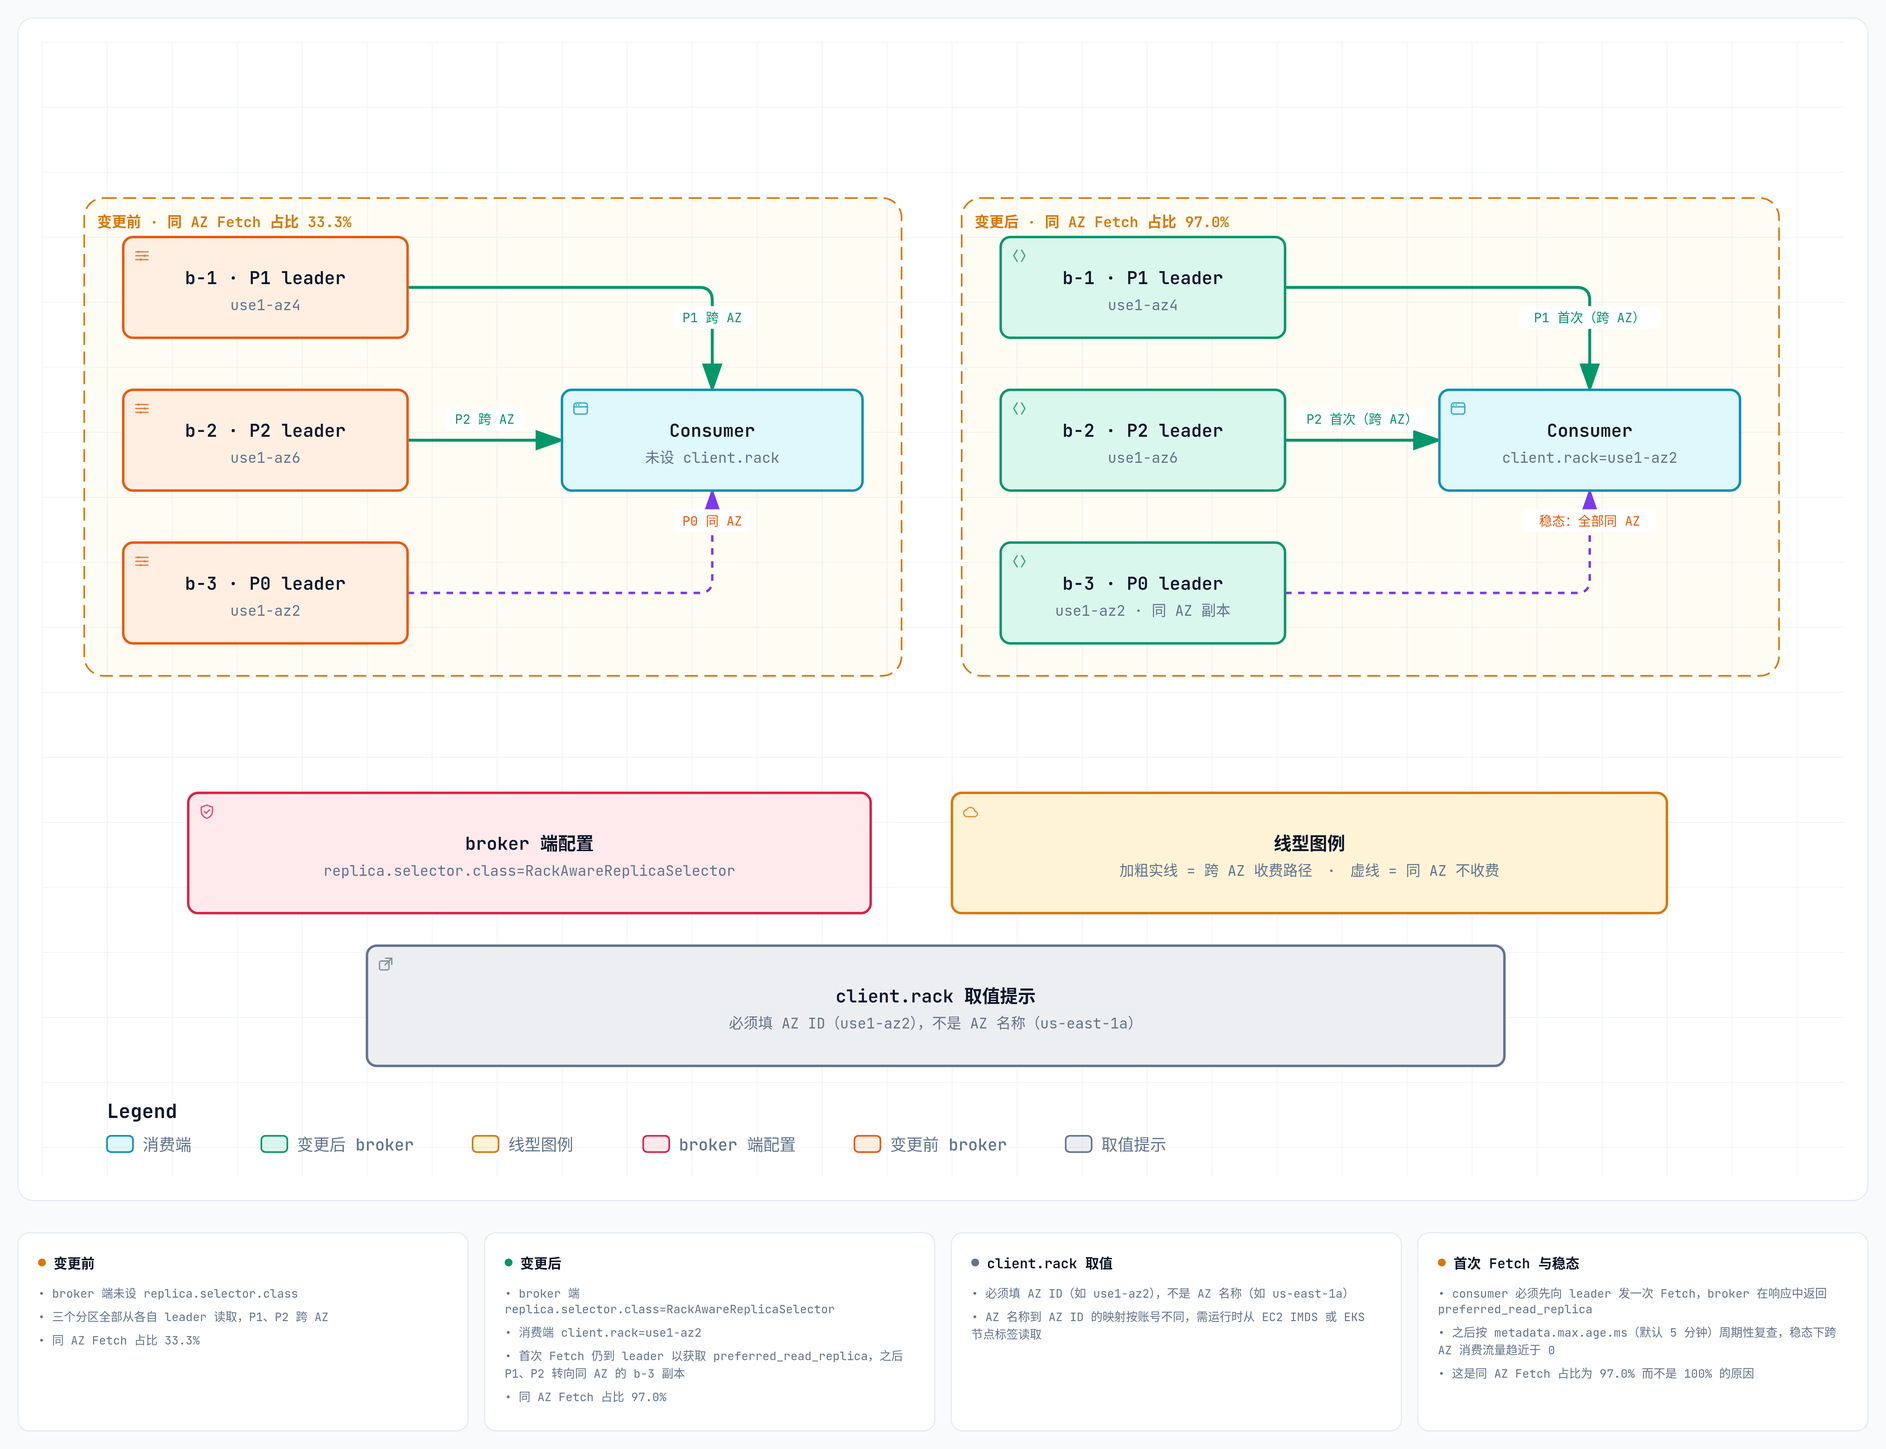
本文介绍 Amazon MSK 成本优化实践。MSK 费用包括 broker 实例、存储、跨 AZ 流量和监控。核心优化措施:启用 zstd 压缩并调整批处理参数以降低存储与流量费用;缩短数据保留期或启用分层存储;开启机架感知消费以消除跨 AZ 读取费;按需选择监控档位;合理选型 Standard 与 Express。综合优化后成本可降低约九成。
CloudJump III 提出引擎集成分层存储方案,将数据放置决策融入存储引擎,利用页类型、存活时间等元信息优化冷热数据分布。通过BPE缓存准入策略、OSS Buffer写合并及快照版本协议,实现性能稳定、成本优化和零停机备份,显著提升单位成本性能。
通过Opus 4.6与GPT 5.4的互评,设计了三层记忆架构OpenClaw,以解决AI记忆问题。该系统实现分层存储、检索与跨会话记忆,强调多层堆栈的有效性,提升AI协作设计能力。
谷歌云推出Bigtable分层存储预览,允许开发者在单实例中管理热数据和冷数据,优化成本。开发者可设置基于年龄的分层策略,自动在SSD和低频访问层之间迁移数据。此功能与Bigtable的自动扩展结合,提升资源利用率,支持分析和报告。分层存储节点的容量比普通SSD节点高540%。
企业正从单一可观察性平台转向分层存储,以应对高成本和日志数据激增。分层存储将数据分为金、银、铜三级,金级数据存储在高端平台,银级和铜级数据采用更经济的解决方案,从而降低总体拥有成本,提高数据可用性和分析能力。
Kafka的分层存储解决了历史数据与存储成本的矛盾,通过将数据分为高性能的本地存储和低成本的云存储,支持无缝访问。这一功能降低了历史数据的保留成本,提升了数据分析能力,促进了机器学习和合规审计,简化了应用开发,使企业更专注于数据价值。
谷歌为其分布式SQL数据库Spanner引入了分层存储,新的HDD存储选项比SSD便宜80%。此功能优化了旧数据存储成本,支持自动将数据从SSD迁移到HDD,适用于不常访问的大数据集,而SSD则用于高吞吐量和低延迟的数据。
Timescale Cloud改进了分层存储架构,用于管理PostgreSQL数据库。分层存储后端允许用户将较旧且不经常访问的数据移动到更便宜且速度较慢的存储中,而不会影响查询性能。最近的优化使得查询分层数据的速度提高了400倍。这使得用户能够显著降低存储成本,同时保持高性能,即使处理大型数据集也能如此。分层过程包括摄入新数据,对其进行列化以加快查询速度,将其分层到更便宜的存储中,最终删除最旧的数据。Timescale Cloud的分层存储对处理时间序列数据或其他要求严格的工作负载特别有益。
Uber已为Apache Kafka添加了分层存储,允许扩展存储功能。Red Hat和AWS也实施了分层存储,突出了其优势。然而,专家警告可能存在的复杂性和限制。
Redpanda是一个与Kafka API兼容的事件流平台,用C++编写,比Kafka快10倍。它支持分层存储和Raft共识算法,具有强大的身份验证和授权支持。Redpanda的安装包包含一个二进制文件,不依赖于JVM或Zookeeper。它适用于事件处理、合规性和安全平台、实时分析等用例。
开源日报推荐了RSSHub订阅生成器,并探讨YouTube存储空间看似无限的原因:其依靠VP9、H.264、AV1等压缩编码、分层存储、内容生命周期管理、全球数据中心复制及DNA存储等新兴技术,应对每天约4.3PB的上传量,避免存储耗尽。
完成下面两步后,将自动完成登录并继续当前操作。