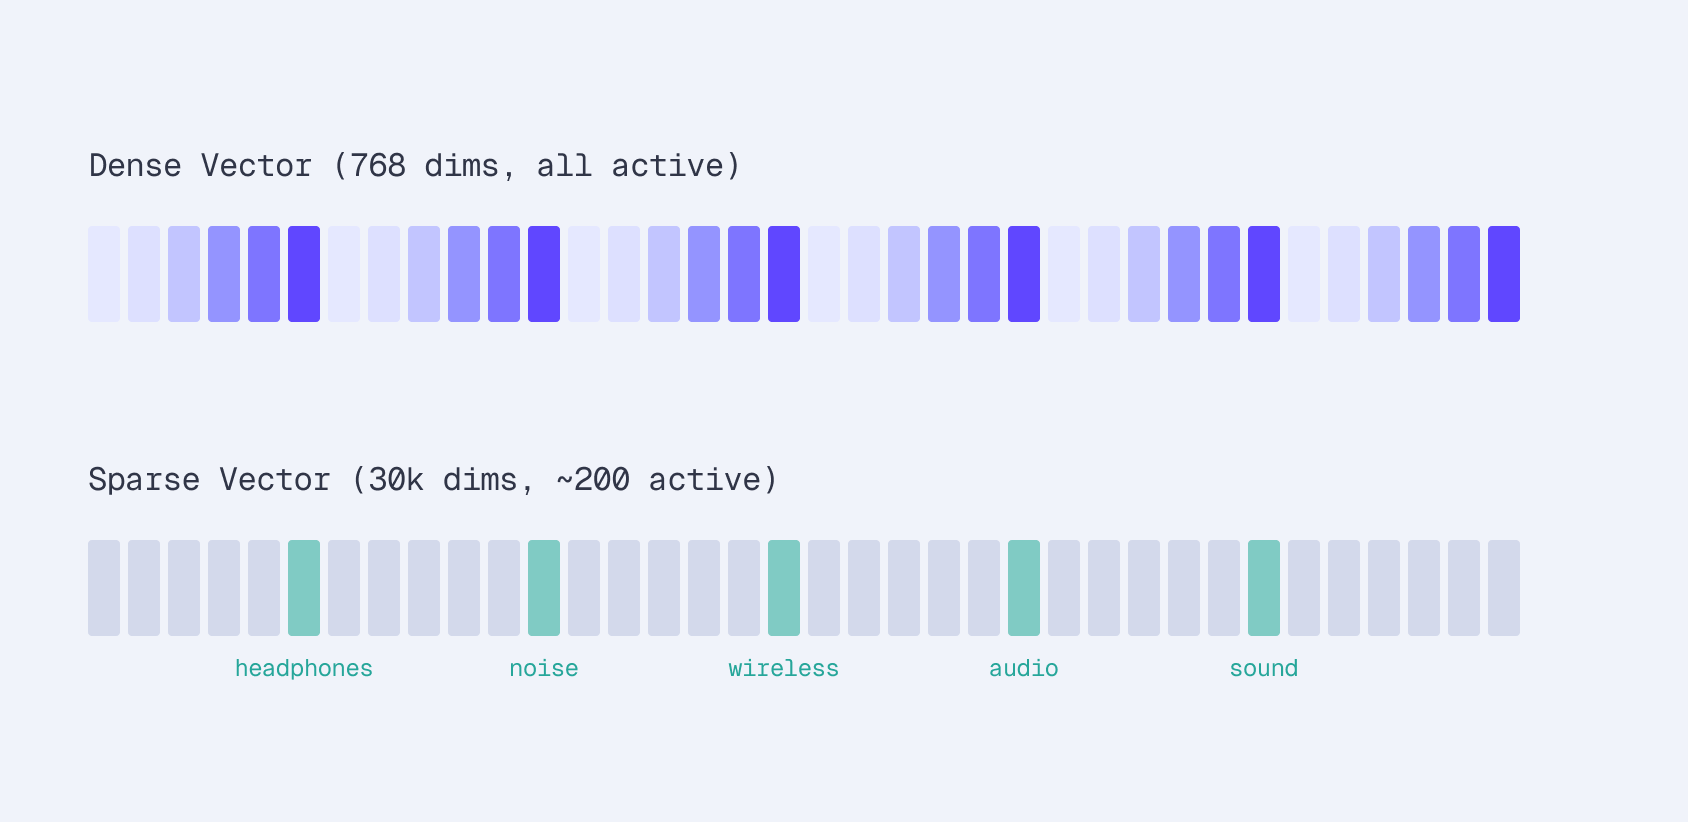
本文讨论了稀疏嵌入在电子商务搜索中的优势,特别是相较于BM25的29%提升。稀疏嵌入通过保留单个词汇的信号,解决了密集嵌入模糊匹配的问题,确保了精确匹配。SPLADE模型通过学习相关词汇扩展查询,提升了搜索结果的准确性。后续文章将详细介绍训练和评估过程。
本文讨论了在电子商务搜索中微调稀疏嵌入的方法,重点介绍了使用亚马逊ESCI数据集训练SPLADE模型的过程。强调了数据格式化的重要性,以及通过SpladeLoss实现对比学习与稀疏性正则化的平衡。此外,使用Modal的持久存储解决了检查点管理问题,确保了训练过程的稳定性。
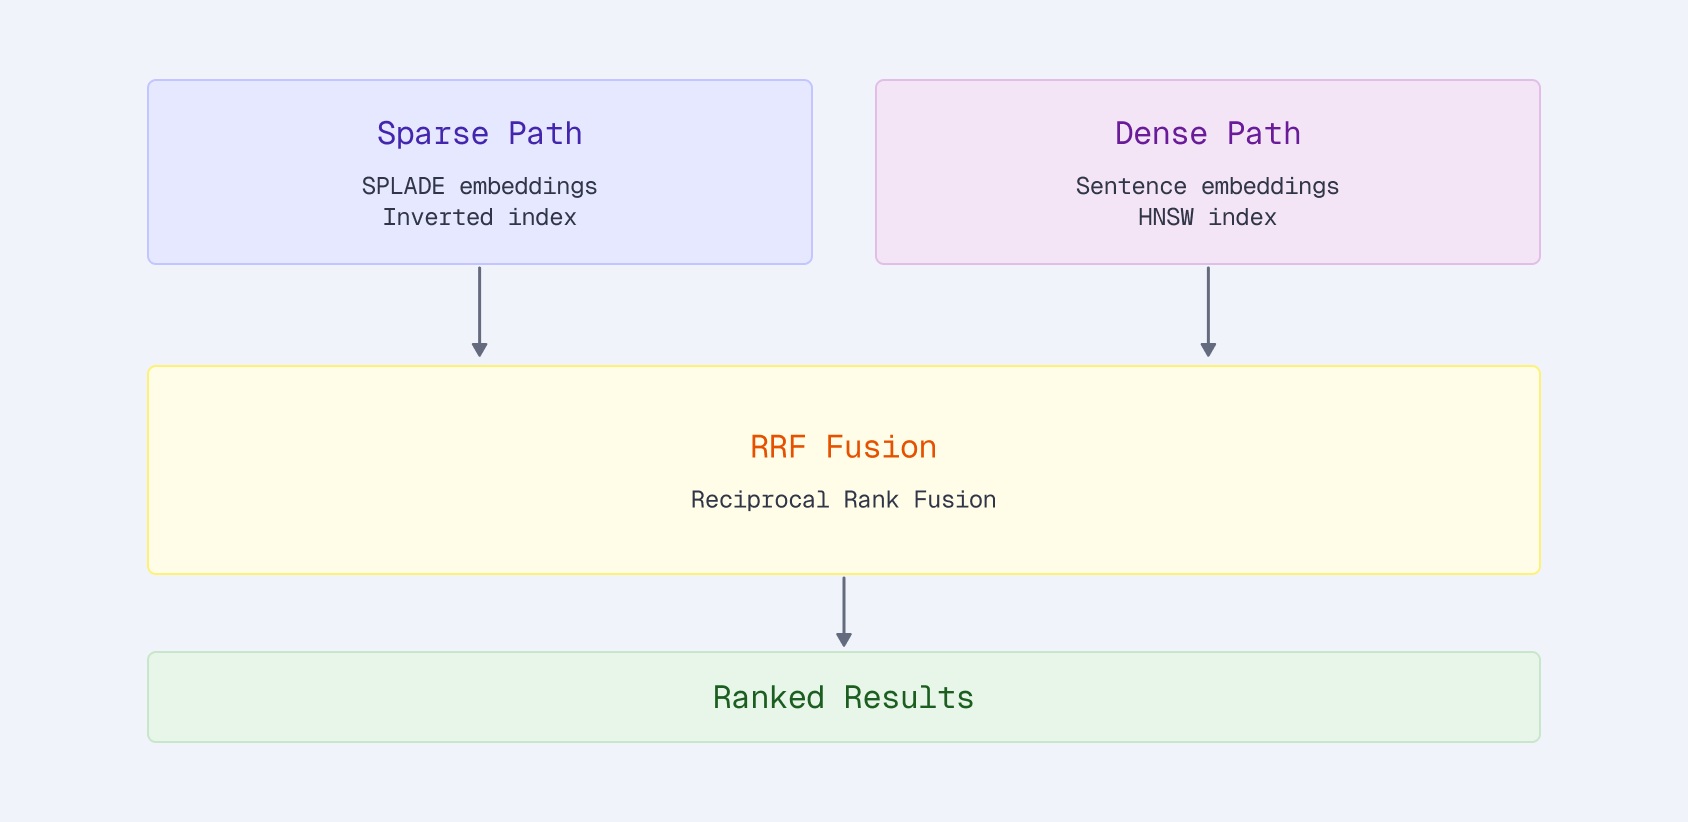
本文讨论了电子商务搜索中的稀疏嵌入微调,重点评估了SPLADE模型及其困难负样本挖掘。经过微调的SPLADE模型在nDCG@10指标上比BM25提高了28%,强调了领域特定训练的重要性。文章还分析了稀疏与密集向量的混合搜索效果,以及困难负样本挖掘(ANCE)对模型性能的提升。总体而言,微调显著改善了查询扩展、术语加权和电商词汇的表现。
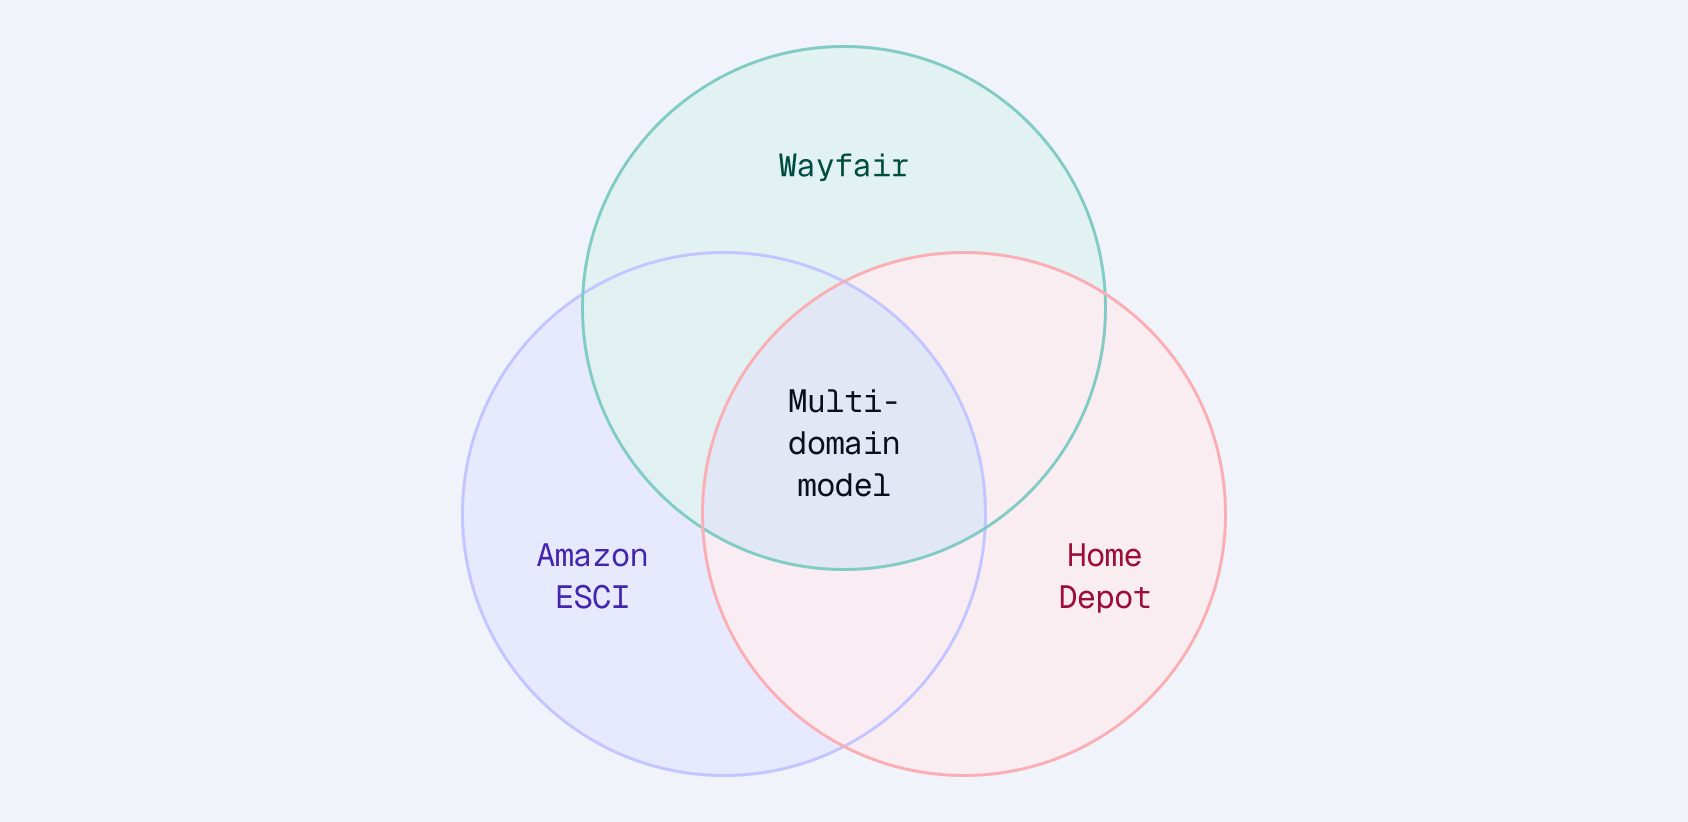
本文探讨了电子商务搜索中的稀疏嵌入微调,分析了专业化与泛化的权衡。研究表明,专注于特定领域的微调在单一零售商中效果最佳,而多领域训练则在多个零售商中更具泛化能力。微调模型能够更好地理解特定领域的搜索模式和词汇,从而提升搜索效果。
本文介绍了如何使用qdrant-sparse-finetune工具化稀疏嵌入微调,以改善电子商务搜索。该工具简化了数据处理、模型训练和评估流程,支持自动化操作,提升用户体验。最终,用户可将模型快速发布到HuggingFace,实现28%的性能提升。
稀疏嵌入比稠密嵌入更适合电商搜索,能精确匹配型号、容量等关键细节。SPLADE利用Transformer结合对数饱和与最大池化,生成约3万维中仅数百非零的稀疏向量,实现词项加权、同义词扩展和噪声抑制,无需人工规则。在亚马逊ESCI数据集上,微调后nDCG@10达0.389,较BM25提升17%。教程涵盖Modal GPU训练、Qdrant评估、难负样本挖掘及产品化。
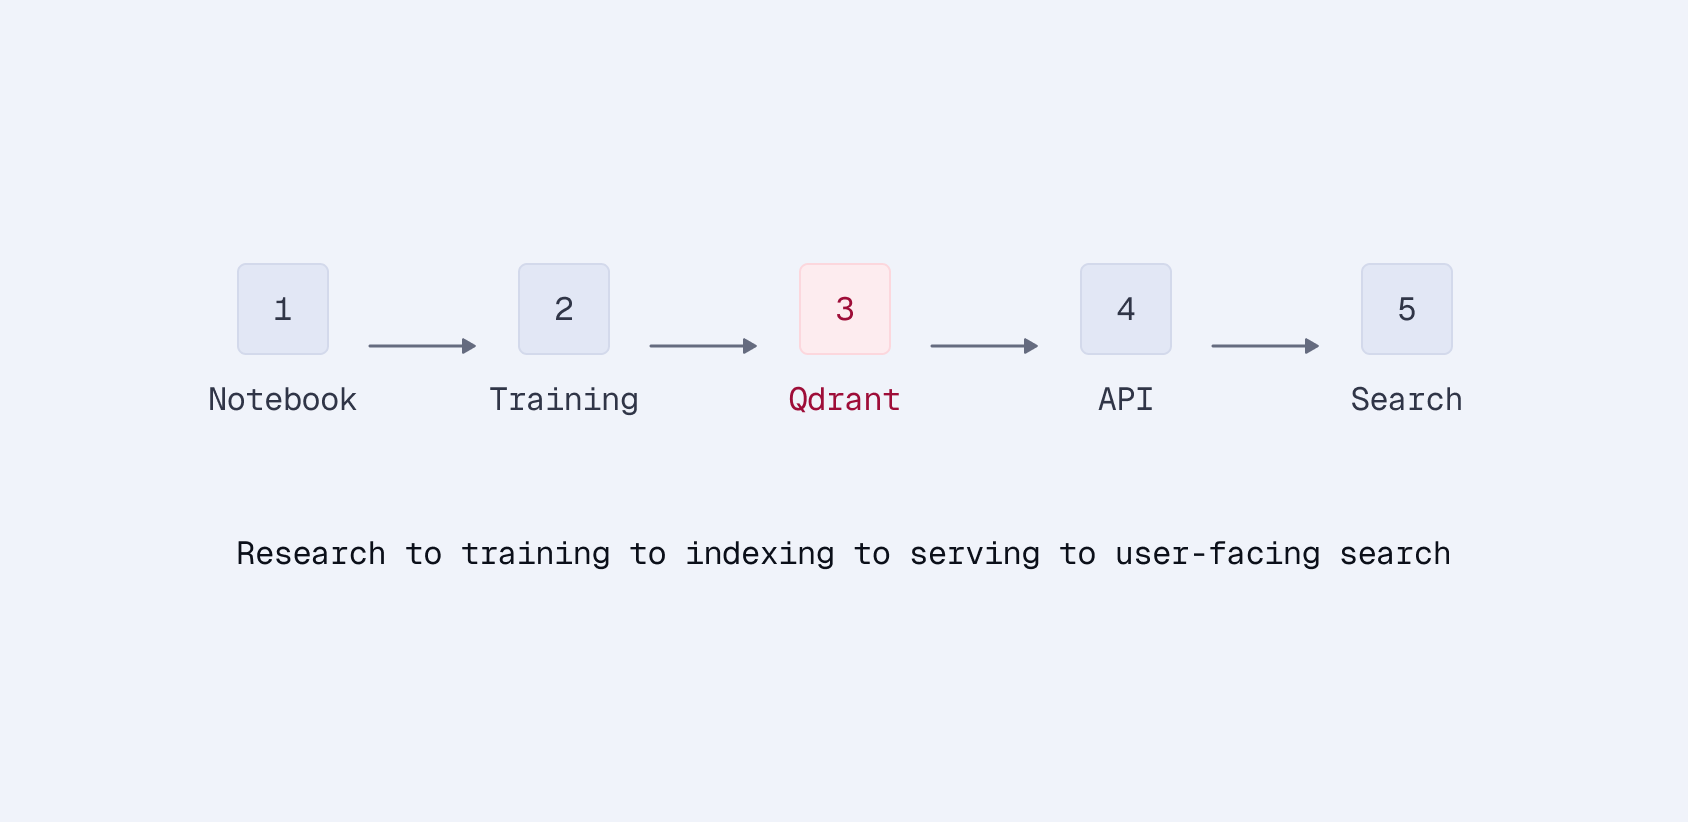
本文介绍使用Modal无服务器GPU训练SPLADE稀疏嵌入模型。基于亚马逊ESCI数据集,将Exact和Substitute对作为正样本,通过SpladeLoss结合对比学习与稀疏正则化,控制查询约30词、文档100-400词。产品文本以品牌括号和竖线分隔格式化。10万样本在A100上训练约6分钟、成本不足1美元,检查点存入持久卷,支持断连续跑和并行超参搜索。
本文研究稀疏嵌入模型的专精与泛化权衡。在Amazon ESCI上微调的SPLADE模型,域内比BM25提升17%,跨电商域提升8-10%,但在MS MARCO通用网页搜索上下降18%,出现灾难性遗忘。多域训练(ESCI、WANDS、Home Depot各5万对)可缓解:ESCI降4%,其他域升3-7%,MS MARCO恢复10%。建议单一零售商用领域微调,多零售商平台用多域训练,冷启动用现成SPLADE。
本研究提出了一种字典标签注意力模块,旨在提高多标签医疗编码预测的可解释性。该方法通过将稠密嵌入转化为稀疏嵌入,增强了模型的理解能力,揭示了数千个医疗概念,同时保持了竞争性能和可扩展性。
BM42是一种结合了语义搜索和关键词搜索的新方法,利用BM25算法的排名原理,控制词频和文档长度对相关性得分的影响。BM42使用稀疏嵌入和Transformer模型,具有高可解释性、低内存占用和高准确率。然而,对于没有块的大型文档,BM25可能更适合。
完成下面两步后,将自动完成登录并继续当前操作。