Mozilla为Firefox的AI浏览功能Smart Window推出更新:新增表单自动填写,可基于已打开的标签页(如作品集、LinkedIn)生成内容填入求职表,数据会共享给谷歌Gemini 3.1 Flash Lite;同时支持用“/watch”指令监控网页的促销、招聘等变化,每日或每周检查并在浏览器开启时通知,60天无变化暂停、90天停止。两项功能先在美国和加拿大桌面测试版推出。
Beam 是一款 Mac 新应用,可将一台 Mac 上的单个窗口投射到另一台 Mac,并像本地应用一样使用,拥有独立 Dock 图标,支持快捷键、拖拽和音频。它面向运行 AI 代理的无头 Mac Mini,要求两台机器均为 Apple Silicon、运行 macOS Sonoma 以上并安装 Beam,可通过同一 Wi-Fi 或 Tailscale 连接,数据加密直传。托管 Mac 和加入共享链接免费;使用自己的 Mac 每天免费 20 分钟,之后月费 12 美元。
Subquadratic发布决策模型SubQ Snap,支持38.4万token上下文,约为Jev的12倍,可一次性处理大型代码库和文档。该模型采用稀疏注意力架构,降低长输入计算成本,在多项基准测试中优于Jev,定价为每百万输入token 0.05美元。公司称更大上下文可简化AI代理开发,但结果均为内部测试,尚待独立验证。
Google发布Gemini 4 Argon,单次输出上限提至100万Token,面向软件工程与企业Agent。模型可在单条轨迹内规划、调用工具、改代码并验证,减少多回合交接损耗,但放大成本失控、错误累积与审计难度。厂商内部案例显示代码迁移等收益,但缺独立复现。企业需设预算、检查点与人工审批,不能把百万Token当作取消任务拆分的理由。
pub.dev 的下载量仅显示30天滚动窗口,而非累计总量,发布初期高峰过后数字骤降,易被误判为包已衰退。作者发现其未公开的 metrics 接口提供52周每周下载数据,据此开发了 PubTrace,可展示任意包的完整累计下载曲线。该工具不存数据库,数据实时取自 pub.dev 官方接口,并附 curl 命令供用户自行验证。
Niaz Morshed 开源了 JCR,利用 Jev 树状路由在六层能力目录中逐层筛选,将 11360 条 API 命令的检索压缩为少量结果。实测显示,Claude Opus 5 的输入 token 减少 85%、成本降低 67%,但 GPT-5.6-Sol 耗时增加 2.5 倍。JCR 仅返回文档而不执行命令,适用于按 token 计费昂贵且可接受延迟的场景。
作者发布第四个Omarchy插件Smart Gaps。Omarchy是平铺窗口管理器,多窗口时半透明效果美观,但单窗口工作区仍显示空隙和描边,浪费空间且不够沉浸。该插件在单窗口时自动隐藏空隙和描边,提升专注度,代码以GPL 3.0开源。
作者为Omarchy开发了首个插件Window Switcher,认为平铺和浮动窗口都需要预览,否则切换时容易晃眼、缺乏边界感。该插件基于Orbit和Overview Window改造,安装后无需设置即可用Alt+Tab切换工作区窗口、Super+Tab切换工作区,以MIT许可证发布。
火狐浏览器与法国Mistral合作,在智能窗口中新增Mistral Small 4模型作为个性化选项,替代GPT-OSS-120B。智能窗口支持总结网页、对比信息、整理选项卡和检索历史,用户可切换模型或自备API。双方强调零数据留存,但请求仍需经火狐服务器转发云端处理,记忆存本地。
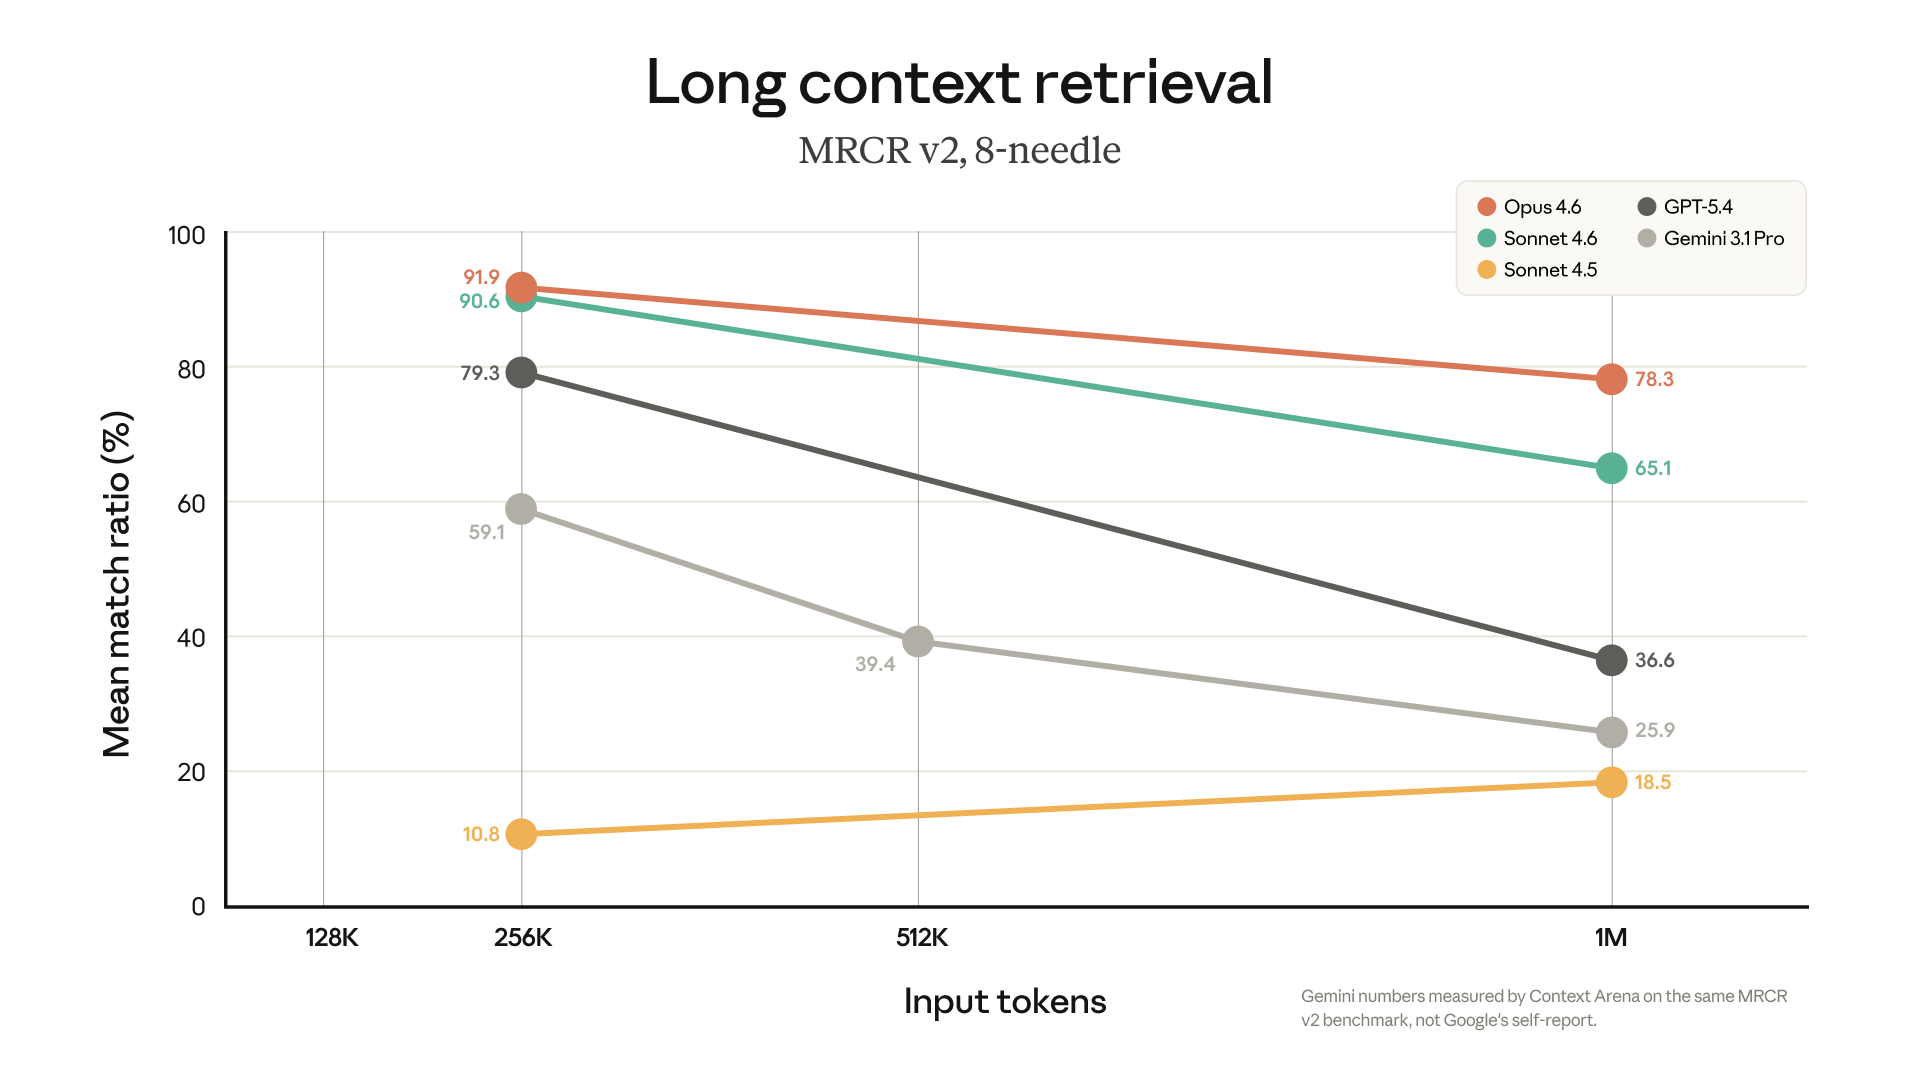
Claude Opus 4.6和Sonnet 4.6现已在Claude平台上推出,提供完整的100万上下文窗口。Opus 4.6的定价为每百万标记5美元/25美元,Sonnet 4.6为3美元/15美元。新版本支持更高的请求量和更长的上下文,提升了准确性,用户可以直接加载大量数据,保持对话完整。
OpenAI呼吁在AI能力快速提升之际加强政策监管,主张与国会合作制定强制性国家安全标准,支持加州四项法案,推动行业监测标准与国际协调。公司称已强化模型监测与对齐安全措施,必要时会放缓开发,并强调安全是AI持续进步与广泛应用的前提。
OpenAI调整GPT-6 Astra在Codex中的计费政策:使用该模型时,1M上下文窗口内超出272K部分不再额外收费,全部按标准费率计费,且缓存输入免费。但此优惠仅限GPT-6 Astra与Codex组合,其他模型如GPT-5.4/5.5/5.6超长部分仍按1.5-2倍费率收费。
AI产品保存信息方式不同,大模型受上下文限制易丢信息。测试显示,使用六栏交接卡(任务、限制、已完成、下一步、禁区、验收)可显著提升找回率,从2项增至6项。交接卡放项目文件夹,每次更新,提供时让AI复述并指出冲突,敏感信息留卡外。此方法省时且可复用。
Claude Code Agent Loop的核心机制是:用户输入后,harness记录历史并循环调用LLM,执行工具调用并追加结果,直到无工具请求才结束。用户仅参与首尾,中间自动运行。真实产品需处理上下文满、API失败、中断、工具崩溃等复杂情况,并集成hooks、权限批准、maxTurns等机制。
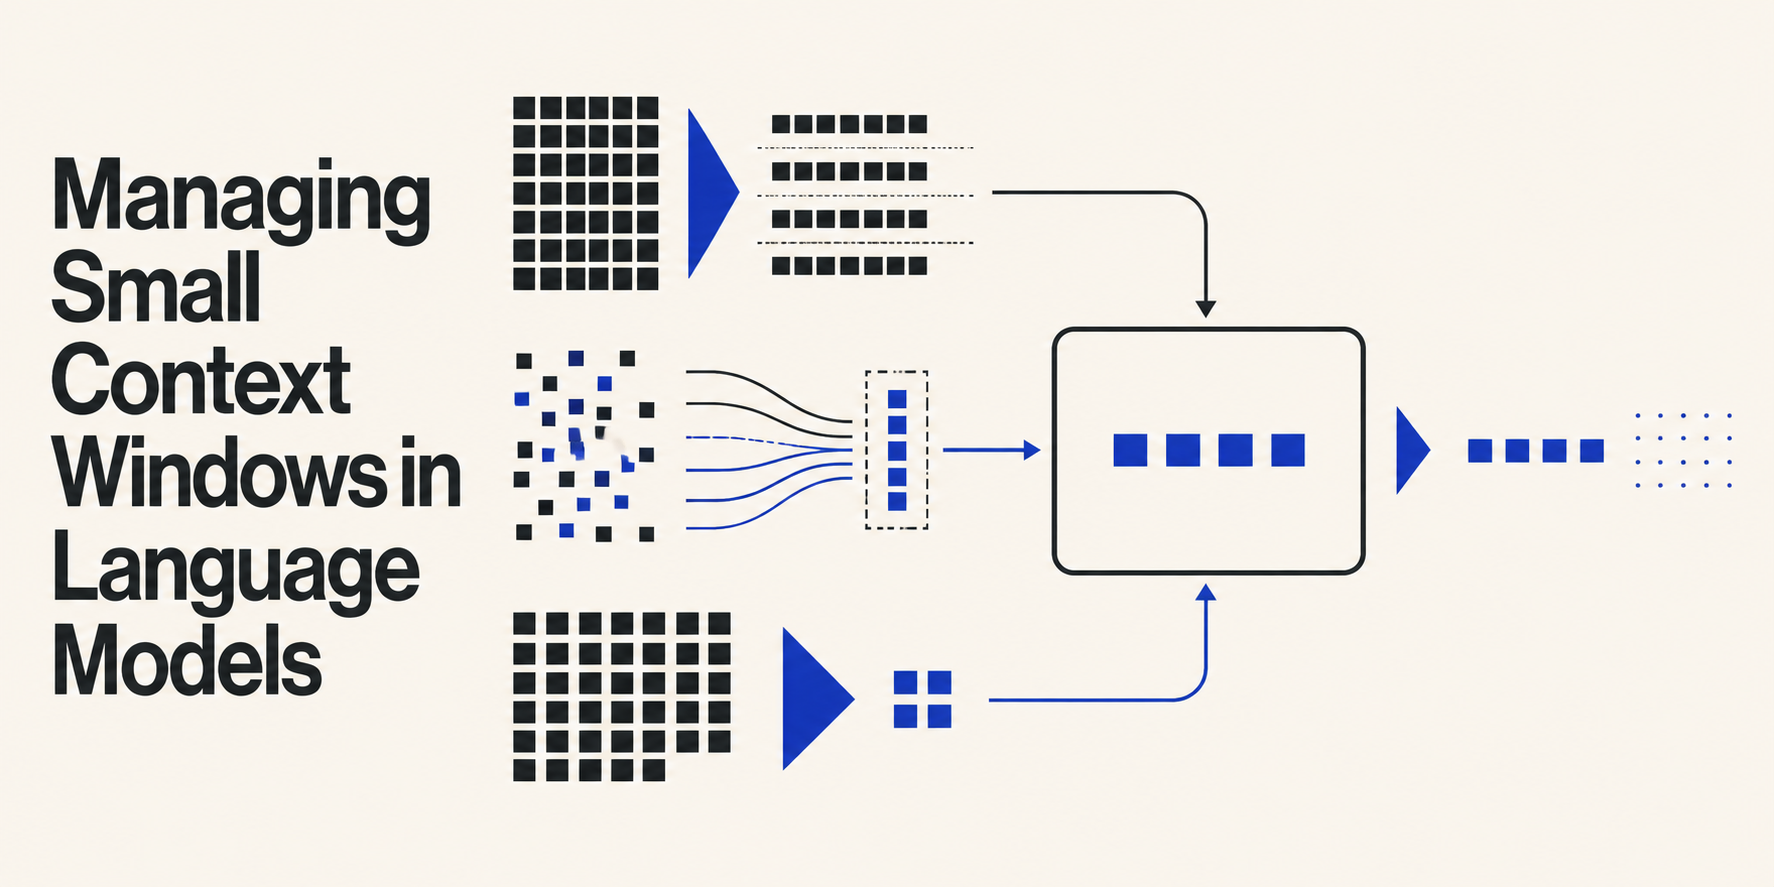
本文介绍管理大语言模型小上下文窗口的三种实用策略:滑动窗口截断法,通过FIFO队列保留最近对话,控制token使用;令牌预算结合检索增强生成,按比例分配上下文空间,确保只纳入最相关信息;以及滚动摘要、提示压缩和观察掩蔽等进阶方法。文章强调小上下文窗口能降低成本、减少延迟,并避免“迷失在中间”问题。
Tetragon v1.7.0通过Runtime Hooks在容器创建时同步通知agent,使policyfilter在进程执行前就绪,避免API server异步延迟导致的策略漏事件或误放行。支持CRI-O OCI hooks和containerd NRI两种方式,agent不可达时可按namespace配置fail-open或fail-closed。无hook时仅保证best-effort,不保证策略在容器启动前生效。
ElevenLabs推出托管MCP连接器,使开发者能通过Claude直接管理ElevenAgents代理,包括修改系统提示、更换语音和估算成本。该连接器具备双层访问控制以防误操作,并支持测试框架和版本管理。文章强调,AI代理修改生产系统时需谨慎,因为工具调用成功不代表结果正确,需结合CLI/API流程确保安全。
OpenAI与Hugging Face事件凸显AI攻击能力,促使组织加速升级网络安全。OpenAI正通过AI模型强化代码安全、基础设施防御、攻击路径识别及基础控制。建议组织立即行动:获取高层支持,部署AI代理进行安全评估、修复漏洞、自动化检测,并准备AI辅助取证,以在AI时代保持防御优势。
Codex现支持通过修改config.toml配置文件启用GPT-5.6模型的1M上下文窗口,默认272K,可在900K时自动压缩。但技术经理建议不修改,因1M窗口会更快消耗配额,当前配置已是最佳。ChatGPT订阅用户现也可体验此功能。
本文介绍Cilium策略编译机制:从声明式策略经解析、选择器蒸馏为数字Identity,最终生成per-endpoint BPF策略map。重点分析default-deny按方向切入的时序窗口、Identity分配与传播延迟、ClusterMesh同步滞后等故障场景,并讨论L7代理重定向、实体规则及排障归因方法。
完成下面两步后,将自动完成登录并继续当前操作。