本文以 Koog 1.3.0 的 Kotlin API 为例,讲解模型调用的输入与输出。输入方面,user 消息可混排文本与图片、音频、视频、文件等附件,但多模态支持取决于 provider 和模型能力,例如 DeepSeek V4 Flash 不支持 document 附件。参数方面,LLMParams 可在 prompt、子图、会话三层生效,包含 temperature、maxTokens、toolChoice、schema 等字段,并有构造期校验。输出方面,流式调用 requestLLMStreaming 返回 Flow<StreamFrame>,可用 collectText 拼接文本,也可边流式边解析 Markdown 为对象;结构化输出用 data class 加注解生成 schema,requestLLMStructured 返回 Result,解析失败可由 StructureFixingParser 自动修复。文中还提及 Anthropic 与 Bedrock 的提示词缓存配置差异。
SSR框架将多模态智能体推理改为从预设候选语句中选择而非自由生成,无需辅助任务头,支持并行评分。在七个搜索基准上,2B和4B模型表现与同类领先智能体相当,每轮推理延迟降低超90%,单题总推理延迟降低28%至54%。
结构化并发是Project Loom在JDK 21虚拟线程之后的重要特性,将相关任务组视为单一工作单元,简化取消、错误处理与可观测性,使并发代码更易理解和维护。该特性经过多次预览版迭代,API虽小但支持多种模式。演讲介绍了其动机、设计、用法及演进经验,并透露了未来底层API的方向。
Project Loom 通过虚拟线程、作用域值和结构化并发三大特性,解决了Java传统并发中的线程开销、上下文传递和错误处理等问题。虚拟线程轻量高效,作用域值安全传递数据,结构化并发统一管理任务生命周期。IntelliJ IDEA 提供调试支持,帮助开发者编写更简洁、可扩展的并发代码。
本文介绍了开源库“outlines”,旨在提高大型语言模型(LLM)生成结构化输出的准确性。通过示例,展示了如何进行情感分析、生成符合Pydantic模型的JSON对象,以及为REST API生成有效的JSON负载。outlines通过限制生成过程中的非法符号,确保输出符合预期格式,减少常见错误和不确定性。
该文章介绍了一个数字平台的开发,旨在通过教练引导的模式帮助患者缓解慢性疼痛。团队采用分阶段的研发方法,确保在编码前充分理解需求,并通过整合设计和产品管理工具提升开发效率和团队协作,最终实现高质量代码和快速开发。
本文提出了一种名为Ctrl-R的框架,通过可控轨迹学习结构化推理,旨在系统性地发现和强化多样化的推理模式。实验表明,Ctrl-R能有效探索并内化以往难以获得的推理模式,提升语言和视觉-语言模型在数学推理任务上的表现。
本文介绍了结构化提示驱动开发(SPDD)方法,旨在将AI编程助手的个人效率转化为组织级能力。SPDD将提示视为重要的交付文档,便于版本控制和复用。通过明确需求和设计意图,团队能够更高效地生成和验证代码,减少开发中的不确定性。SPDD强调在生成代码前锁定意图,并通过迭代反馈确保代码与业务需求一致,从而提高软件交付的质量和速度。
dmsg.el 是一个用于 Elisp 的调试日志系统,解决了 *Messages* 缓冲区混乱、缺乏调用栈和日志级别的问题。它提供带时间戳和日志级别的日志记录,支持交互式浏览和过滤。用户可以通过简单的宏记录日志,自动捕获调用栈,并导出日志,同时可以拦截现有代码的消息和错误,方便调试。
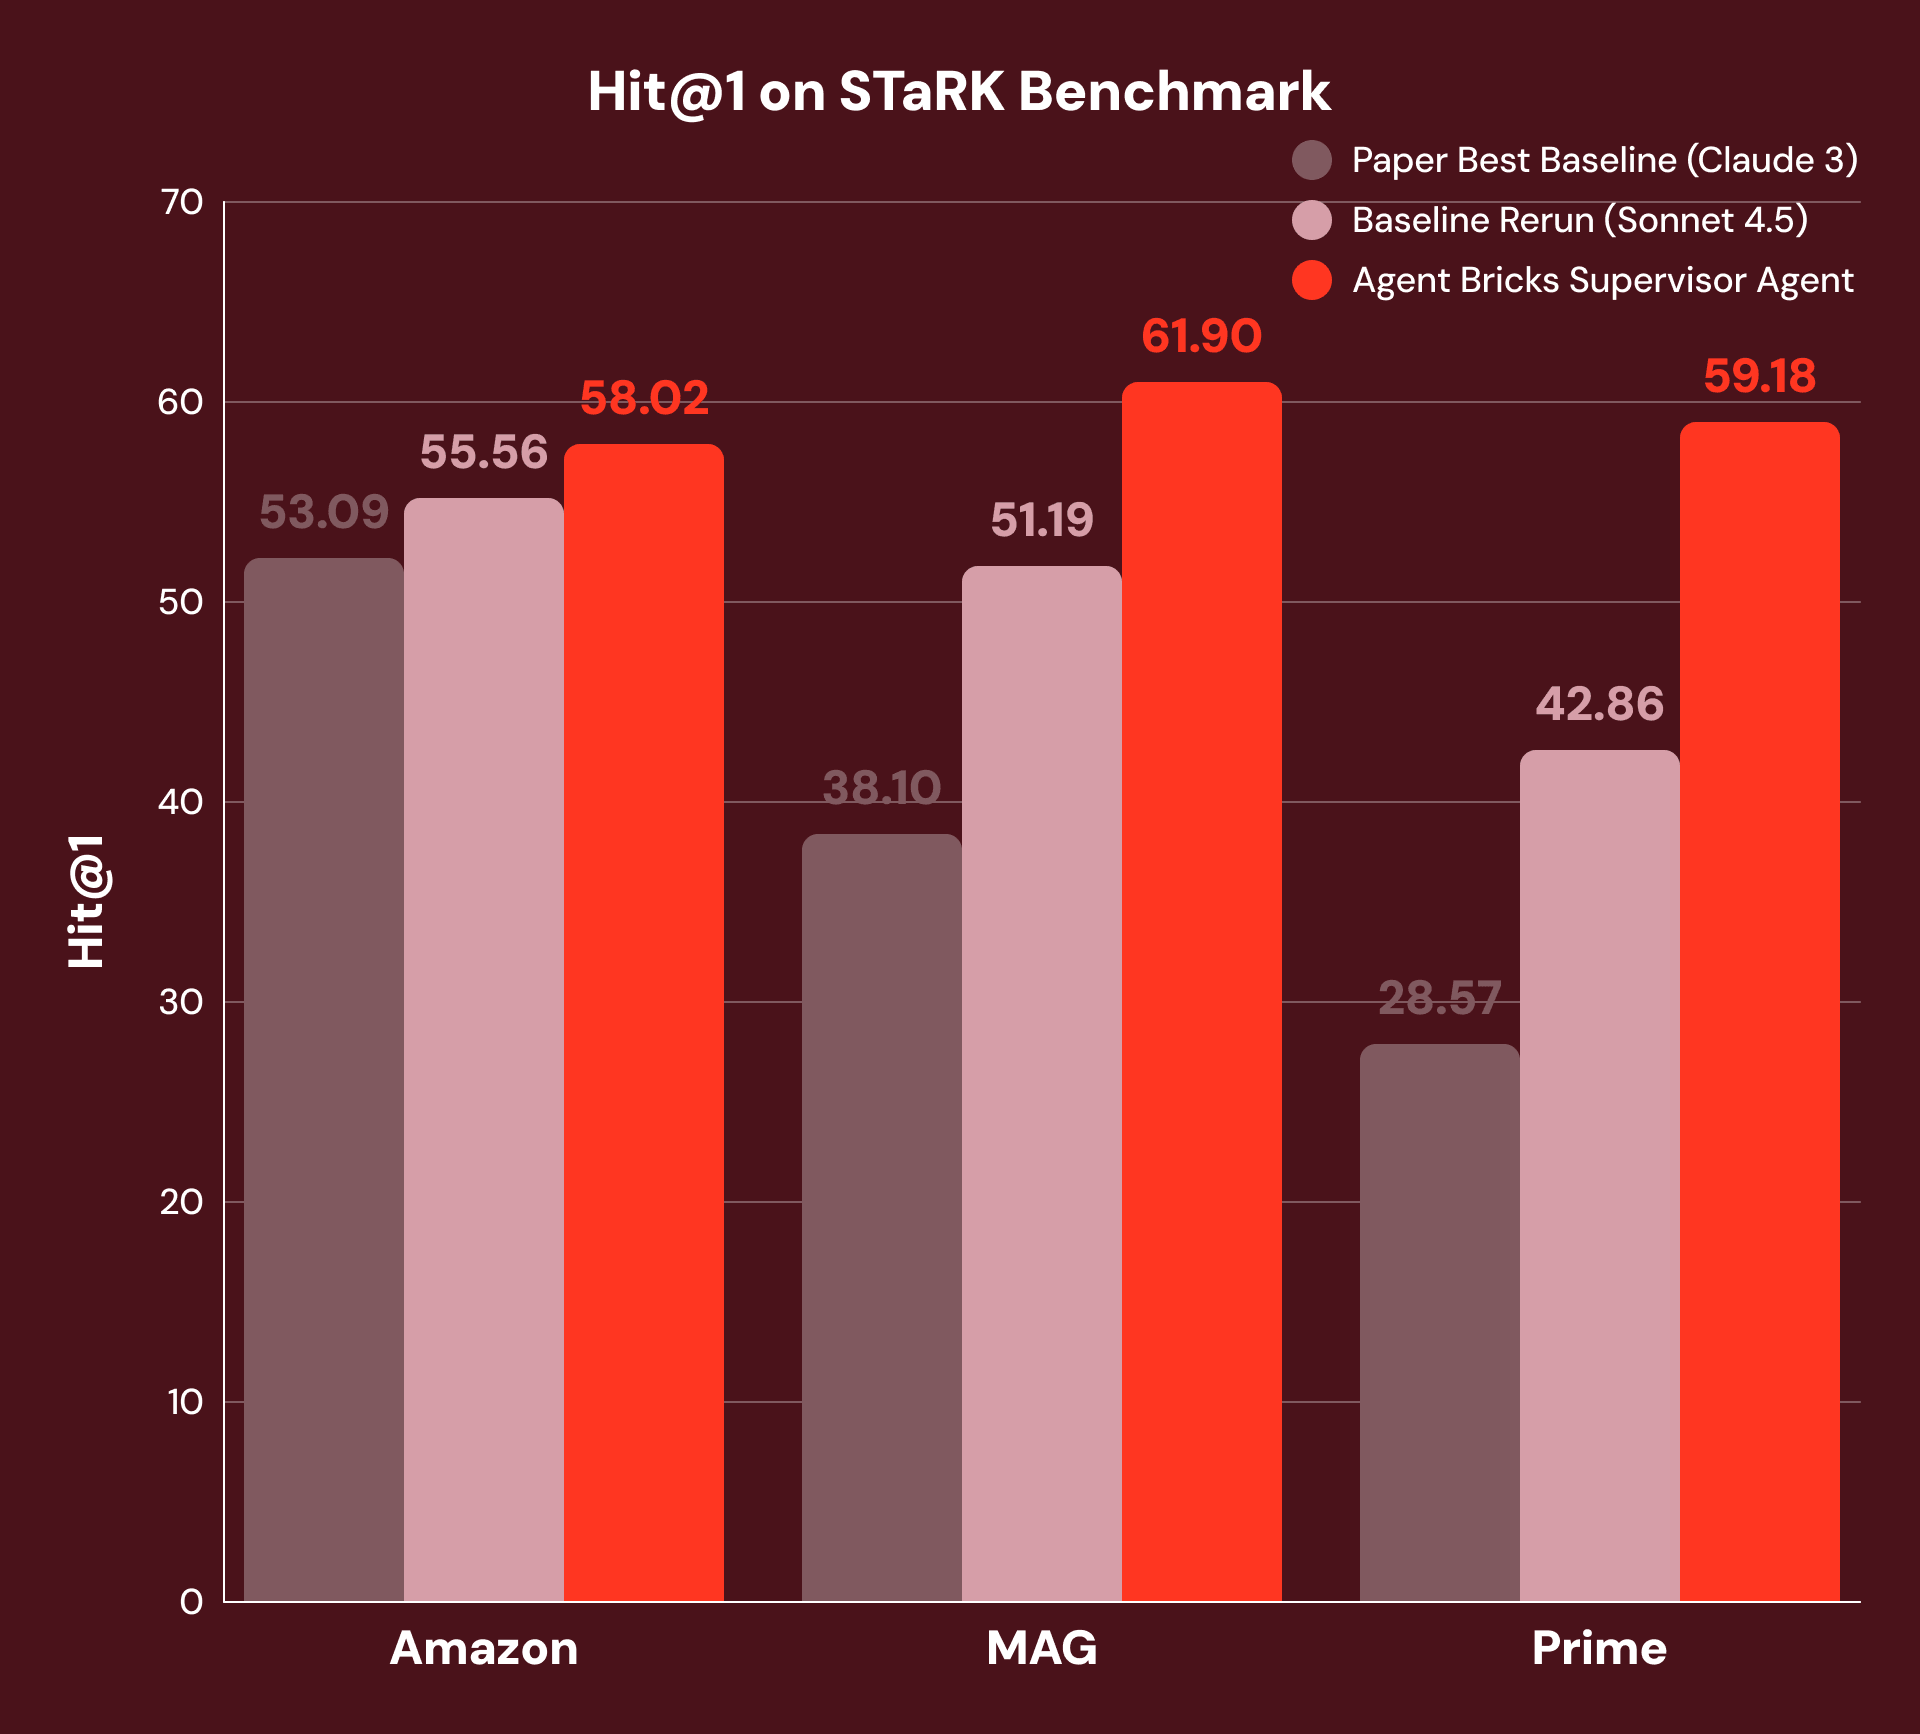
Databricks的Supervisor Agent(SA)通过多步骤推理,结合结构化和非结构化数据,提升企业任务处理效率。SA在学术检索和金融分析等知识密集型任务中表现优异,灵活架构允许用户通过简单配置优化性能,无需编写代码。SA有效分解复杂问题,整合多种数据源,提高检索和推理能力。
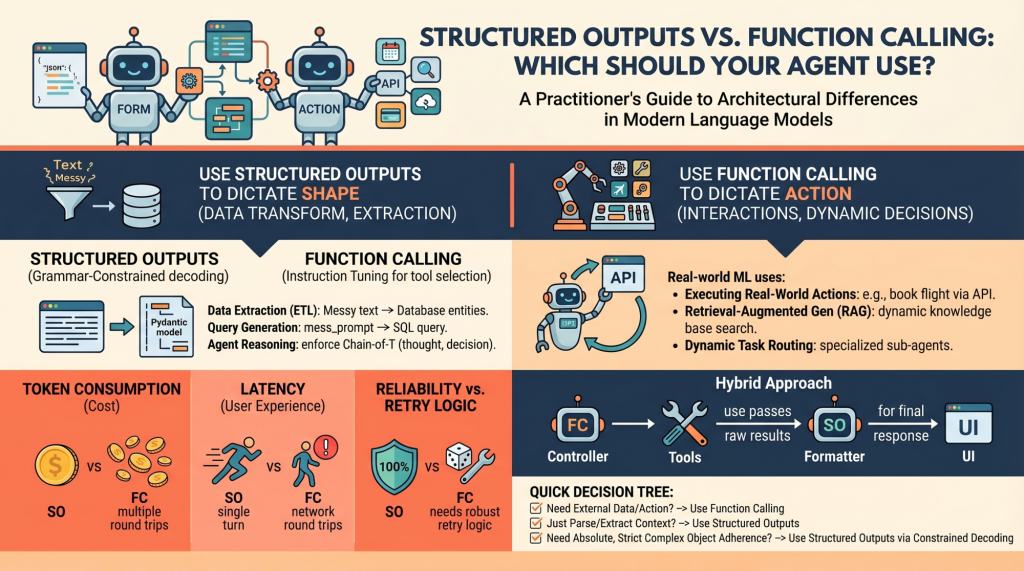
本文讨论了现代语言模型系统中结构化输出与函数调用的架构差异。结构化输出适用于数据转换和标准化,确保高一致性;而函数调用则用于动态决策和外部交互,适合需要实时信息或执行操作的场景。选择合适的方法可以提高系统的可靠性、降低延迟和成本。理解这两者的区别对构建高效的自主代理至关重要。
GBrain是一个持续进化的AI认知系统,通过结构化知识库和自动循环机制,实现长期记忆和信息积累。它将生活数据转化为可检索的知识,解决了普通AI缺乏长期记忆的问题。系统通过混合检索和定期更新,确保信息的准确性和可控性,形成一个不断增强的认知网络。用户可以直接修改数据,保持对AI的控制权。
Farzapedia是一个个人知识库系统,通过整理日记、笔记和聊天记录,构建结构化知识网络,提升AI理解效率,帮助用户更好地管理个人数据。
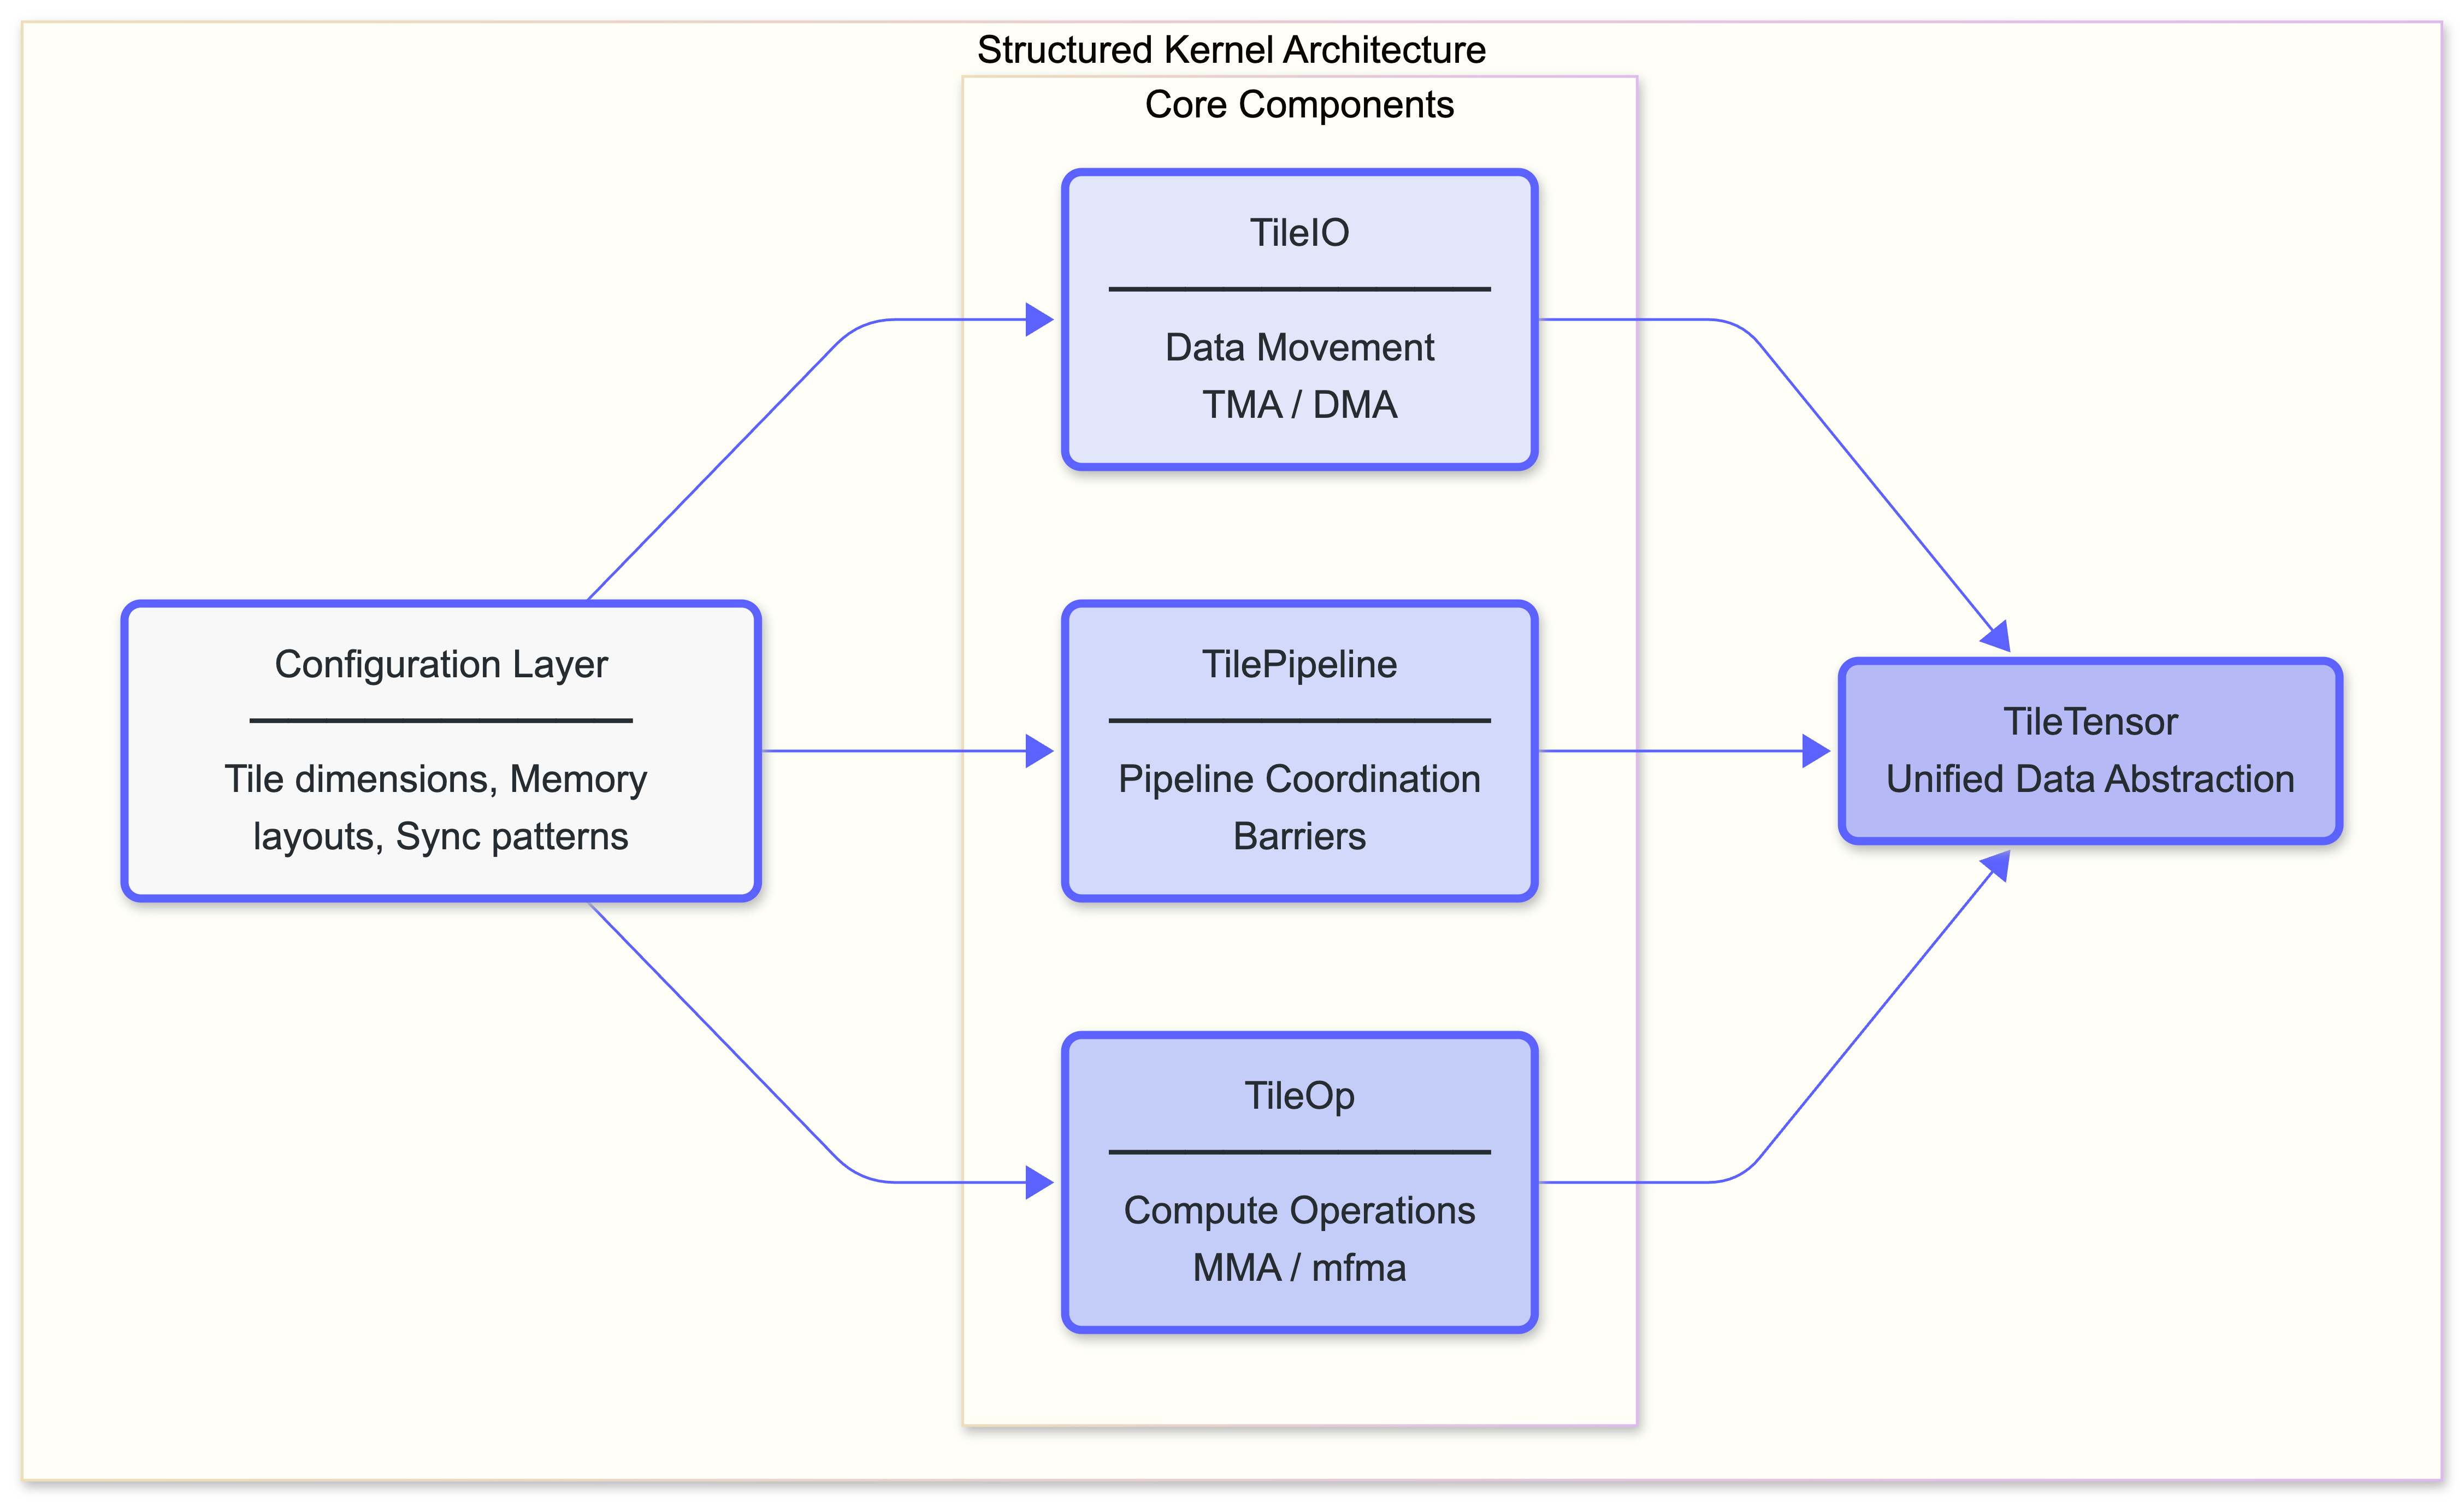
Modular推出的Structured Mojo Kernels旨在提升GPU编程的可维护性和性能。该架构通过组件化设计,实现了在不同硬件上高效运行的能力。与传统方法相比,Structured Mojo Kernels显著减少了代码量,同时保持与CUTLASS相同的性能,展现了可重用性和资源管理的优势。
本文讨论了结构化Mojo内核的设计,强调模块化编程的优势。通过示例展示了如何灵活替换和参数化内核组件,以适应不同的数据访问模式和数据类型,从而提高内核的维护和扩展效率,减少代码冗余和错误传播。
在并发程序中,传统的单线程错误处理模式不适用于多任务环境。建议采用“结构化并发”方法,通过任务树和自动取消机制来管理错误,以确保错误在任务间传播并简化资源清理。Python的asyncio和Go的errgroup等框架已开始实现这一理念,提升了并发代码的安全性和可维护性。
Modular收购BentoML,旨在提供云端AI生产解决方案。文章介绍了结构化Mojo内核架构,强调其在GPU内核中的优势,如减少代码量和提高性能。通过分离数据移动、管道协调和计算,结构化内核实现了跨硬件的可扩展性,简化了开发过程。
本文总结了有效的Prompt编写技巧,强调明确性、结构化和角色设定,以提高AI输出质量。通过实例和方法,如思维链和格式控制,帮助用户更好地与AI互动。
Modular收购BentoML,旨在提供云端AI生产解决方案。Mojo语言通过结构化内核简化GPU编程,提升开发效率,减少代码复杂性,同时保持高性能。结构化Mojo内核将逻辑分为三个核心组件,确保清晰的接口和职责分离,降低错误率并提高可维护性。
管理研究与开发存在本质差异。研究需应对不确定性,采用不同方法,确保与产品价值相连,使用有效工具和策略。通过结构化管理,研究能够产生实际影响,避免无效探索。
完成下面两步后,将自动完成登录并继续当前操作。