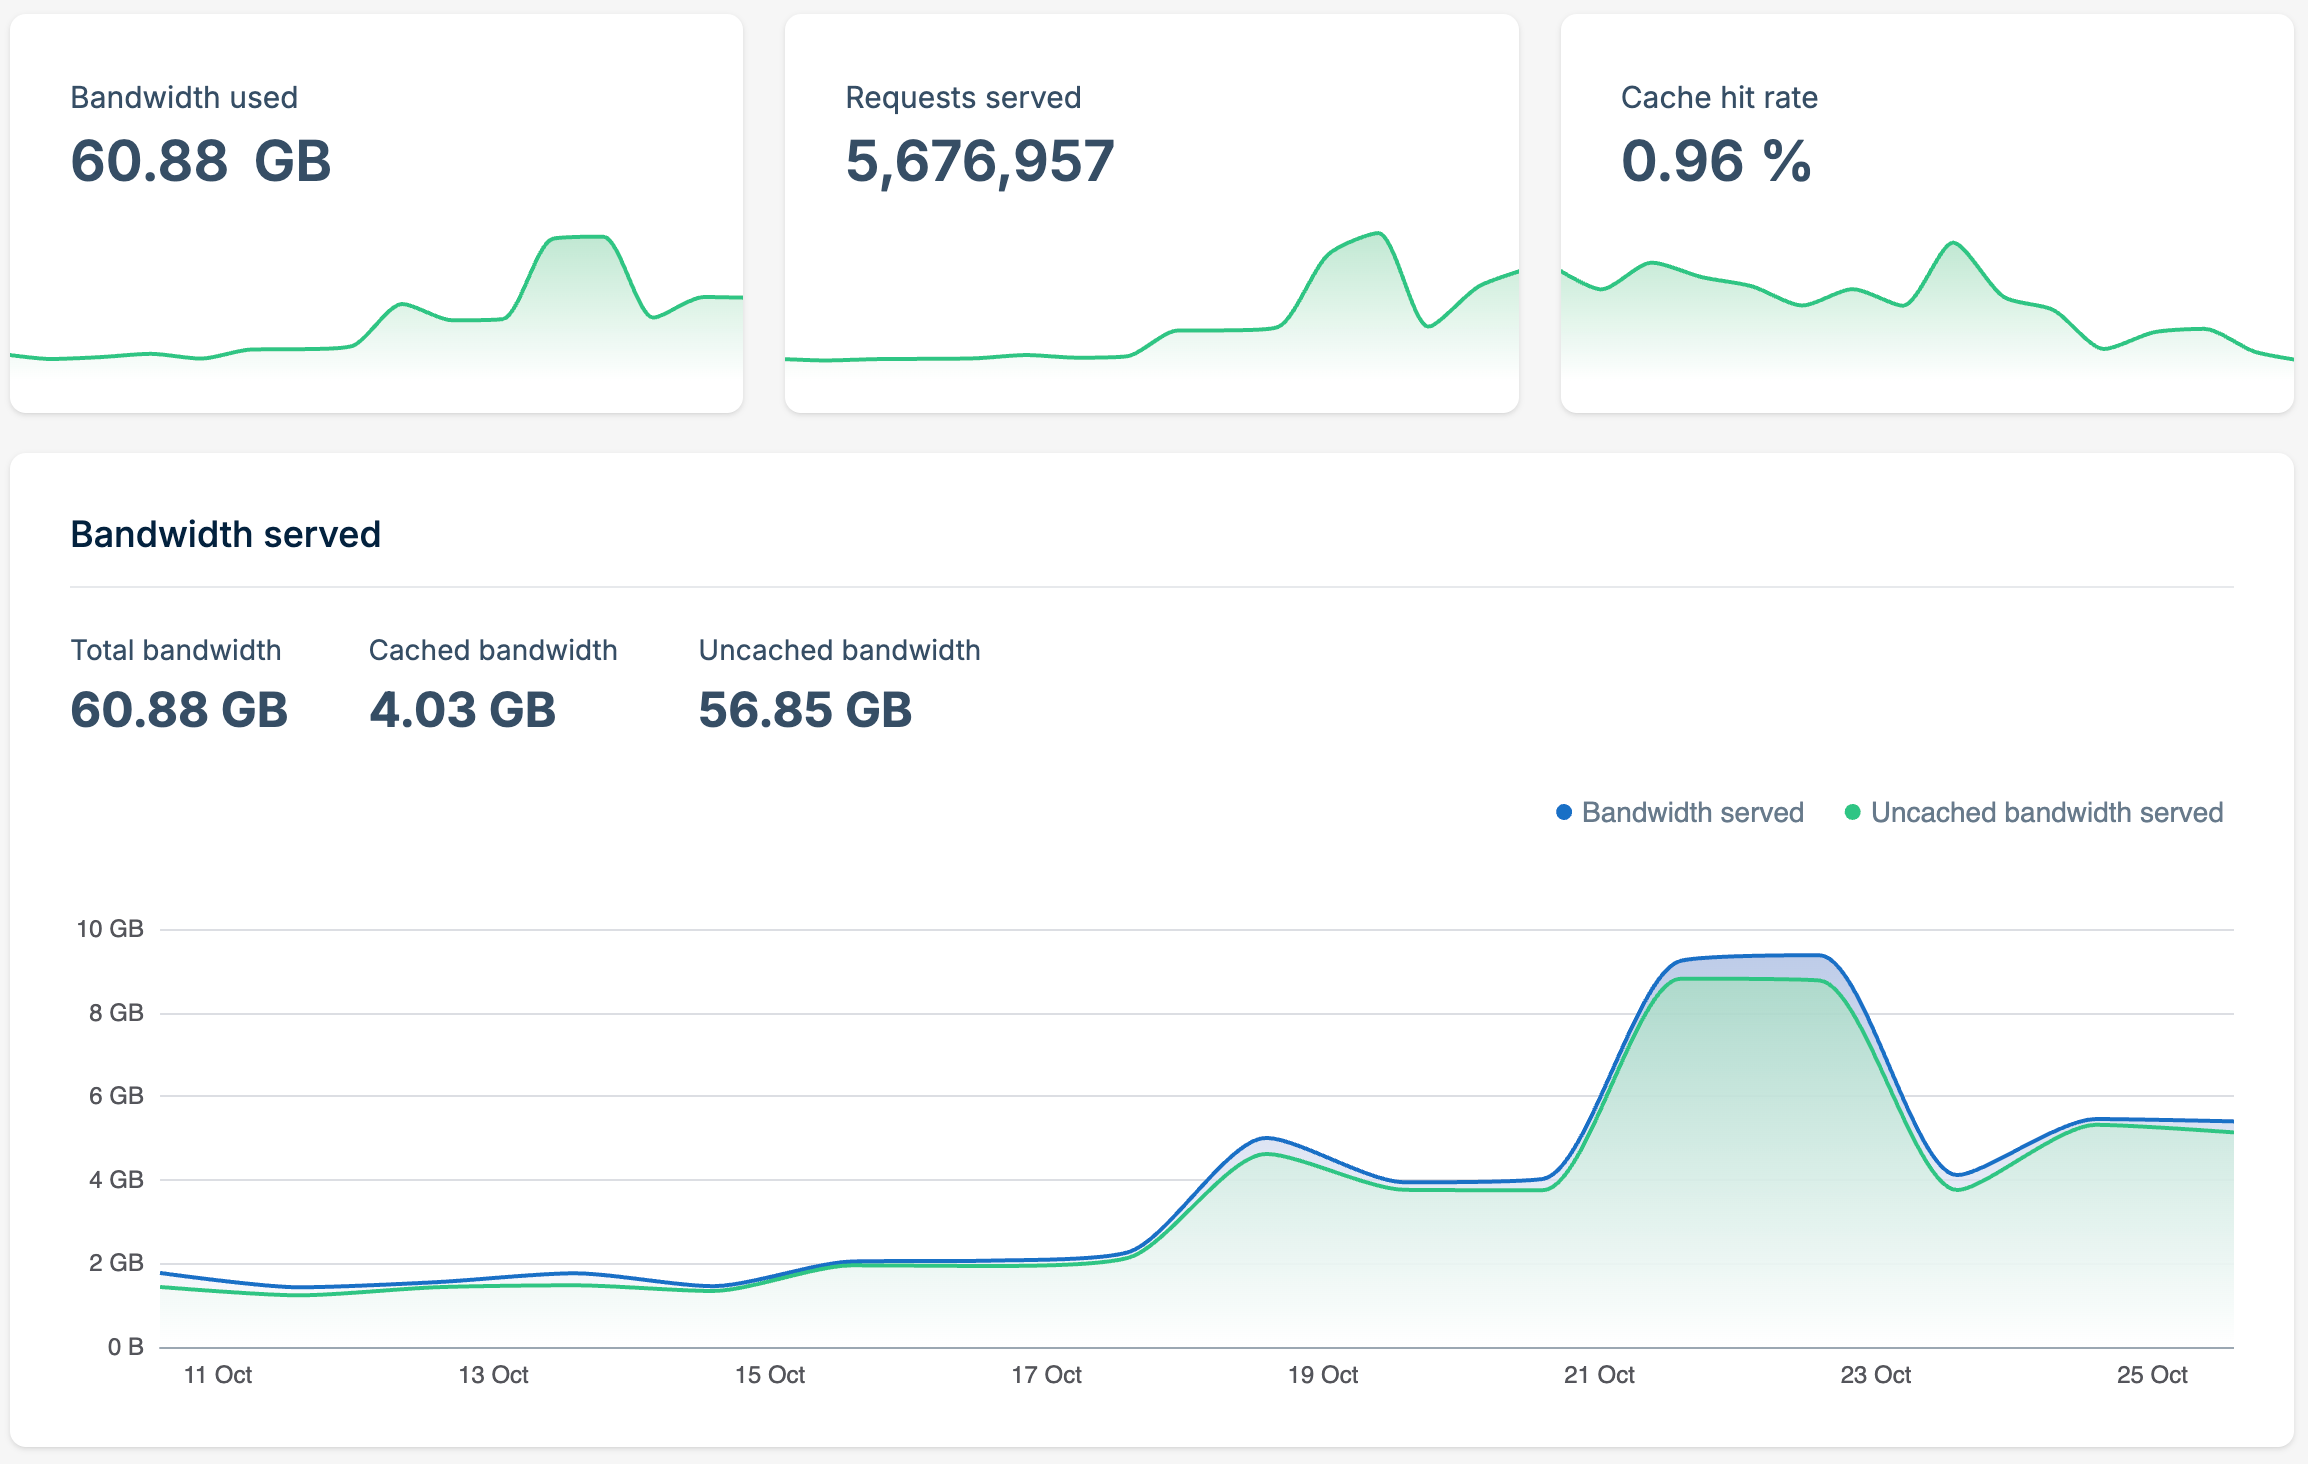
作者以自建Forgejo服务器遭爬虫疯狂抓取为例,揭示LLM公司无视道德与版权、大规模爬取网站内容:爬虫耗尽CPU与带宽、推高账单,UA校验、Cookie验证、WAF、Anubis等常规反爬手段均难奏效,Linux内核项目也被迫关闭commit页面渲染。作者指出爬虫可伪装TLS指纹、IP与浏览器,批评此类行为是“偷窃”,呼吁不要用金钱支持这些公司。
本文介绍了如何抓取受密码保护的网站,包括提取登录表单元素、使用Selenium自动登录、保存会话cookie和获取数据。首先,识别登录页面的用户名、密码和登录按钮的CSS选择器,然后使用Selenium进行登录并保存cookie,最后通过requests库获取所需数据。此外,还可以利用AI提取特定信息,如API密钥。
本文介绍了使用wget命令抓取整个网站的技巧,包括递归抓取、下载页面必需元素、避免抓取父级目录和转换链接为相对链接等。同时提醒注意内存使用,以防止OOM错误。
完成下面两步后,将自动完成登录并继续当前操作。