


声势浩大的知识产权盗窃
内容提要
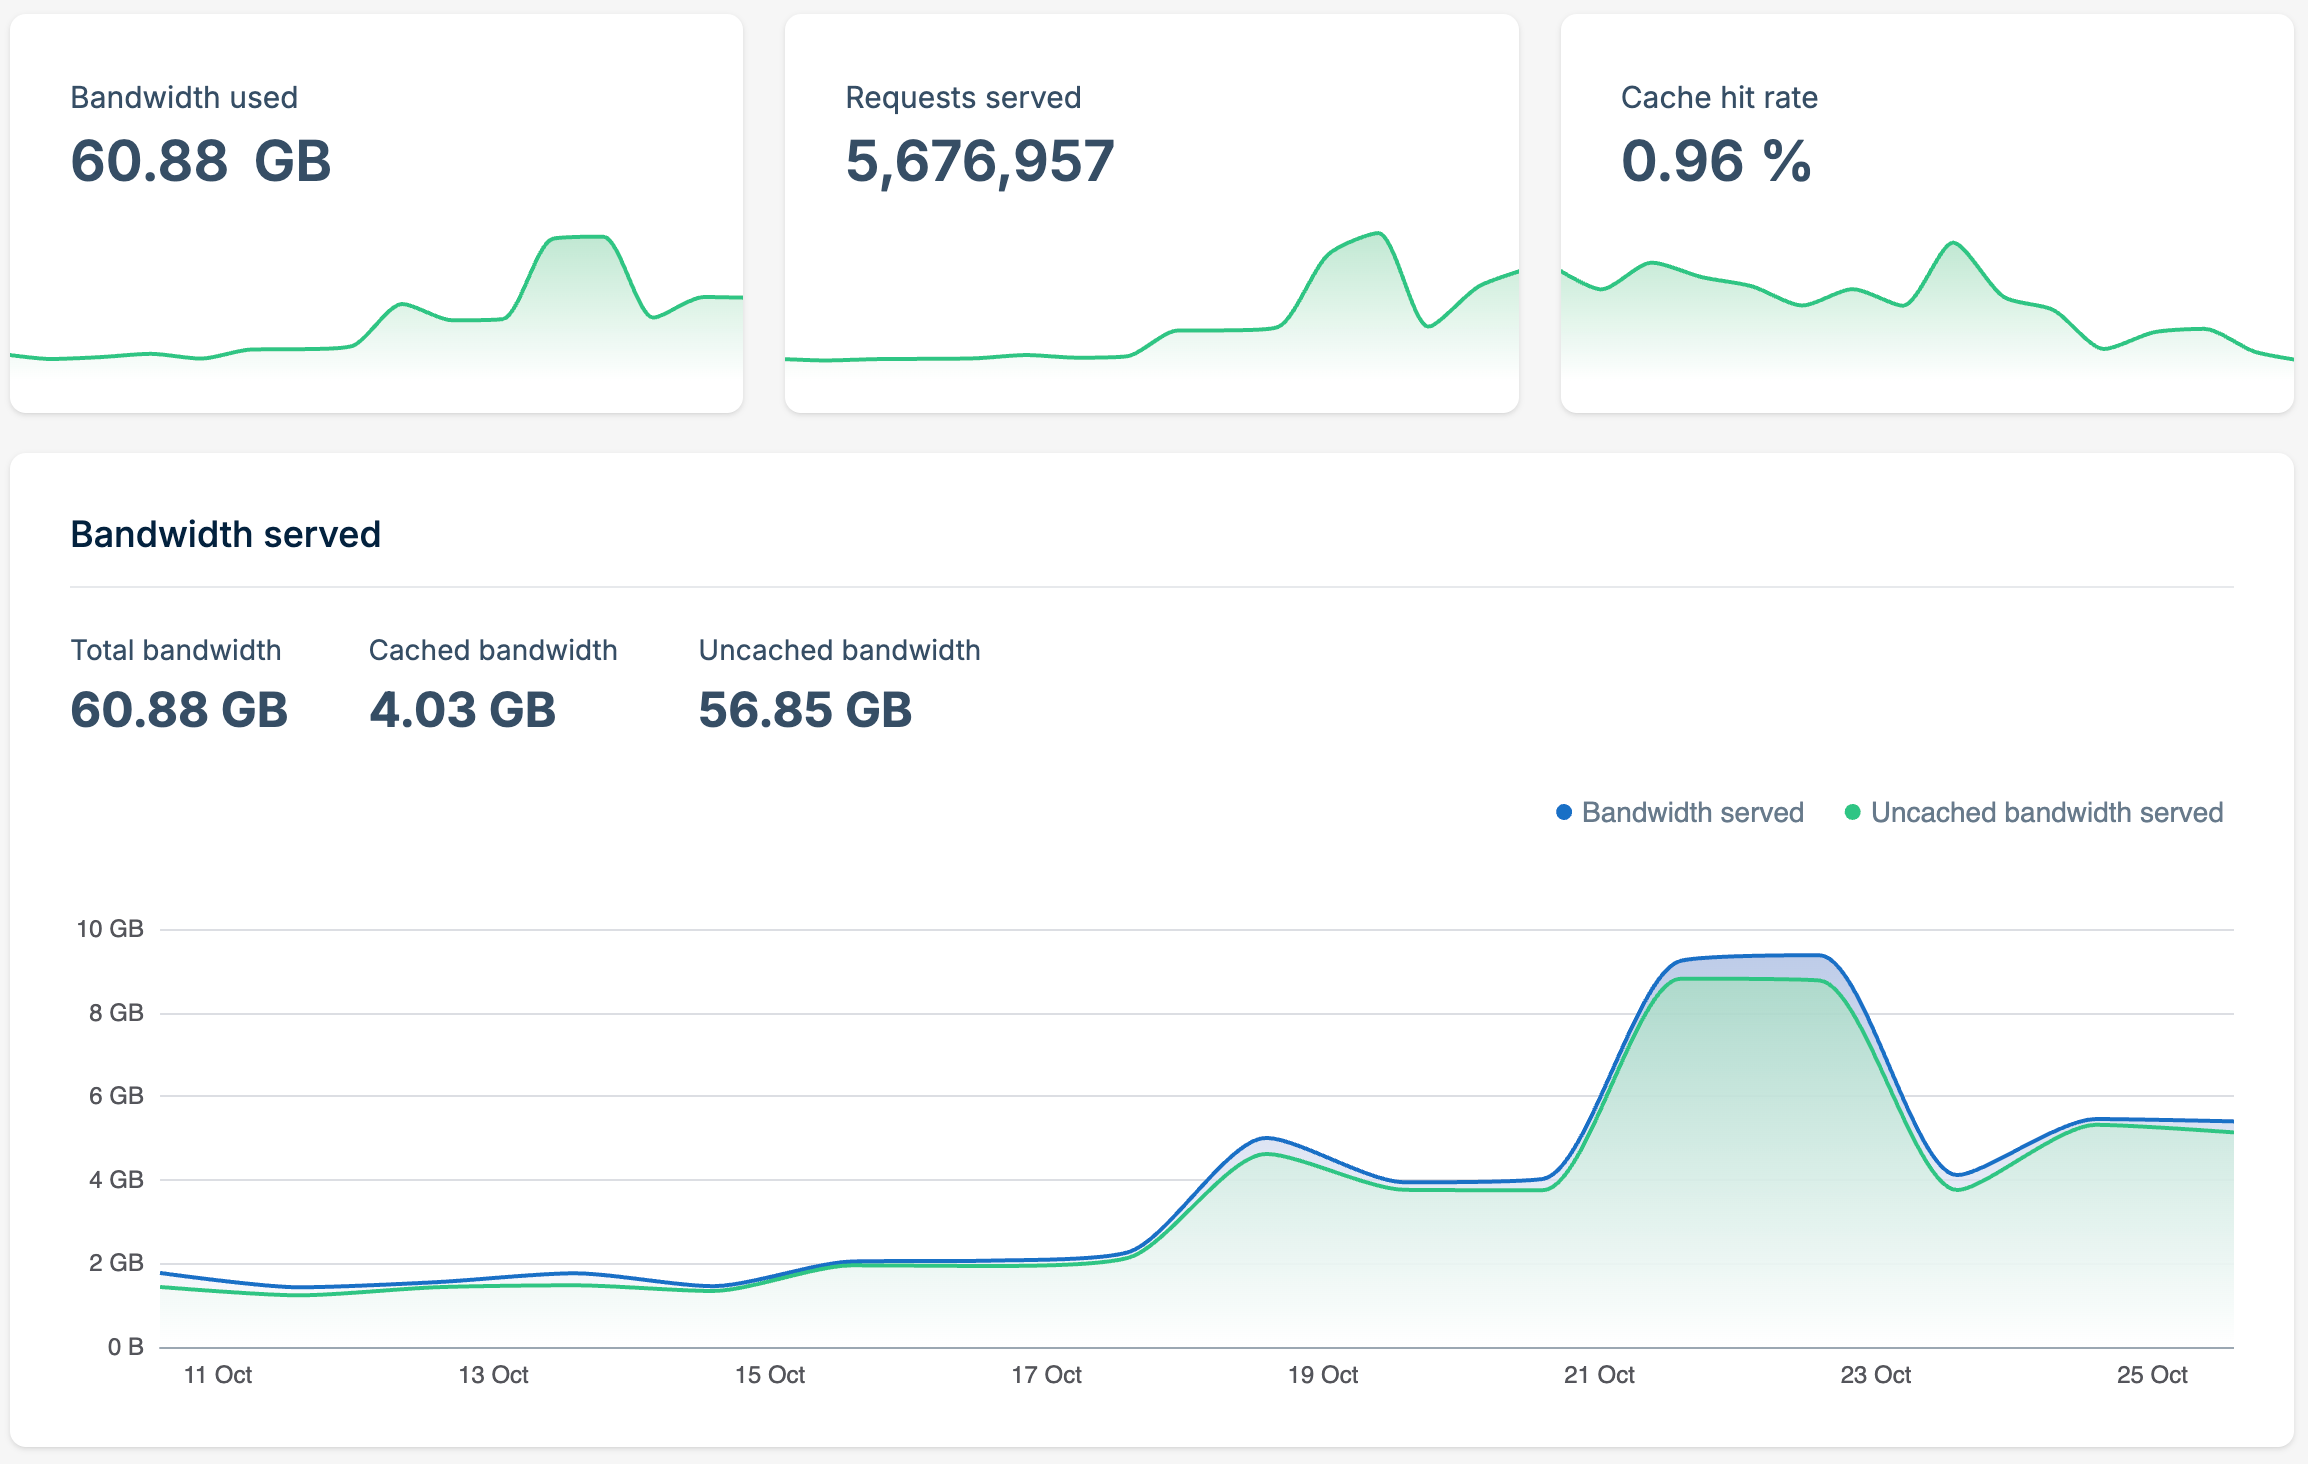
作者以自建Forgejo服务器遭爬虫疯狂抓取为例,揭示LLM公司无视道德与版权、大规模爬取网站内容:爬虫耗尽CPU与带宽、推高账单,UA校验、Cookie验证、WAF、Anubis等常规反爬手段均难奏效,Linux内核项目也被迫关闭commit页面渲染。作者指出爬虫可伪装TLS指纹、IP与浏览器,批评此类行为是“偷窃”,呼吁不要用金钱支持这些公司。
延伸解读
自建 Git 服务为何成为爬虫重灾区
文章指出,Forgejo 等自建 Git 服务器会为每个 commit、分支和版本生成压缩包并缓存,而爬虫会贪婪抓取每个链接,导致磁盘被 repo-archive 占满、CPU 和带宽飙升。Linux 内核项目同样因 commit 页面被爬而消耗 14 个 CPU 核心,超过真实用户 clone 所用资源。这说明公开代码托管页面天然暴露大量可枚举 URL,对 LLM 训练数据极具吸引力,站长需提前评估归档与渲染功能的资源风险。
常规反爬手段为何集体失效
作者尝试 UA 校验、Cookie 验证、WAF 严格规则和 Anubis PoW,均未挡住爬虫。原因在于爬虫可伪装 TLS 的 JA3 指纹、使用住宅代理 IP、运行无头浏览器执行 JavaScript 并完成高难度 PoW。文章还提到,Iocaine 默认规则仅匹配 User-Agent,几乎形同虚设。对站长而言,这意味着依赖单一特征的反爬策略很容易被绕过,而提高 PoW 难度又会误伤移动设备真实用户,形成两难。
关闭渲染与返回 200 的务实取舍
Linux 内核项目最终关闭 commit 页面渲染,作者也屏蔽了 commit URL,并故意返回 200 状态码,让爬虫误以为抓取成功,从而拿到无用的空壳内容。这种做法牺牲了部分页面可访问性,但能直接削减爬虫带来的 CPU 与带宽开销。文章借此说明,在猫鼠游戏难以取胜时,站长可能不得不放弃某些公开功能,把资源保护置于页面完整性之上,这是当前维护公开网站的一种现实妥协。
金钱支持背后的信号意义
作者批评 LLM 公司无视版权与道德大规模爬取,并提醒读者:无论直接订阅模型还是通过 OpenRouter 等分销商付费,都是在向市场发送容忍甚至支持这类行为的信号。文章承认完全避开 LLM 可能很难,但强调支持程度仍有区别。这一观点把技术层面的反爬讨论延伸到消费选择,提示读者在付费前思考服务商的数据获取方式是否与自身价值观一致。
Q&A
为什么自建的 Forgejo 服务器会成为 LLM 爬虫的重灾区?
因为人写的代码对 LLM 公司最有价值,而且即使是小型的 Git 服务器,各种 commit 和 branch 的 URL 也非常多,爬虫会贪婪地抓取每一个链接,导致资源消耗巨大。
作者尝试了哪些反爬措施?效果如何?
作者尝试了 UA 校验、Cookie 验证、WAF 严格规则、Anubis(PoW 挑战)和 Iocaine 等,但效果有限:WAF 仅导致自己加载不出 JS,爬虫仍猖獗;Iocaine 默认规则只匹配 User-Agent,几乎无效;Anubis 提高 PoW 难度也未能挡住爬虫,反而影响真实用户。
Linux 内核项目是如何应对爬虫的?结果怎样?
Linux 内核项目使用 Anubis 挡住爬虫,并不断提高 PoW 难度,但爬虫仍用无头浏览器硬解,最终无奈关闭了 commit 页面的渲染。
爬虫如何伪装成真实用户来绕过反爬?
爬虫可以伪装 User-Agent、TLS 指纹(如 JA3)、使用住宅代理 IP,甚至用无头浏览器执行 JavaScript 和存储 Cookies,从而看起来完全像真实用户。
作者为什么将 LLM 公司的爬取行为称为“偷窃”?
因为 LLM 公司无视道德与版权,大规模爬取网站内容,导致服务器承受压力、站长承担高额账单,且不遵守训练数据的授权协议,既无视法律又无视道德。
作者对读者有什么建议?
作者提醒读者,通过任何渠道(直接订阅或通过 OpenRouter 等分销商)给 LLM 公司提供金钱,都是在向市场发送容忍和支持这种行为的信号,应尽量避免用金钱支持这些公司。
