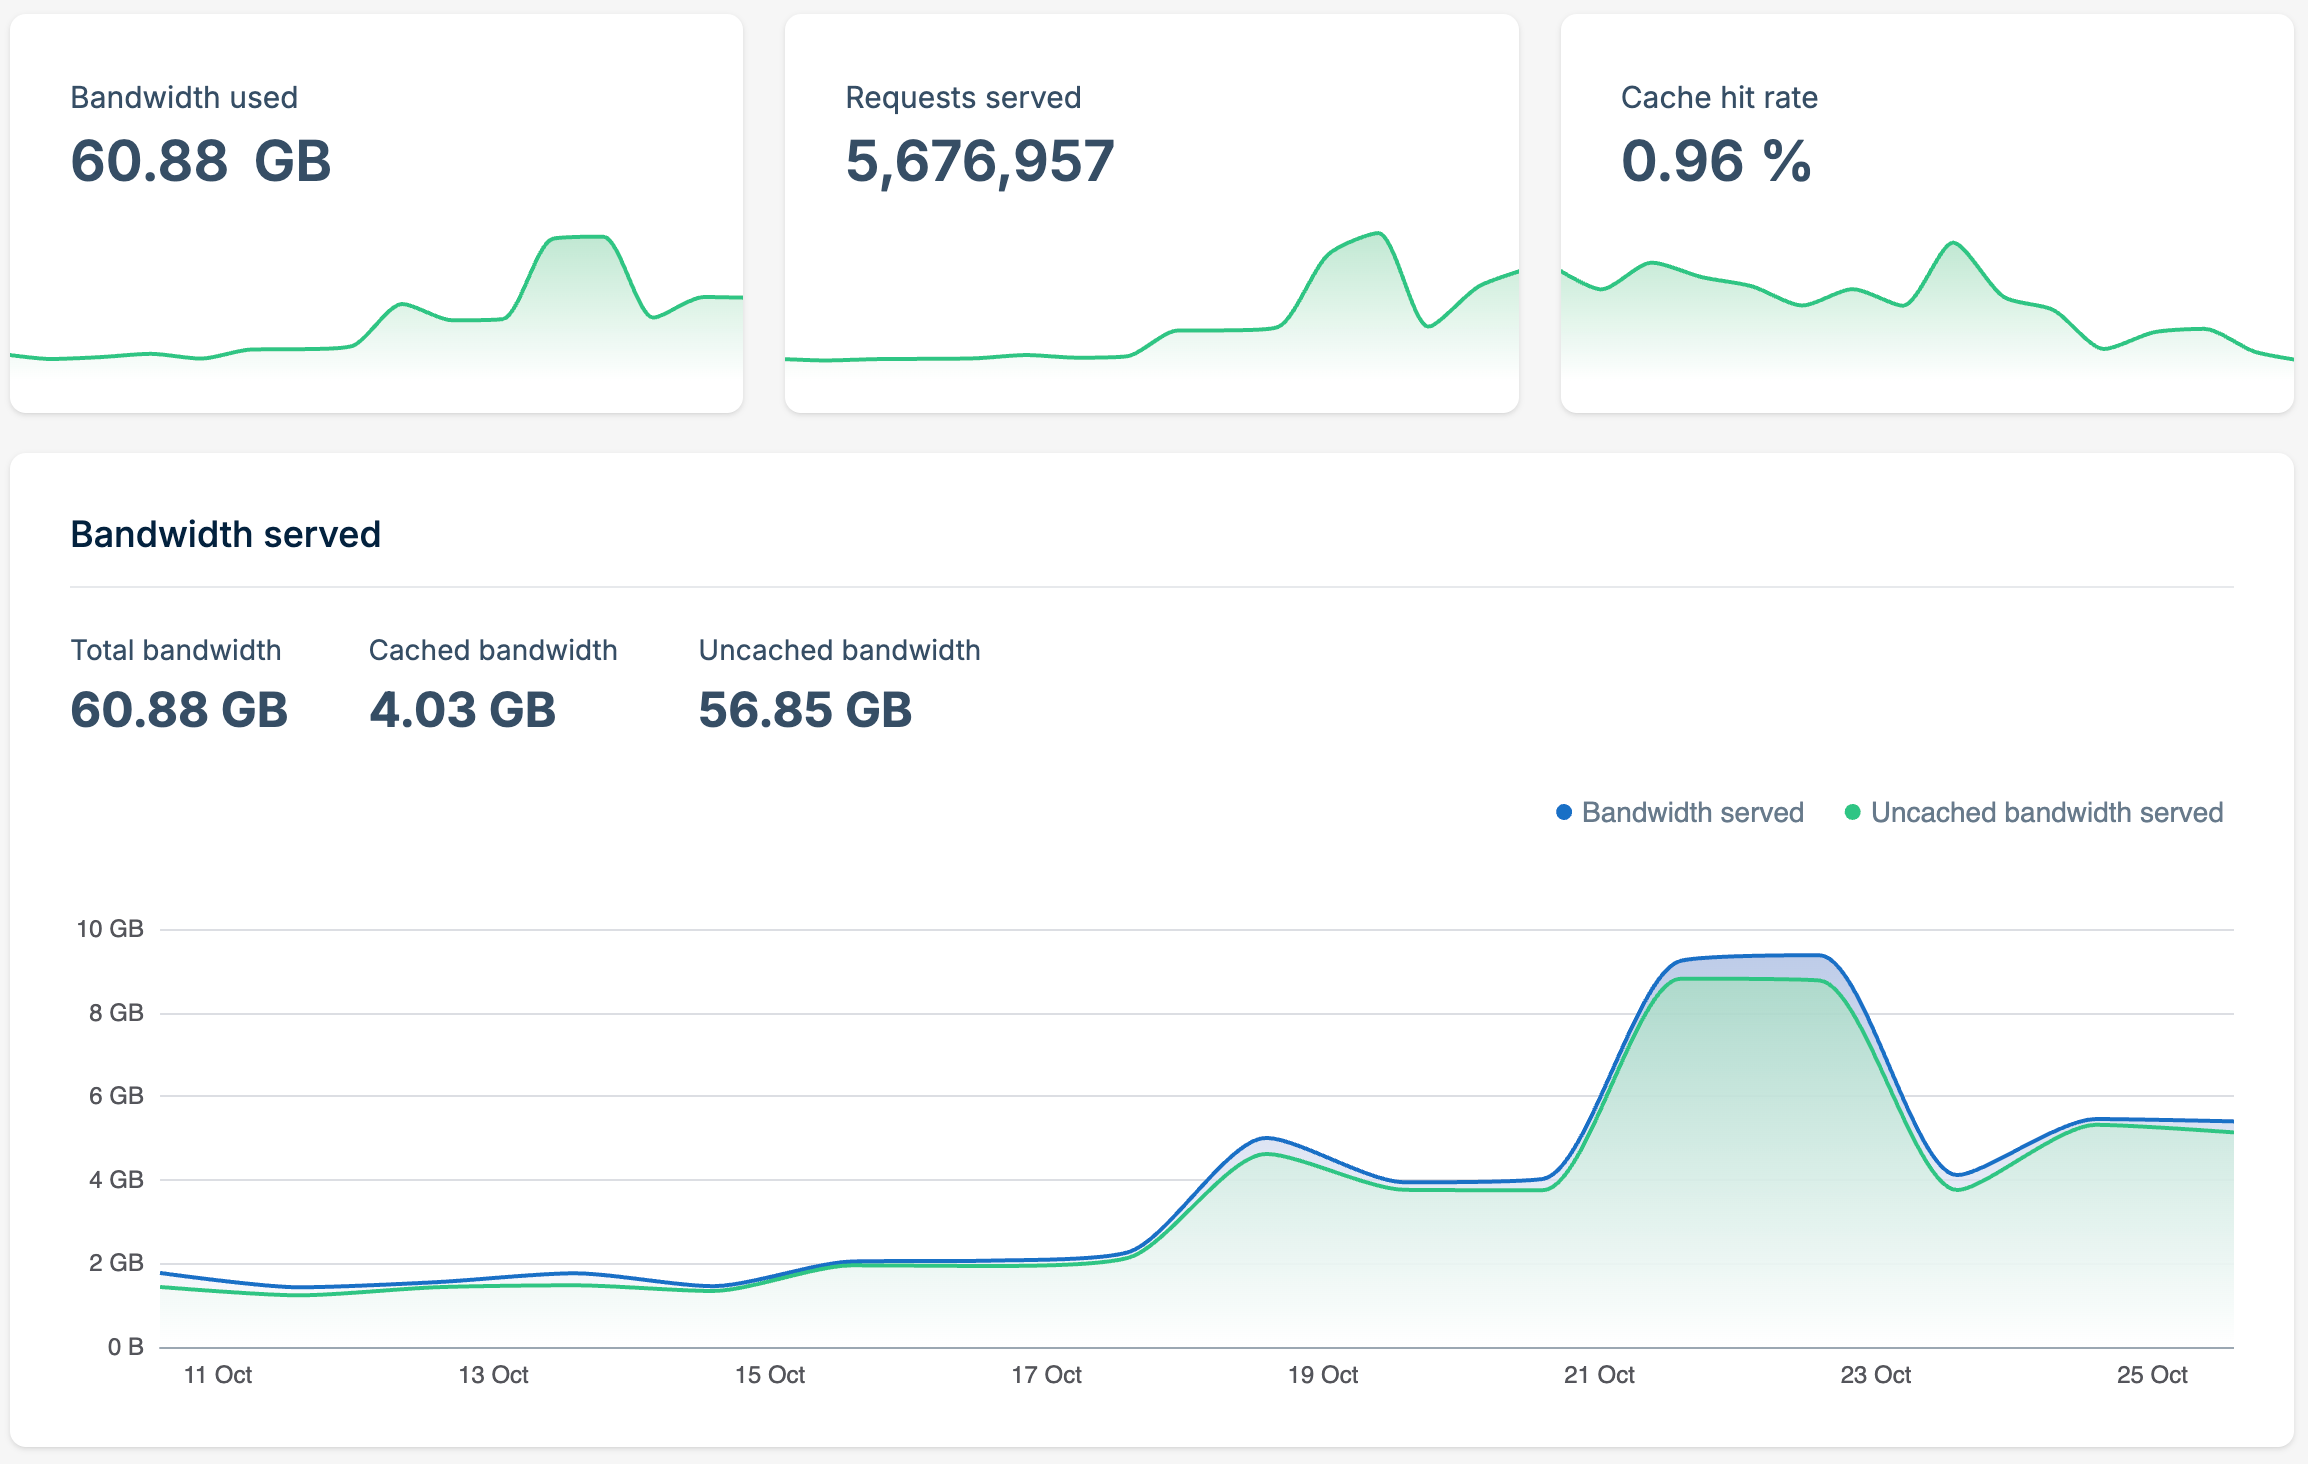
作者以自建Forgejo服务器遭爬虫疯狂抓取为例,揭示LLM公司无视道德与版权、大规模爬取网站内容:爬虫耗尽CPU与带宽、推高账单,UA校验、Cookie验证、WAF、Anubis等常规反爬手段均难奏效,Linux内核项目也被迫关闭commit页面渲染。作者指出爬虫可伪装TLS指纹、IP与浏览器,批评此类行为是“偷窃”,呼吁不要用金钱支持这些公司。
作者介绍开源插件 dsh-image-hunt,可让 agent 自动搜图、下载并作为会话附件显示。插件提供搜索、下载、校验尺寸等工具,支持百度、Bing、Pixiv 等 14 个图源及别名,具备并行抓取、轮转合并、去重能力,国外源走代理。文章还详述百度 JSON 异常、booru 标签、Pixiv Referer、后缀与尺寸失真等问题,并强调不绕过登录与付费墙、不保证图片授权,版权归原作者。
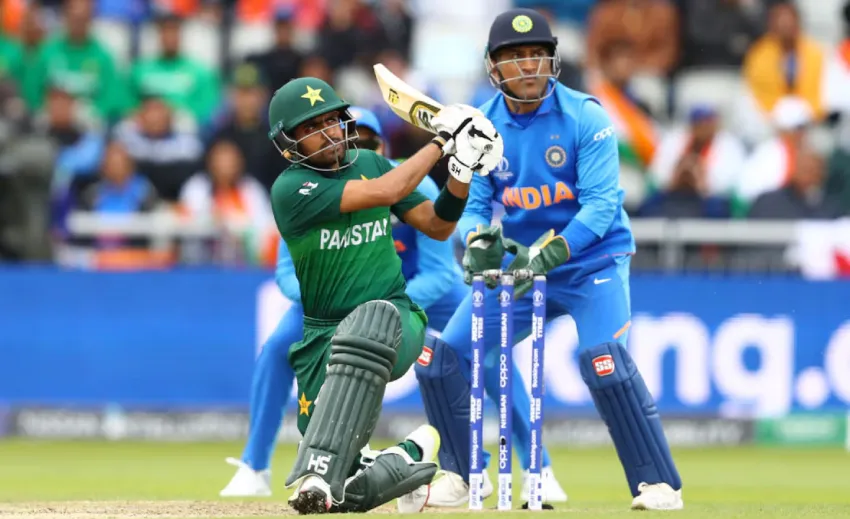
亚洲体育转播权格局生变,流媒体平台今年将支付约57亿美元版权费,占区域总额一半,高于2021年的36%。JioHotstar、腾讯等巨头瓜分市场,但版权费增速预计放缓,亚洲体育经济人均收入远低于北美。
ElevenLabs发布Music v2.5,盲测显示其在R&B、摇滚等曲风上更受偏好。用户保留生成曲目全部权利,免费版每日5次无损下载,Pro版每月400次。平台禁止模仿现有音乐人。新模型已上线API,训练数据仅称使用授权素材,与UMG协议无关,与Suno形成对比。
动漫反应类YouTuber与版权公司Remove Your Media发生冲突。该公司以DMCA为由大量投诉创作者,称其视频完整展示受版权保护内容、损害市场,不属合理使用。创作者主张反应视频具转化性、受合理使用保护,并指责投诉草率。YouTube表示不裁定版权归属,仅要求双方通过反通知解决。事件凸显创作者经济中版权执法趋严。
特朗普政府介入《纽约时报》起诉OpenAI的版权案,支持AI训练使用受版权保护作品属合理使用,称此举符合宪法促进科学进步的目标,若限制将损害美国繁荣。此案或为其他媒体与AI公司纠纷定下先例,此前已有媒体胜诉获赔,也有多家媒体与OpenAI达成授权协议。
作者反思了开源社区对LLM生成代码的争议,指出SuperCMD未修复问题,转而推荐有明确AI政策的vicinae项目。他列举了反对LLM的理由,如版权不明、信任危机、资源消耗和代码质量下降,但也承认其短期效率。最终认为LLM生成内容不应公开发布,因版权归属不清,但可容忍有限使用。
谷歌正与好莱坞制片厂洽谈,拟支付巨额费用获取版权内容以训练AI模型,如向迪士尼支付数亿美元,旨在提升Gemini等AI生成内容的合法性与公众接受度。制片厂面临劳工失业和观众反感等风险,需权衡短期利益与长期声誉。
X向开源前端Nitter发出停止函,要求关闭实例并删除代码库。Nitter曾允许无账号阅读X帖子,但2024年因X关闭访客权限而失效,后改用真实账号恢复。X指控其违反规则、绕过API,但法律上违反平台规则不等于违法。GitHub对规避版权索赔有审查流程,目前代码仍可查看和分叉。
MIT CSAIL研究发现“归因衰减”现象:生成式AI模型训练数据规模越大,单个训练样本对输出的影响越小。通过精确删除数据验证,大型模型中移除任何单张图片、某艺术家全部作品或某人所有照片,生成结果几乎不变。该发现对版权归属、合理使用等法律问题有重要影响,表明模型输出可能无法归因于特定训练数据。
Oracle禁止AI生成代码进入OpenJDK,表面是技术质量担忧,实为版权诉讼布局。作为靠法律盈利的公司,Oracle需避免因接受AI代码而削弱未来起诉侵权的能力。同时,AI代码版权归属不明、可能侵犯开源许可,且增加维护负担。此举反映其对外推广AI、对内严控的矛盾,执行虽难,但意在设防。
Suno宣布将实施新水印技术和下载政策,以限制AI生成音乐的滥用并提高透明度。CEO Mikey Shulman表示,新措施符合行业标准,便于识别Suno内容,并计划与分发平台合作打击欺诈。此前,公司因与华纳音乐和解,将下载限制为付费订阅用户,每月限量。Shulman强调尊重版权和人类艺术,但避免评判作品价值,具体细节尚未公布。
Anthropic公司实施“巴拿马计划”,斥资数千万美元购买旧书,切脊扫描后打成纸浆,用于AI训练。此举因法律上仅购买一份并销毁原件,被视为“转换性使用”而合法,但公众反感,需保密。核心是版权规则滞后,旧书(2022年前)被视为干净训练数据,避免模型崩塌。
艺术家们正就AI未经许可使用其作品提起诉讼,部分已获胜。作家、插画师和音乐人指控AI公司侵犯版权或违反服务条款,如Anthropic因盗用电子书赔偿15亿美元。尽管法院对“合理使用”有分歧,但艺术家们认为法律和舆论正倾向他们,同时担忧AI会损害独立创作者的生计。
Anthropic公司实施“巴拿马计划”,购买并销毁上百万本旧书,扫描成数字文件供AI训练,以获取高质量数据。法官裁定此举合法,因未复制扩散。此举引发伦理争议,被视为现代版“焚书”,虽法律合规,但不可逆地损失了实体文化遗产。
Debian社区正讨论是否禁止AI提交代码,现有四项提案:A全面禁止,因版权和质量问题;B和D允许但要求贡献者负责并披露;C倾向拒绝但承认完全禁止不现实。讨论至2026年7月24日,尚未定论,反映开源社区对AI态度分裂。
Meta因使用AI裁员被起诉,原告称其算法未考虑法律保护的假期和残障状态,导致不公裁员。Meta否认指控,称决策由人类做出,原告寻求禁令和独立审计。
知名开源项目WeFlow因收到DMCA通知,已删除代码和安装包。该工具用于提取微信聊天记录解密密钥,帮助用户备份聊天记录。开发者表示将停止更新,无法再提取密钥或解密数据库,新功能仅允许用户回忆聊天记录,符合服务协议。
开源模块哔哩漫游因侵犯B站版权被要求删除。该模块用于解除番剧区域限制和去广告,B站要求开发者停止侵权并删除相关代码,以维护平台秩序。
字节跳动近期登记了多个热门表情包的著作权,引发网友对版权归属的担忧。网友认为这些表情包是集体创作的,担心未来的二次创作受到限制。字节的举动可能与AI训练和内容保护有关,尽管法律上并不违法,但仍存在争议。互联网的开放共创与大厂的商业利益之间的冲突将持续。
完成下面两步后,将自动完成登录并继续当前操作。