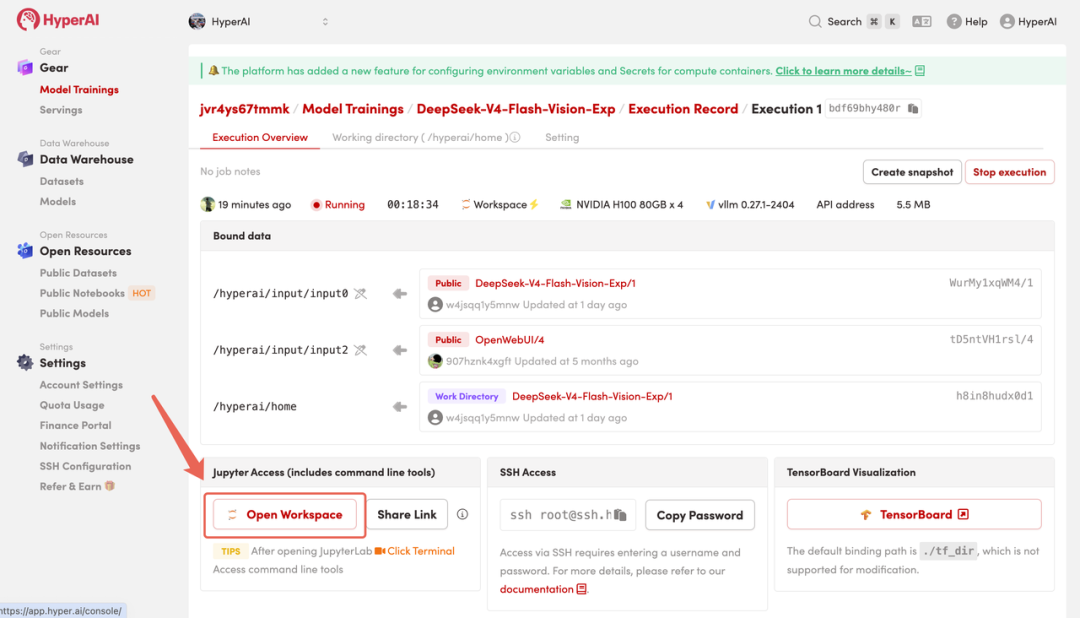
DeepSeek发布首个多模态实验模型V4-Flash-Vision-Exp,新增视觉理解能力,可处理图像图表等复杂任务,性能提升至36.5,多模态评测表现优异。HyperAI已上线部署教程,支持一键运行。
DeepSeek推出多模态模型deepseek-v4-flash-vision-exp,新增视觉理解能力,支持图片输入,提升多模态Agent任务表现。模型延续V4-Flash文本能力,定价按token计费,图片最高换算384 tokens。同步推出Files API,支持文件复用,降低开发者调用门槛,推动Agent从文本处理走向复杂任务执行。
DeepSeek发布多模态视觉理解模型V4-Flash-Vision-Exp,上线API平台,补齐视觉能力。该模型纯文本能力与V4-Flash持平,多模态Agent能力接近Opus-4.8,支持PPT生成、网站重构等场景。API按token计费,图片最多384 tokens,价格与V4-Flash一致,并推出免费Files API,降低开发者接入门槛。
Kimi K3 是一款新发布的开源模型,参数达到 2.8 万亿,全球排名第一,超越多款闭源模型。它在前端编程、视觉理解和交互设计方面表现出色,经过百万用户的盲测验证。K3 的技术创新包括混合线性注意力和注意力残差,提升了处理能力。尽管整体表现仍落后于顶级闭源模型,但在编程领域已具竞争力,定价策略有望挑战市场。
Kimi K3是Moonshot AI推出的开源模型,支持文本、图像和视频输入,具有1M-token上下文窗口和视觉理解能力,适用于前端开发、游戏开发和CAD工作流,能够进行深度推理。用户可通过AI SDK使用K3,并在AI Gateway上跟踪模型使用情况和成本。
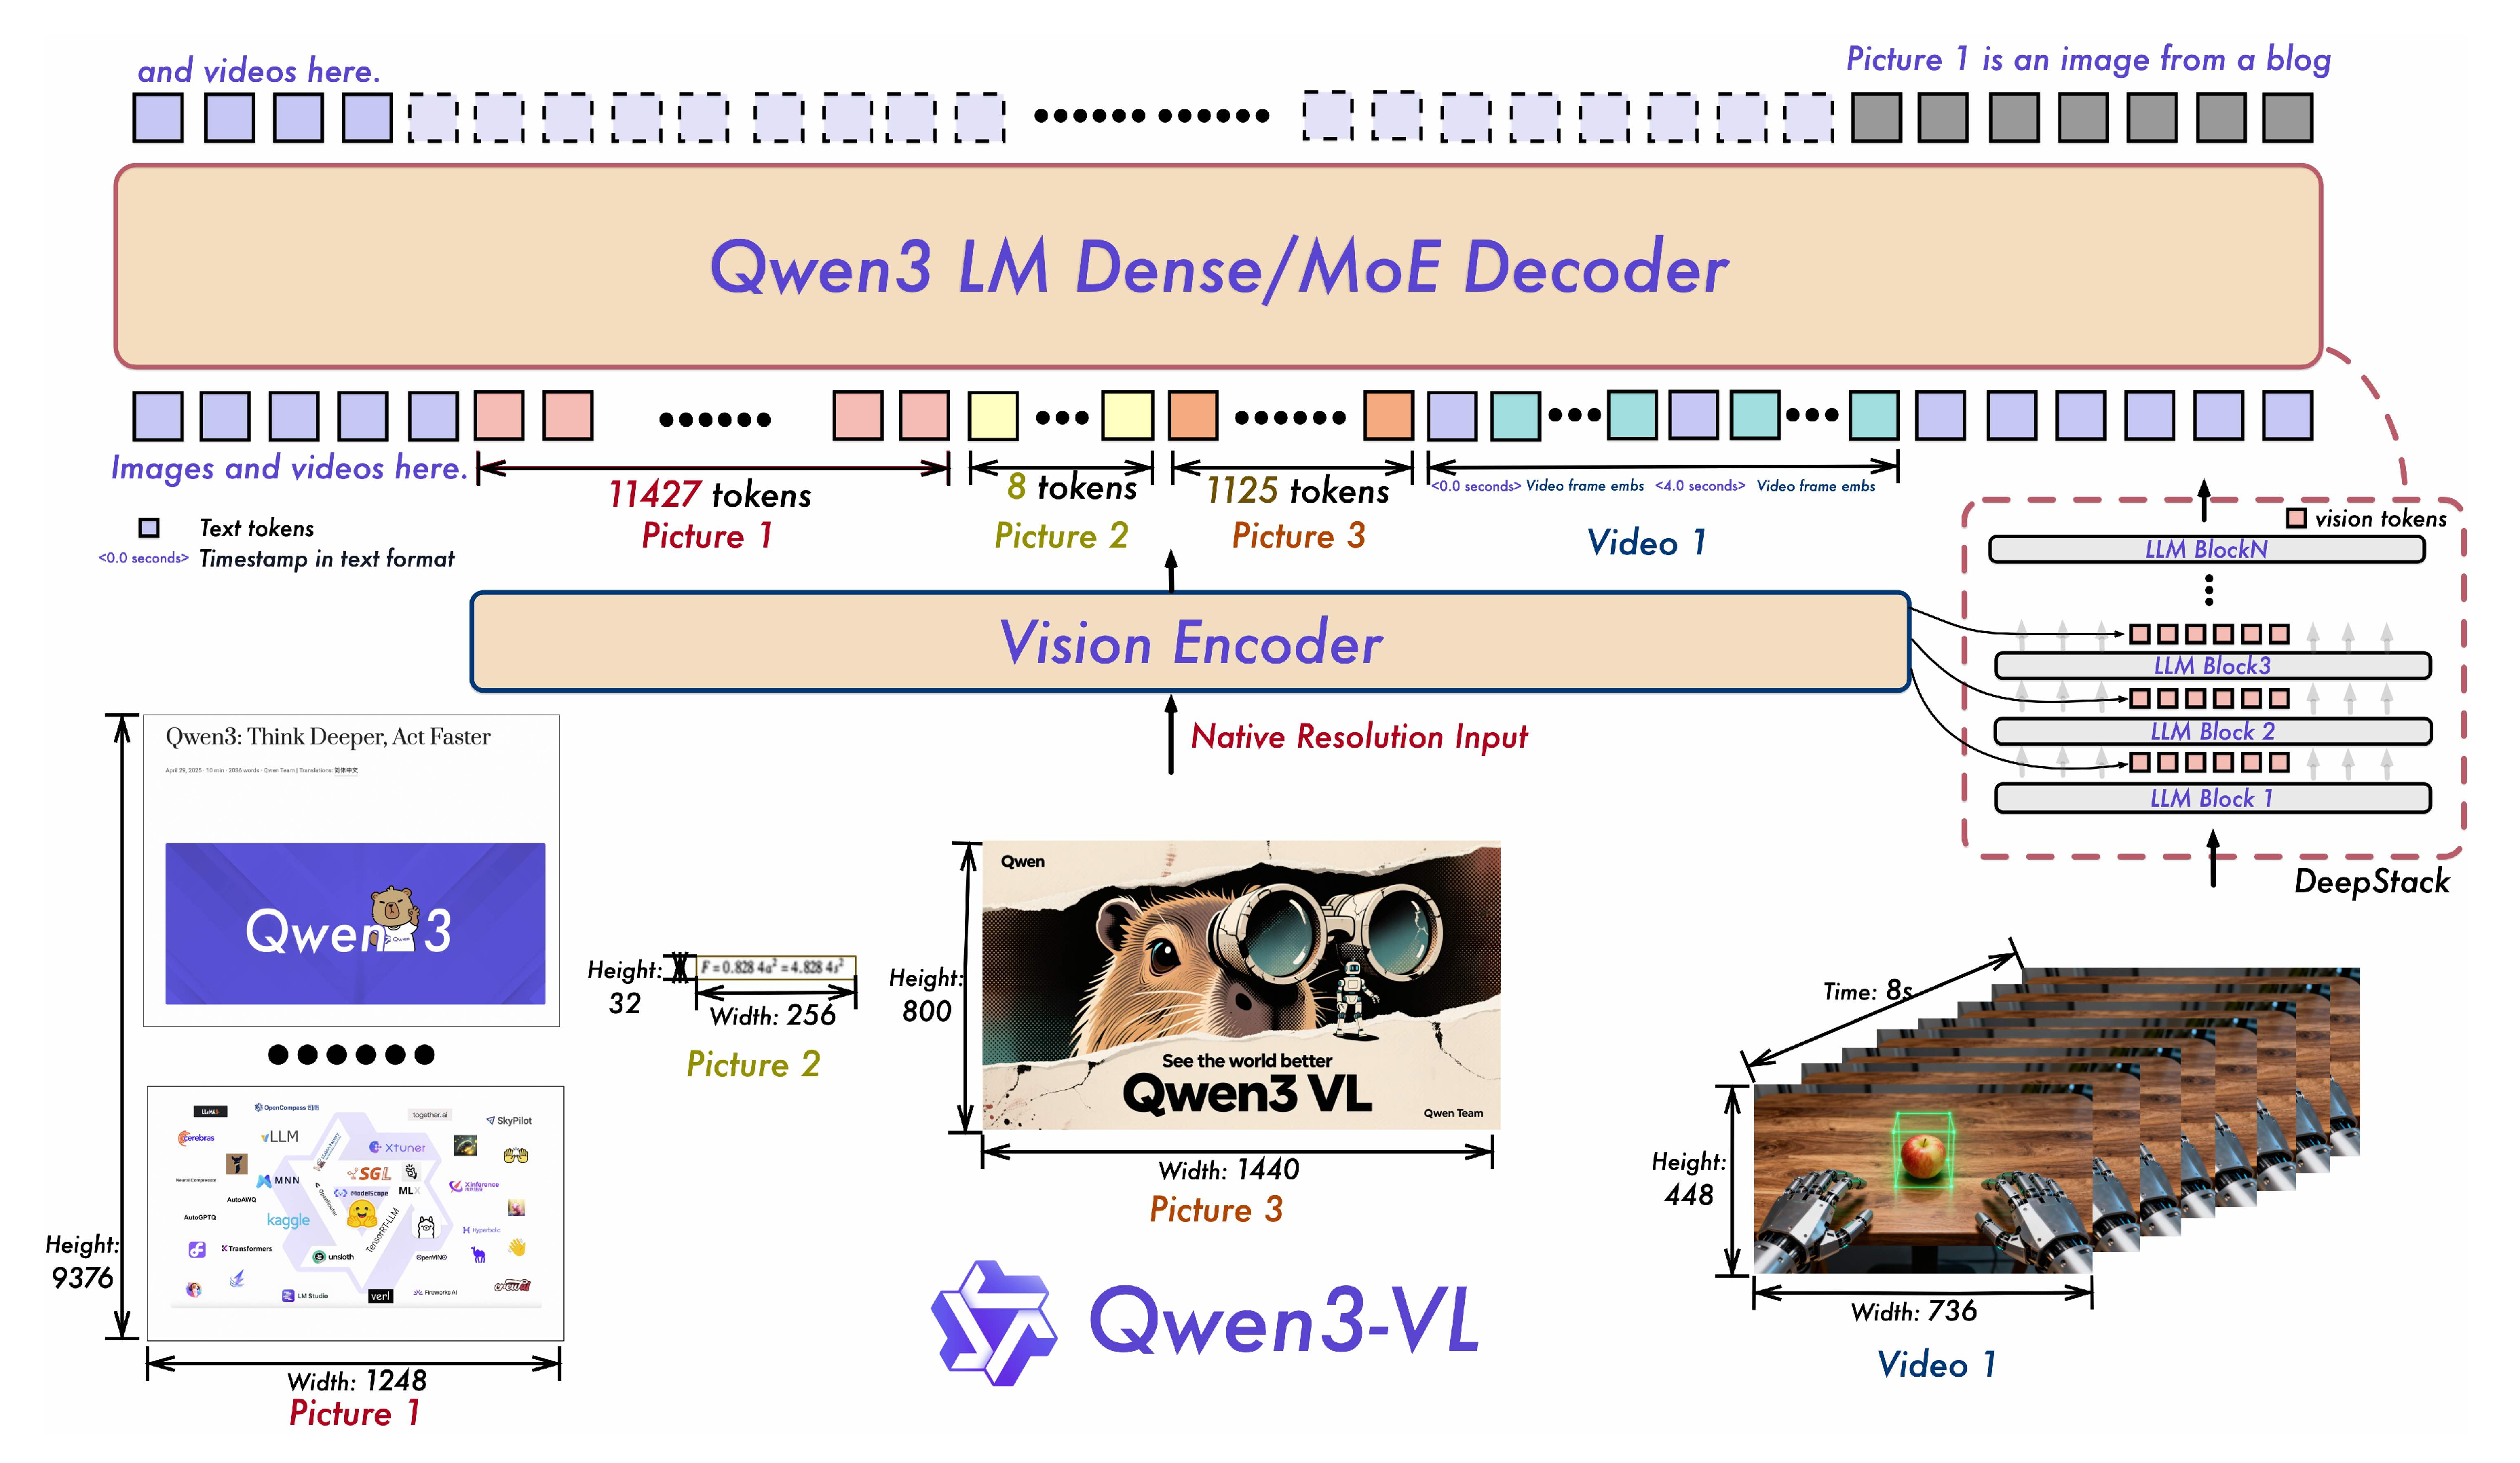
Qwen系列模型最新升级为Qwen3-VL,在视觉理解和视频处理方面有显著提升。引入多维旋转位置编码(MRoPE)和DeepStack技术,增强了对复杂场景的推理能力,支持长文档和长视频处理,具备更高的上下文长度和精确的时间定位能力,推动多模态理解的进步。
本文介绍了一种视觉自监督学习方法——文本条件JEPA(TC-JEPA),该方法通过图像标题减少特征预测的不确定性。TC-JEPA利用细粒度文本调节器,使图像特征更具语义意义,从而提升下游任务的表现和训练稳定性。该方法在视觉理解和推理任务中优于对比学习,展示了新的基于特征预测的视觉-语言预训练范式。
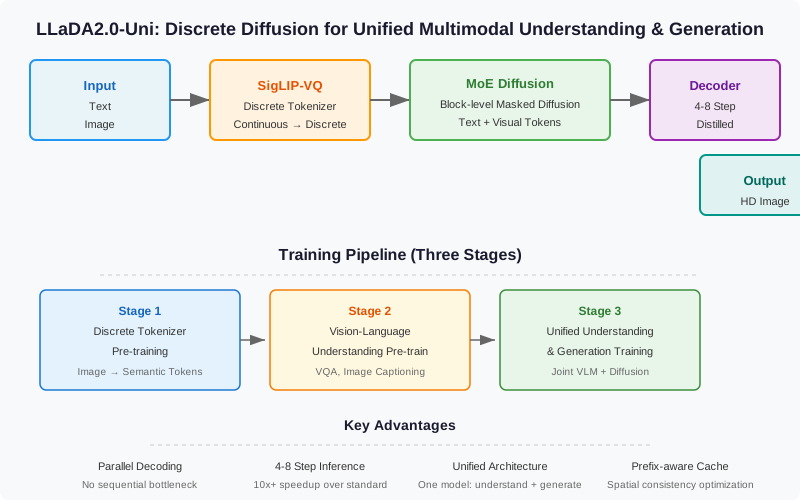
蚂蚁集团的论文《LLaDA2.0-Uni》提出了一种离散扩散语言模型,旨在统一视觉理解和图像生成。该模型通过将图像压缩为离散语义token,并利用混合专家架构实现文本和视觉token的并行处理,显著提升推理速度。LLaDA2.0-Uni在视觉理解和图像生成任务上表现优异,展现出理解与生成的连续交互能力。
Qwen团队推出了新版本Qwen3.6-27B,这是一个拥有270亿参数的多模态模型,支持视觉和文本理解。该模型在多个编程基准测试中表现优异,超越了前代版本,并在推理任务上取得了高分。HyperAI官网提供了快速部署该模型的教程。
谷歌推出了Gemini Robotics-ER 1.6,这是一个升级的机器人模型,具备更精准的物理环境理解能力,增强了空间逻辑和多视角理解,提升了自主性,尤其在视觉理解、任务规划和成功检测方面表现优异。此外,该模型能够读取复杂仪表,并且是迄今为止最安全的机器人模型,符合安全政策。开发者可通过Gemini API和Google AI Studio访问该模型。
谷歌发布的Gemma 4开源模型在视觉理解和代码生成方面表现优异,尤其是26B版本。尽管小模型在视觉处理上有所欠缺,但在文本理解和代码生成方面依然表现良好,突显了表达能力在AI应用中的重要性。
微软与清华提出BiPS模型,通过训练阶段教会模型关注关键视觉细节,解决视觉-语言模型在推理中的错误。BiPS利用“拉”和“推”机制,提升视觉理解能力,使模型在复杂任务中更准确地识别信息,推动通用智能的发展。
Kimi K2.5是Moonshot AI最新的智能模型,支持无账户访问,具备强大的编码和视觉理解能力,能够创建动态用户界面。使用时需在AI SDK中设置为moonshotai/kimi-k2.5,AI Gateway提供统一API,支持跟踪和性能优化。
智谱AI与华为联合研发的GLM-Image多模态图像生成模型已开源,打破了海外模型的垄断。该模型在国产芯片上完成全流程训练,支持文本生成图像、图像编辑和风格迁移,具备高质量的视觉理解能力。
文心5.0正式发布,参数达到2.4万亿,具备全模态能力,表现优异。其在文本和视觉理解方面多次夺冠,展现出强大的知识整合与创造力。通过原生全模态建模,提升了理解与生成的协同能力,已广泛应用于多个行业,未来发展值得关注。
OpenAI 发布了 GPT-5.2 模型,强调职场实用性,提升了编程、长文本处理和视觉理解能力,显著节省用户时间。该模型在多个专业任务中超越人类专家,并在数学和科学问题上取得进展。此外,OpenAI 与迪士尼合作,计划推出成人模式,展现其商业化策略。
智谱推出GLM-4.6V系列多模态大模型,包括基础版和轻量版,支持128k tokens上下文窗口,具备原生工具调用能力,优化视觉理解。相比前代,价格降低50%,并提供免费轻量版。该模型在多模态任务中表现优异,开源资源已在主流社区发布,便于开发者集成。
快手推出了Keye-VL-671B-A37B多模态大语言模型,具备强大的视觉理解和视频感知能力,能够准确识别图像和视频细节并进行复杂推理,表现优于同类产品。未来将增强多轮工具调用能力,推动更深层次的视觉思考与推理。
阿里千问的视觉理解模型Qwen3-VL和Qwen2.5-VL在最新空间推理基准测试中表现优异,超越Gemini 3和GPT-5.1等国际顶尖模型,但仍未达到人类80分的基准。Qwen3-VL在视觉感知和多模态推理方面取得重大突破,已开源不同版本并上线千问APP供用户体验。
字节AI推出的新模型Doubao-Seed-Code在Agentic编程任务中表现卓越,支持视觉理解,能够根据UI设计生成代码,并快速解决各种问题。火山引擎还提供低成本套餐,推动AI编程进入“咖啡时代”。
完成下面两步后,将自动完成登录并继续当前操作。