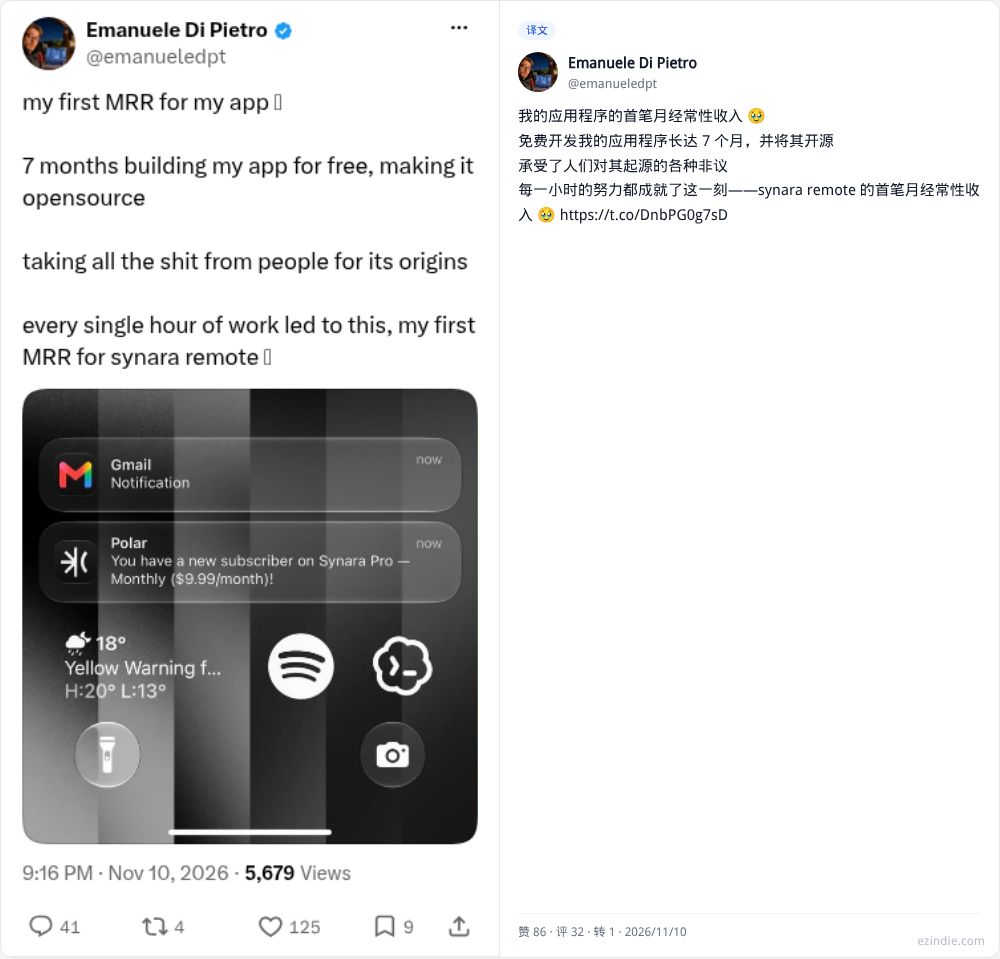
本期周刊聚焦独立开发变现案例:Thumbwise在Mac上整理iPhone桌面,10天收入464美元;Glitter AI做AI SOP工具,2.5年月经常性收入1.82万美元;AI视频代运营零设备月入3.8万美元;Bundle.ink结合稍后读与AI闪卡抗遗忘;Synara开源7个月获首笔收入;Skyfall AI用AI CEO运营3家公司;另有TrendShift、sure等开源工具。
SwiftDL 是一款 MIT 开源全平台下载器,支持 Windows、macOS、Linux,最多 32 连接并行下载,具备动态分片、预分配空间、断点续传,并支持种子和磁力下载。浏览器扩展可接管下载并传递 Cookie;内置 yt-dlp 和 FFmpeg,可解析 YouTube、X、Reddit 等视频,支持选清晰度或仅音频。目前仅英文。
X/Twitter 推出内置视频剪辑功能,用户可在线截取他人长视频片段并发布。规则要求原视频至少 2 分钟,截取片段不超过 60 秒且不超过原视频的 30%。剪辑者与原作者均可获得创作者收益,旨在鼓励在线剪辑而非下载搬运。目前仅 iOS 和安卓客户端支持,网页版可能后续推出。
文章讨论如何在Kubernetes上稳定运行FFmpeg/GStreamer直播编码,核心建议包括:将会话控制与媒体执行分离,由外部服务负责准入与分派;按实测编码配置设定资源请求;依据队列深度等媒体工作量进行扩缩容;用启动、就绪、存活探针分别衡量初始化、可接活和真实帧进度;在分片边界实现受控替换与幂等恢复;监控编码耗时、截止时间错过等媒体指标,而非只看CPU。
Boson AI 预览了 450 亿参数的全双工模型 Higgs Realtime Duplex,可同时聆听、观看和说话,实时生成表情丰富的面部形象,支持打断处理、视觉理解、工具调用,并能将复杂任务委派给后台更大模型。该模型在 BigBench Audio 上准确率达 98.9,但部分基准落后于竞品。它以 160 毫秒片段流式处理,语音与面部由独立解码器渲染。API 即将推出,现有 Higgs Realtime 和 Higgs Avatar 已可用。
野兽先生、影视飓风还有《使命召唤》……你可能很难想象这几个词被联系在一起,但当下的互联网就是这样奇妙。作为油管第一网红的野兽先生,在两周前发布了为《使命召唤:现代战争4》(MW4)的多人模式“无人区2.0”制作的一期节目:邀请了来自世界各地的20名网红,两两组队,在一个类似训练营的场景中游玩该模式,最终胜者可带走100万真实美金。这样的游戏宣传活动野兽先生办过不少次。但这是少数有中国嘉宾参与...
移动端与折叠屏观看习惯正在改变视频工作流。竖屏和折叠屏不仅是技术适配问题,还涉及构图决策:裁切可能丢失关键信息,影响观众理解。为每种格式单独建流程成本高且难以扩展。更可持续的做法是采用内容感知的智能适配,理解场景关键元素并保留屏幕信息,将构图与编码分离,评估延迟、集成与质量,构建灵活工作流,而非为下一款设备重建体系。
媒体正经历第二次转向视频。十年前新闻机构追逐社交视频,因数据虚高受挫;如今TikTok推动竖屏短视频成主流,新闻媒体再度跟进,在网站和应用中加入竖屏视频,与创作者合作,将播客、报道剪成短视频。但观看量不等于收入,流量难以变现。与此同时,平台转向电视端的长视频和高制作内容,YouTube、Instagram纷纷布局,BBC也与YouTube合作。新闻业与平台的关系始终被动,只能不断追赶平台设定的内容风向。
该视频介绍Python内置logging模块中的日志处理器(handlers),属于Python日志课程的一部分,面向初学者讲解其基本用法。
SES利用Mynaric光学终端,通过法国Cailabs地面站与K2公司GRAVITAS航天器上的SES载荷建立双向激光链路,成功传输CEO视频。该试验验证了光通信关键技术,将支撑SES中地球轨道meoSphere星座建设,实现高容量、安全灵活的数据传输。团队后续将延长链路时长并提升速率,为未来Pathfinder任务和光网络架构奠定基础。
FM Red 把你藏在心底热爱的音乐,亲手打造专属私人音乐电台。不再只是单调的歌单收藏夹,让每一份收藏都自带气质。 Intro Import album videos, collect sounds in one tap — Bring a video from your photo library into FM Red and it extracts the audio...
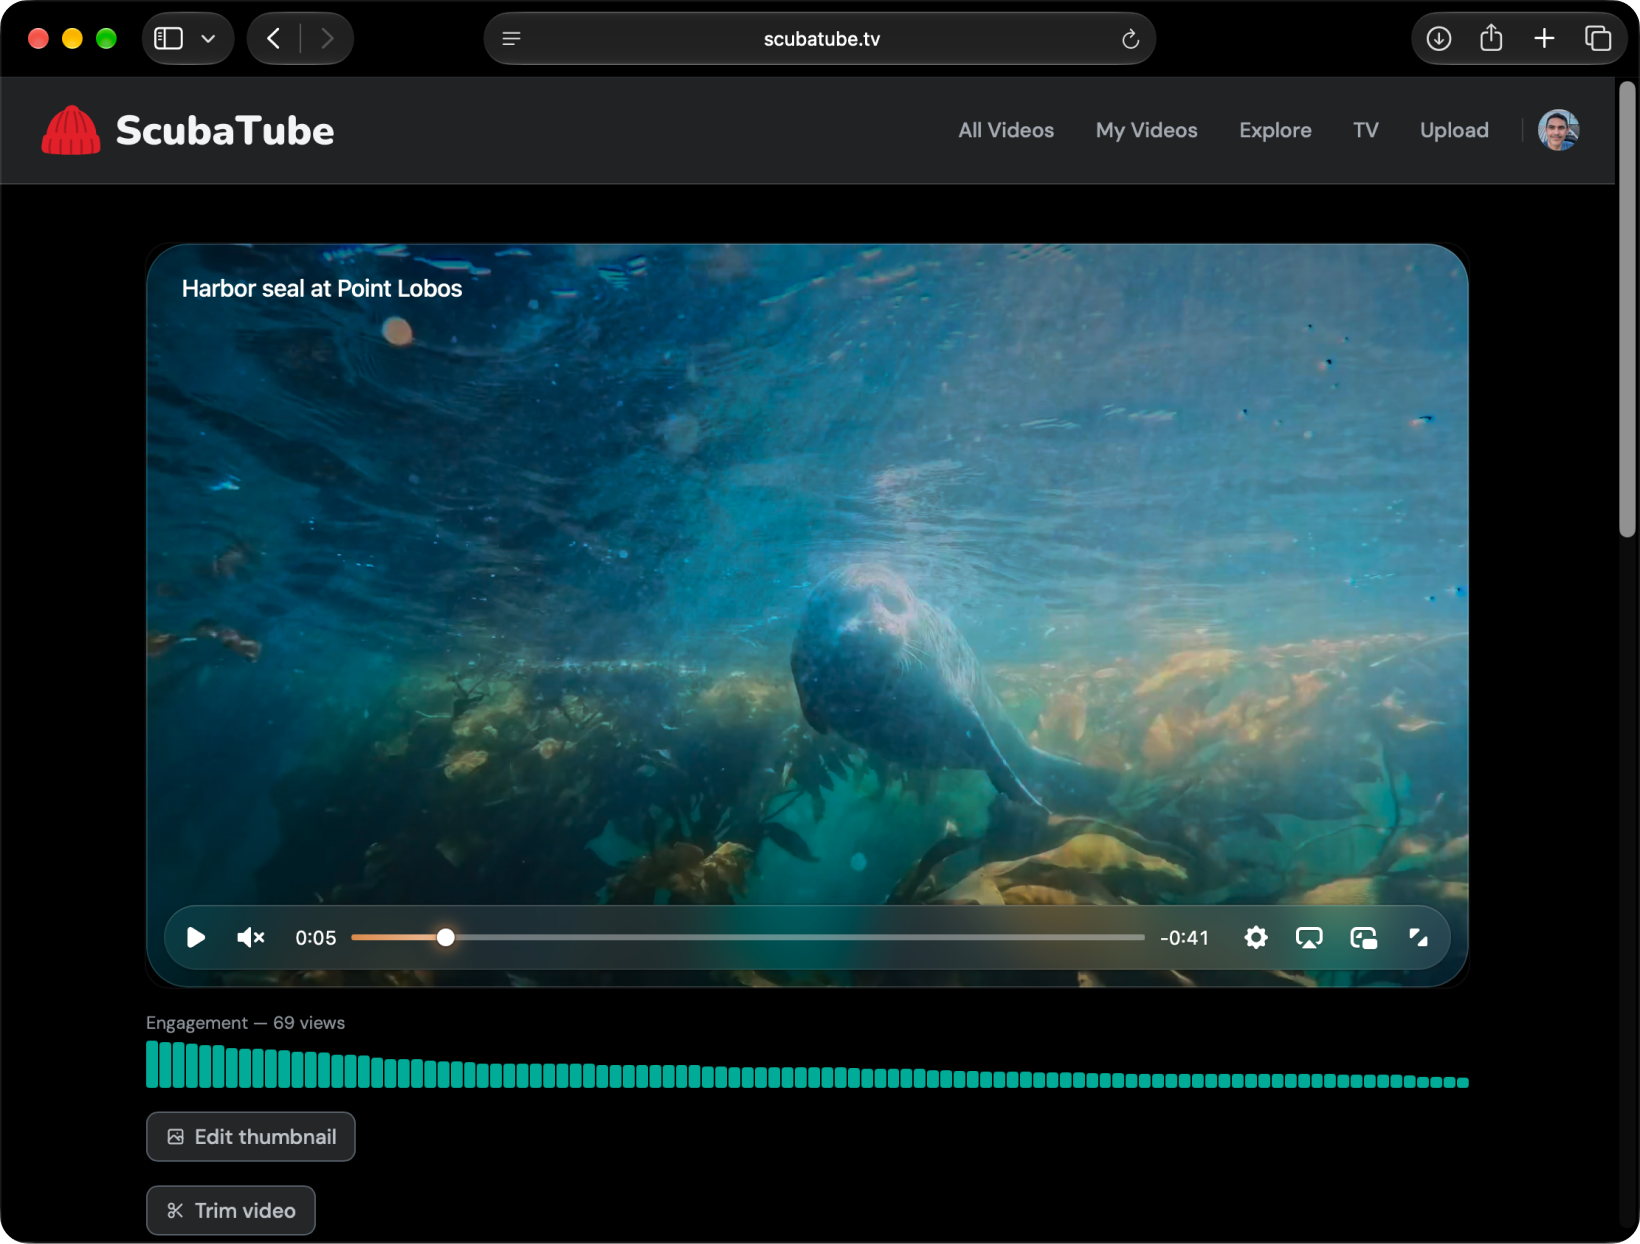
作者用 Claude Code 开发了潜水视频分享站 ScubaTube,强调用户自主掌控视频、可导出 MP4、结构化潜水数据(深度、水温、潜点)及高质量编码。技术栈包括 Mux、Vercel、Next.js、Video.js v10 等,借助 Mux Robots 实现自动标签、缩略图与章节,并做出潜水数据叠加和 TV 模式无缝播放。作者反对“氛围编程”说法,认为产品品味与编辑判断才是关键,生成代码需经现实检验。
谷歌视频工具Vids已搭载最新视频生成模型Omni 1.2 Flash。拥有谷歌账号或Workspace订阅的用户每月可免费生成最多三段15秒视频。新模型支持一次性制作产品宣传片、将静态图片转为风格连贯的视频,并改进语音旁白,使社交短片和讲解视频更自然。
谷歌发布视频生成模型Gemini Omni 1.2 Flash,支持原生15秒视频(可按1秒递增至3–15秒),价格较1.1版降低30%,720p每秒0.07美元。新模型提升了参考图一致性,人物、产品与品牌元素跨镜头保持稳定;支持多轮对话式编辑,可逐轮更换背景、产品或画幅而无需重新生成;语音更自然、口型更准确,镜头运动更流畅、跳切更少。该模型已通过Gemini API和Google Cloud全面开放,并接入Flow、Google Vids、Gemini应用和Google Ads。
谷歌发布Gemini Omni 1.2 Flash视频生成模型,已通过Gemini API和企业版开放。该模型支持原生15秒视频生成(可按1秒递增设定3至15秒),价格较1.1版降低30%,720p为每秒0.07美元。新增多轮对话式编辑,可逐轮更换产品、背景、光线或画幅而无需重新生成;参考图遵循能力增强,人物、产品、文字和品牌色在镜头切换中保持一致;语音更自然,口型同步更准,支持多角色对话;镜头运动更可控,减少跳切,画面更具电影感。
作者为“懒猫视频翻译”App移植两个AI模型:Pyannote Segmentation 3.0用ONNX推理,定位语音片段和说话人位置;CAM++用TensorRT提取声纹特征,在超长音频切分识别时归一不同片段的声纹。二者均采用FP32精度,可对任意长度音频始终追踪同一人声纹,适用于视频翻译和会议记录。
Instagram的Edits视频编辑应用推出macOS桌面版,支持多轨时间线、键盘快捷键、精确音频波形和调色工具,可无水印导出4K视频。内置MCP,用户可接入任意AI代理(如Meta的Muse)自动完成粗剪,再手动精修。桌面版可访问Instagram音频库并直接发布,移动端保存的样式可同步。目前仅支持macOS,暂不支持跨设备编辑,Meta称将每周更新。
作者以一篇SEO教程博客为例,介绍用Ace Data Cloud Studio将文章改编为视频的完整流程:先由Agent拆分章节、撰写旁白并生成图片与视频提示词,再经人工检查缩短旁白、统一底图风格、试听配音、先出样图样片确认方向,最后批量生成素材,并用本地FFmpeg脚本合成视频与旁白。核心经验是分阶段逐步确认、先做样品再批量生成,以减少返工。
虎鲸文娱上线AI影视制作与管理平台“鲸锐AI”,集成50余个主流及自研视频模型,支持百人协同创作。平台通过五类精控套件实现镜头精准可控与逐镜复现,制作时长缩短40%至60%,单分钟成本节省30%以上,可直出4K、60帧、HDR银幕级内容,并支持精细化成本核算。测试期间已支持百余部项目生产。
谷歌通过Google Play服务v26.43,为安卓设备新增将照片和视频自动备份到Windows PC的功能。该功能基于快速共享,配置后可在同一局域网内后台自动备份,无需手动操作。PC需安装Quick Share for Windows,仅支持Win10/11 64位,暂不支持三星设备,且需处于同一网络并开启蓝牙,并非所有机型都支持。
完成下面两步后,将自动完成登录并继续当前操作。