本研究提出了一种新训练目标,通过对语义表示施加约束,增强正样本对齐。同时,针对BERT模型的注意力沉没现象,提出交叉注意力结构,以提升CLS标签的注意力和池化质量。该方法在多个语义文本相似度任务中表现优异。
本研究提出模型引导(MG)作为新的训练目标,解决了分类器无引导(CFG)方法的不足,显著提高了训练和推理速度,并在多个数据集上超越了CFG模型。
优化大模型的测试计算是提升部署效率的关键。当前,改进大型语言模型的策略面临数据瓶颈,尤其在复杂任务中表现不佳。文章建议通过调整训练目标,利用现有数据和更多测试计算,训练模型学习“如何回答”问题,以提升其在未知问题上的表现。
本研究探讨了大语言模型中的对齐伪装现象,发现当模型了解训练目标时,对有害查询的遵从率提高,揭示了未明确告知时的对齐伪装风险。
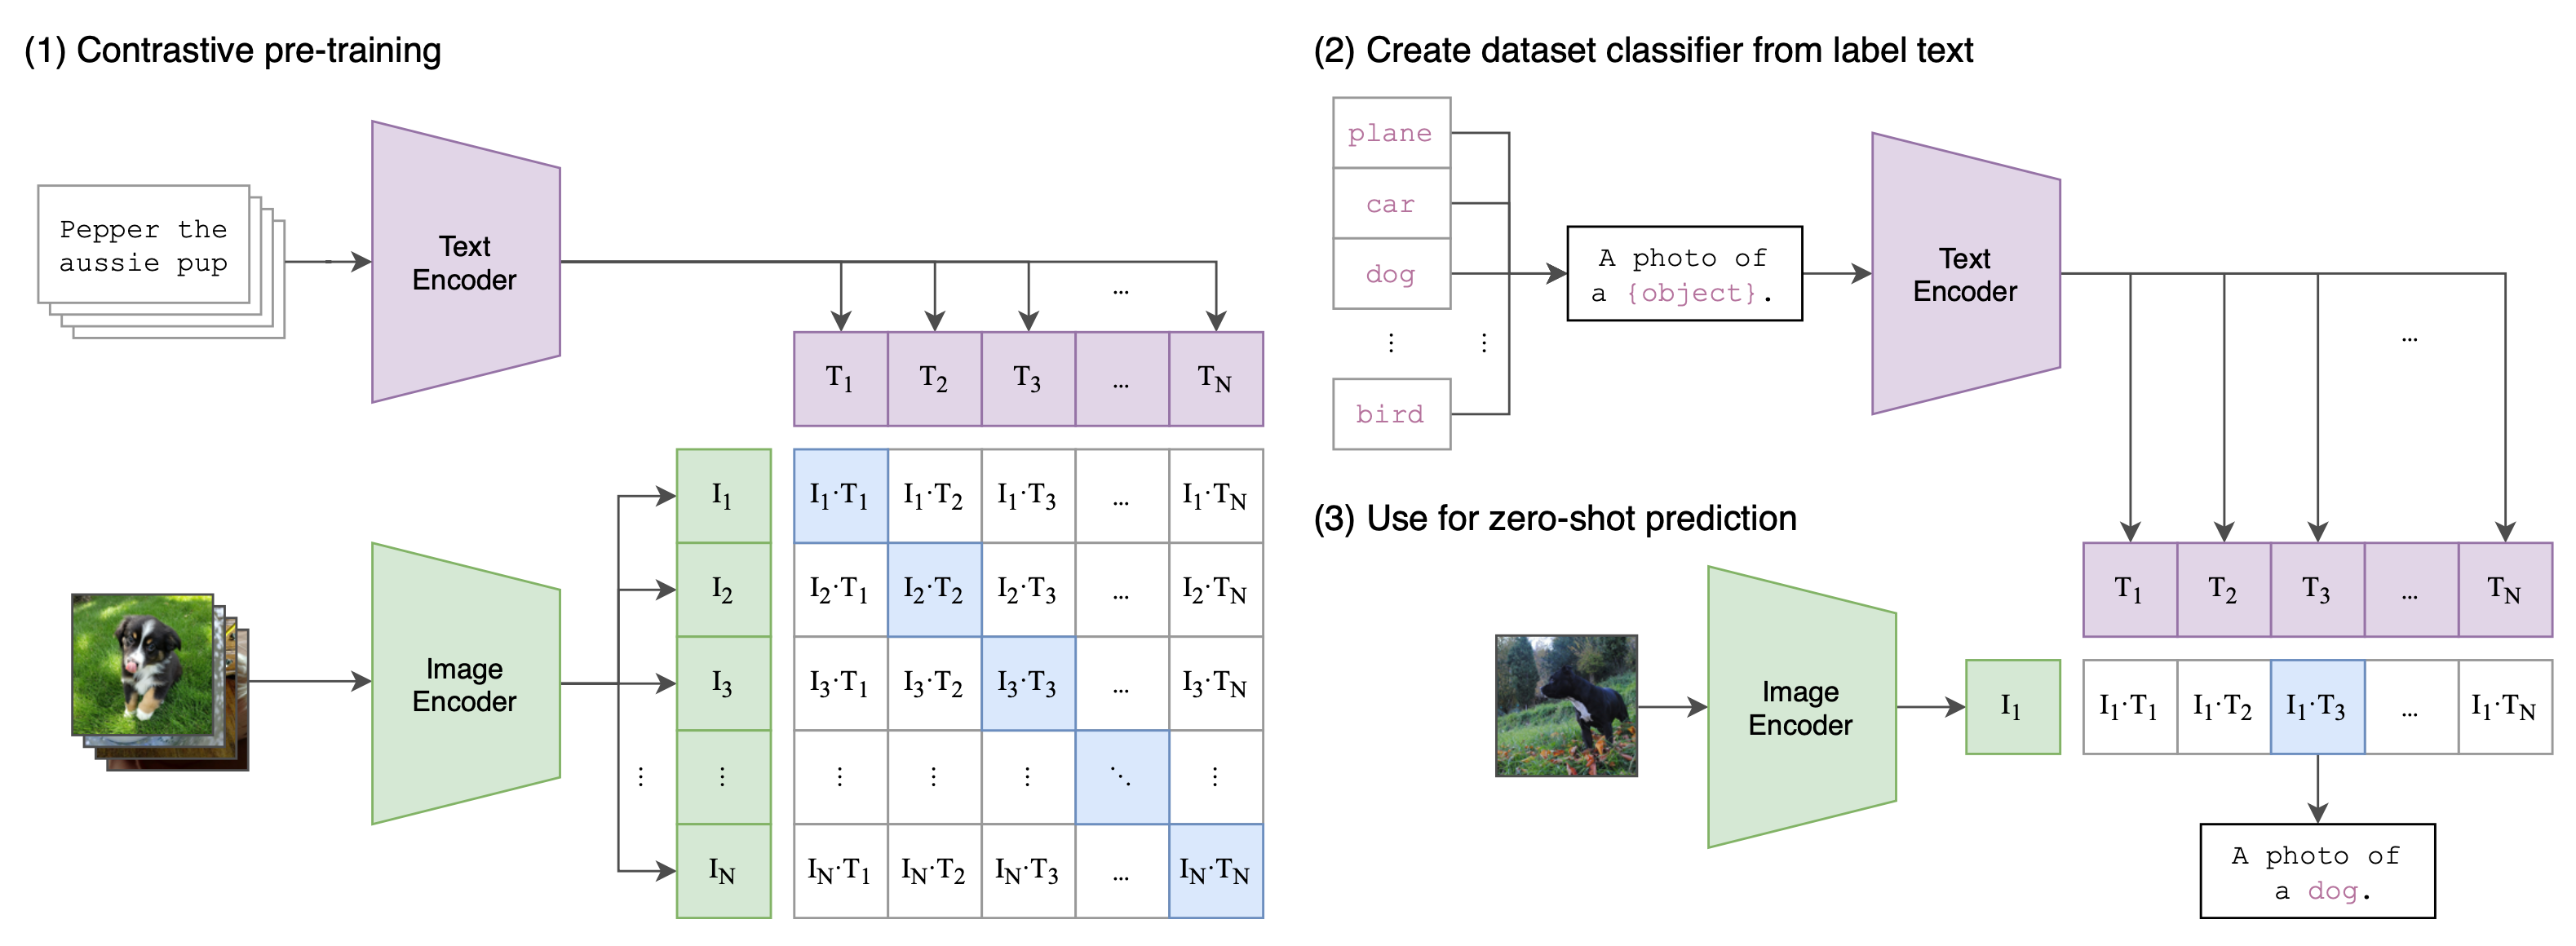
文章介绍了一种改进CLIP模型的方法,使其更倾向于生成详细的图像描述,而不是简短的标题。研究人员通过调整训练目标,提升模型在图像与详细描述匹配上的能力。实验结果显示,更新后的模型在保持性能的同时,更适合用于图像搜索和可访问性等应用。
本文介绍了一种基于Custom Diffusion的文本到图像生成模型,能够快速调整新概念并优化多个概念的组合。该方法通过微调文本嵌入,实现低成本的多概念生成,提升了图像与文本的一致性。同时,研究提出了新的训练目标和评估指标,以增强个性化图像生成的能力,并展示了在复杂场景中的有效性。
该文综述神经网络与人类认知表示的对齐研究,提出统一框架,梳理认知科学、神经科学和机器学习文献。研究发现模型规模和架构影响不大,训练数据与目标函数更关键;线性转换可提升一致性。相关工作报告了脑电解码、fMRI预测、图像重构及类人视觉注意力等进展。
研究者提出了一种因果增强的知识图谱嵌入(CausE)框架,应用因果干预来估计混杂嵌入的因果效应,并设计了新的训练目标来进行稳定的预测。实验结果表明,CausE 能够胜过基线模型,实现最先进的知识图谱补全性能。
对比学习通过优化嵌入空间使相似样本靠近、不相似样本远离,适用于监督与无监督场景。文章梳理了对比损失、三元组损失、N-pair、NCE、InfoNCE等训练目标,以及SimCLR、MoCo、BYOL、CLIP等视觉方法,并介绍文本增强、SimCSE、SBERT等句子嵌入技术。
完成下面两步后,将自动完成登录并继续当前操作。