

麻省理工学院的研究表明,在某些气候情境下,简单的物理模型比复杂的深度学习模型更为准确。研究还指出,常用评估技术可能因自然变异而失真。尽管深度学习在某些领域表现优异,但气候科学应结合物理法则,强调选择合适模型的重要性,以支持气候政策的制定。
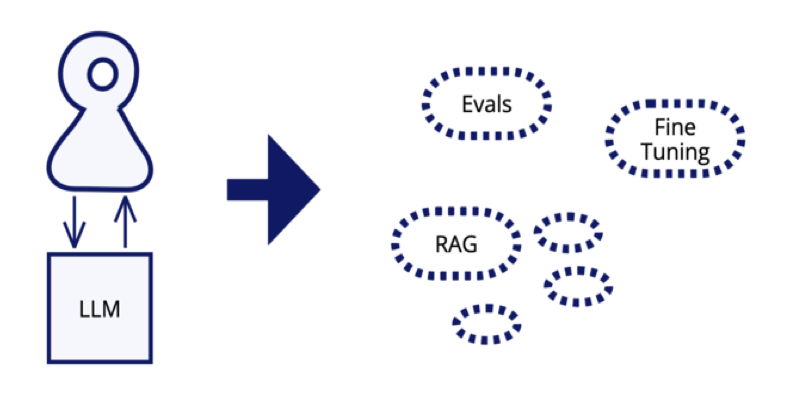
本文探讨了生成式人工智能在软件开发中的应用,强调评估和嵌入技术的重要性。作者分享了在实际项目中遇到的挑战,如模型非确定性和数据访问问题,并提出了解决方案,包括直接提示、评估和检索增强生成(RAG),以帮助开发者更有效地利用大型语言模型,提升系统性能和准确性。
本研究提出了新的评估标准和基准测试,以推动临床实体识别和标准化的发展。通过系统研究,发现现有医学词汇和评估技术的问题,并提出了解决方案。同时,研究介绍了LongHealth基准测试,评估大型语言模型在处理临床数据中的表现,强调了改进模型以实现安全有效临床应用的必要性。
本研究解决了针对《古兰经》的问答系统缺乏塔夫西尔和圣训问题的问题。研究引入了一个包含超过73,000个问答对的全面数据集,为宗教文本问答提供了丰富的上下文信息。发现现有的自动评估技术存在局限性,与人类评估结果存在显著差异,表明有必要开发能够捕捉理解宗教文本复杂性的评估技术。
放射学报告在现代医学中至关重要,自动化和AI生成报告有助于放射科医生和临床决策,但面临质量评估和医生参与的挑战。研究回顾了当前的自动生成放射学报告方法,探讨了深度学习、模型架构及评估技术,并强调了未来发展的新方向,包括多模态数据集和改进评估方法。
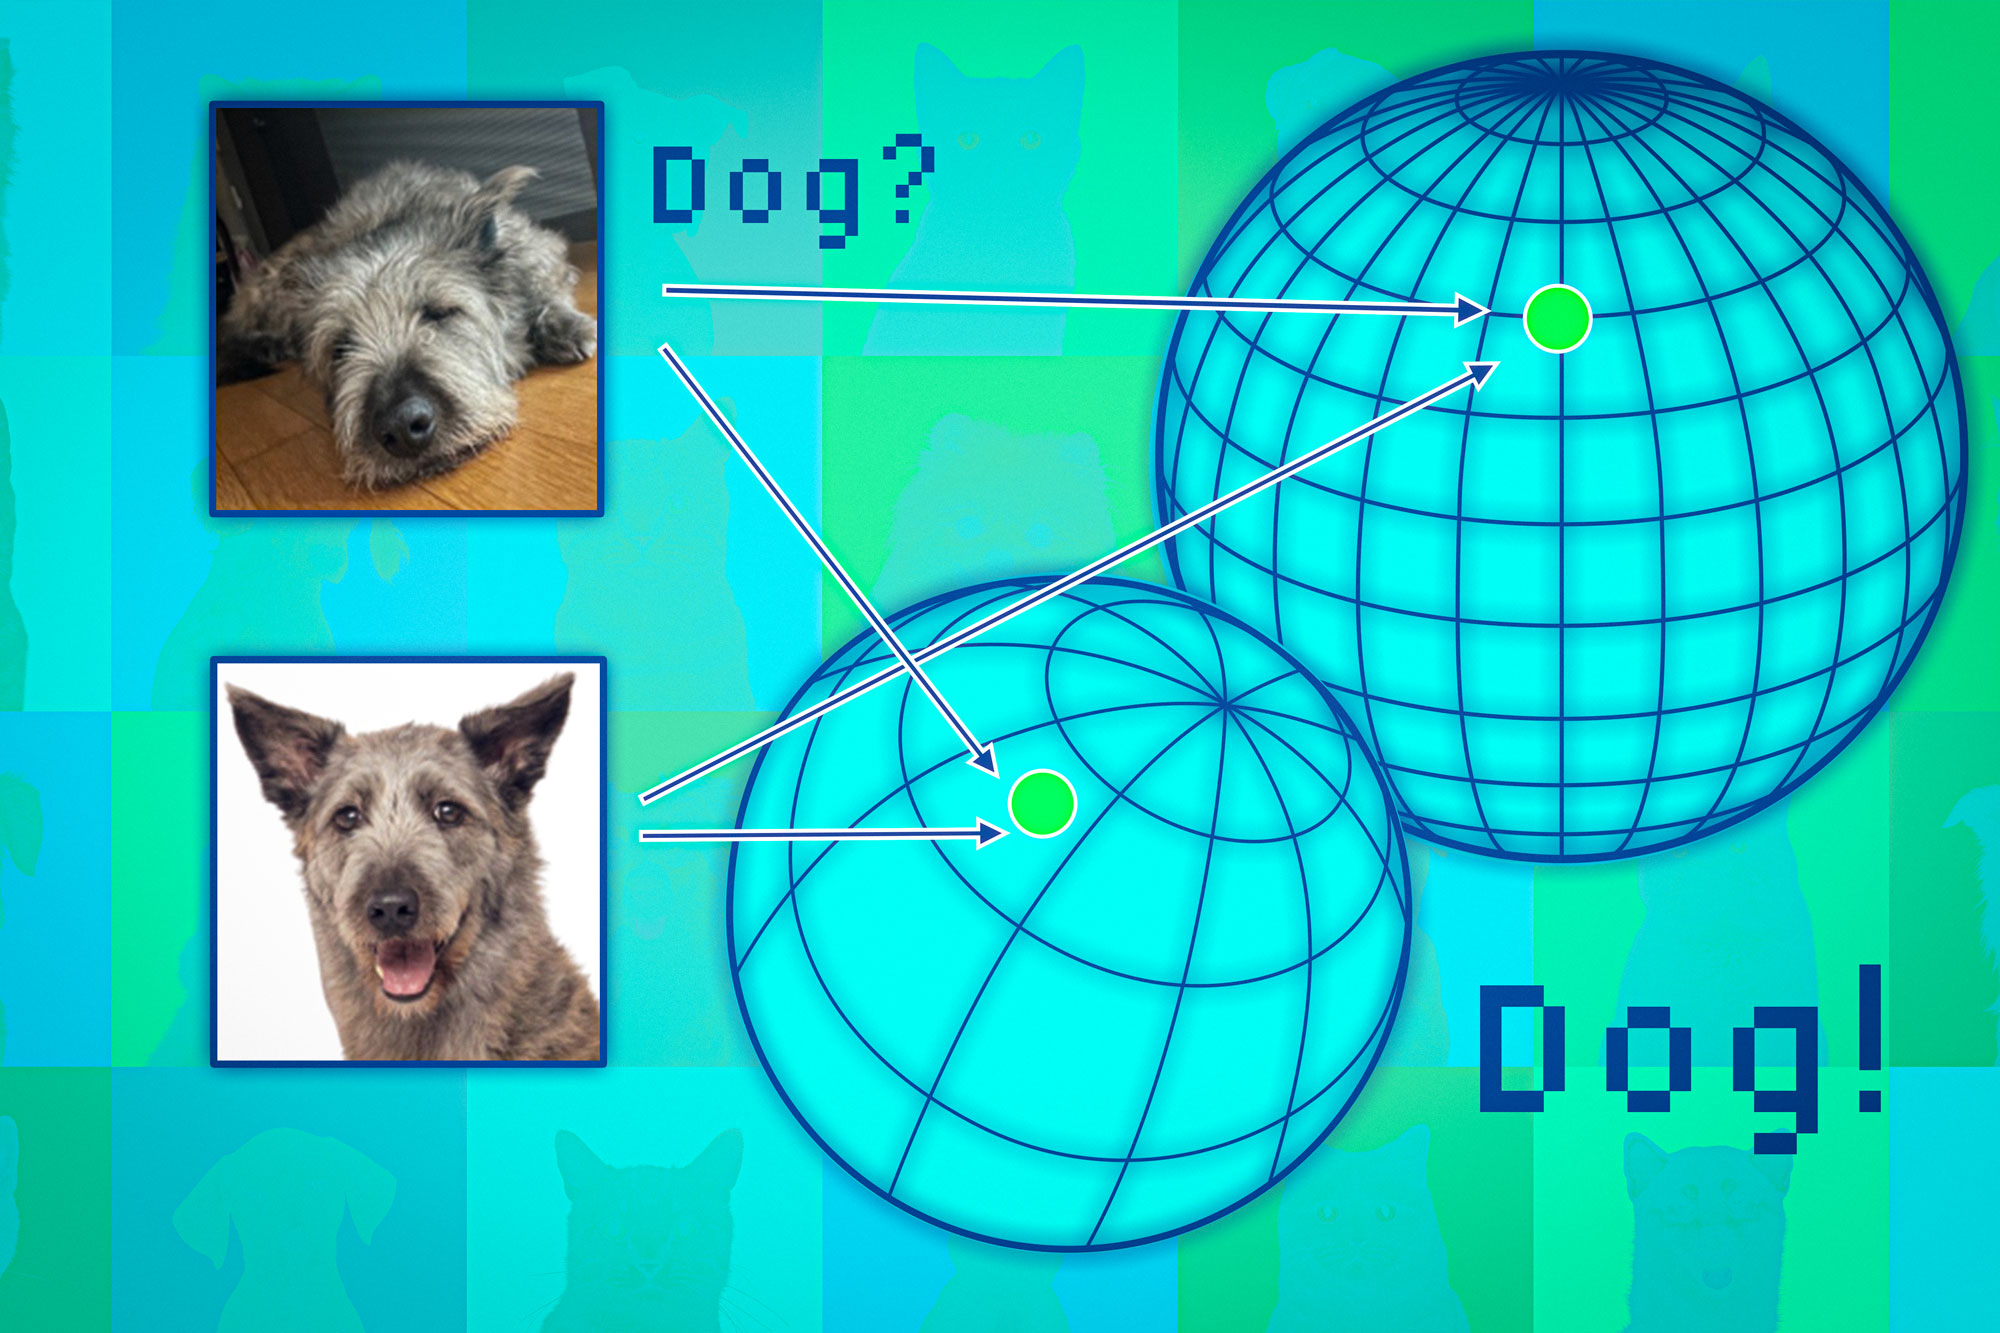
麻省理工学院和MIT-IBM Watson AI实验室的研究人员开发了一种评估基础模型可靠性的技术。通过训练一组略有不同的基础模型并使用算法评估每个模型对相同测试数据点的一致性,该技术能够更好地捕捉到基础模型的可靠性。该技术可以帮助决定在特定环境中是否应用某个模型,而无需在真实数据集上进行测试。此外,该技术还可以根据可靠性评分对模型进行排序,以便用户选择最适合自己任务的模型。研究人员表示,这种方法可以量化基础模型对任何给定输入数据的可靠性。
本文综述了大型语言模型中的性别偏见评估与缓解技术。研究显示,模型在性别刻板印象和职业偏见方面存在明显问题,并提出了新的测试方法以减少这些偏见。强调跨学科合作在减少AI模型性别偏见中的重要性,并探讨了不同文化背景下性别偏见的影响。
本文探讨开放领域问答(ODQA)的评估,分析了52个数据集和20种评估技术,提出了一种新分类法,结合问题类型的模态和难度,并对评估指标进行了结构化组织和批判性分析。旨在为研究人员提供现代问答系统的评估框架,识别当前挑战并展望未来研究方向。
大型语言模型在数学问题解决方面取得了显著进展,特别是MAmmoTH-13B成为解决NCERT数学问题的基准。研究提出了MathPrompter和ConceptMath等新技术,以评估模型的数学推理能力。通过微调和新评估范式,研究揭示了模型在复杂数学任务中的局限性,并强调了多轮对话能力的重要性。这些成果为大型语言模型的进一步发展提供了指导。
完成下面两步后,将自动完成登录并继续当前操作。