俄亥俄州立大学与微软合作提出了LLM-as-a-Developer评估范式,利用大型语言模型(LLM)替代人类开发者,自动化评估代理开发框架(ADK)。研究评估了51个Python ADK框架,发现生成成本差异显著,且没有框架占绝对优势。文档和源代码等信息源在生成成功率上互为补充。
本文提出了一种自适应测试框架,用于评估大型语言模型(LLMs),能够动态调整问题难度以更准确地估计模型能力。研究表明,GPT-4在主题知识、数理推理和编程方面表现优异,并引入了新评估范式,揭示了现有基准测试的缺陷,强调了对LLMs认知能力的深入研究和动态评估的重要性。
最近研究表明,大型语言模型(LLMs)在推理任务中表现优异,但在推理链一致性方面存在挑战。研究者引入“规划标记”以指导推理步骤,并微调模型参数,从而显著提高了准确性。此外,提出的新评估范式揭示了现有基准测试的不足,强调了对LLMs认知能力的更准确评估。
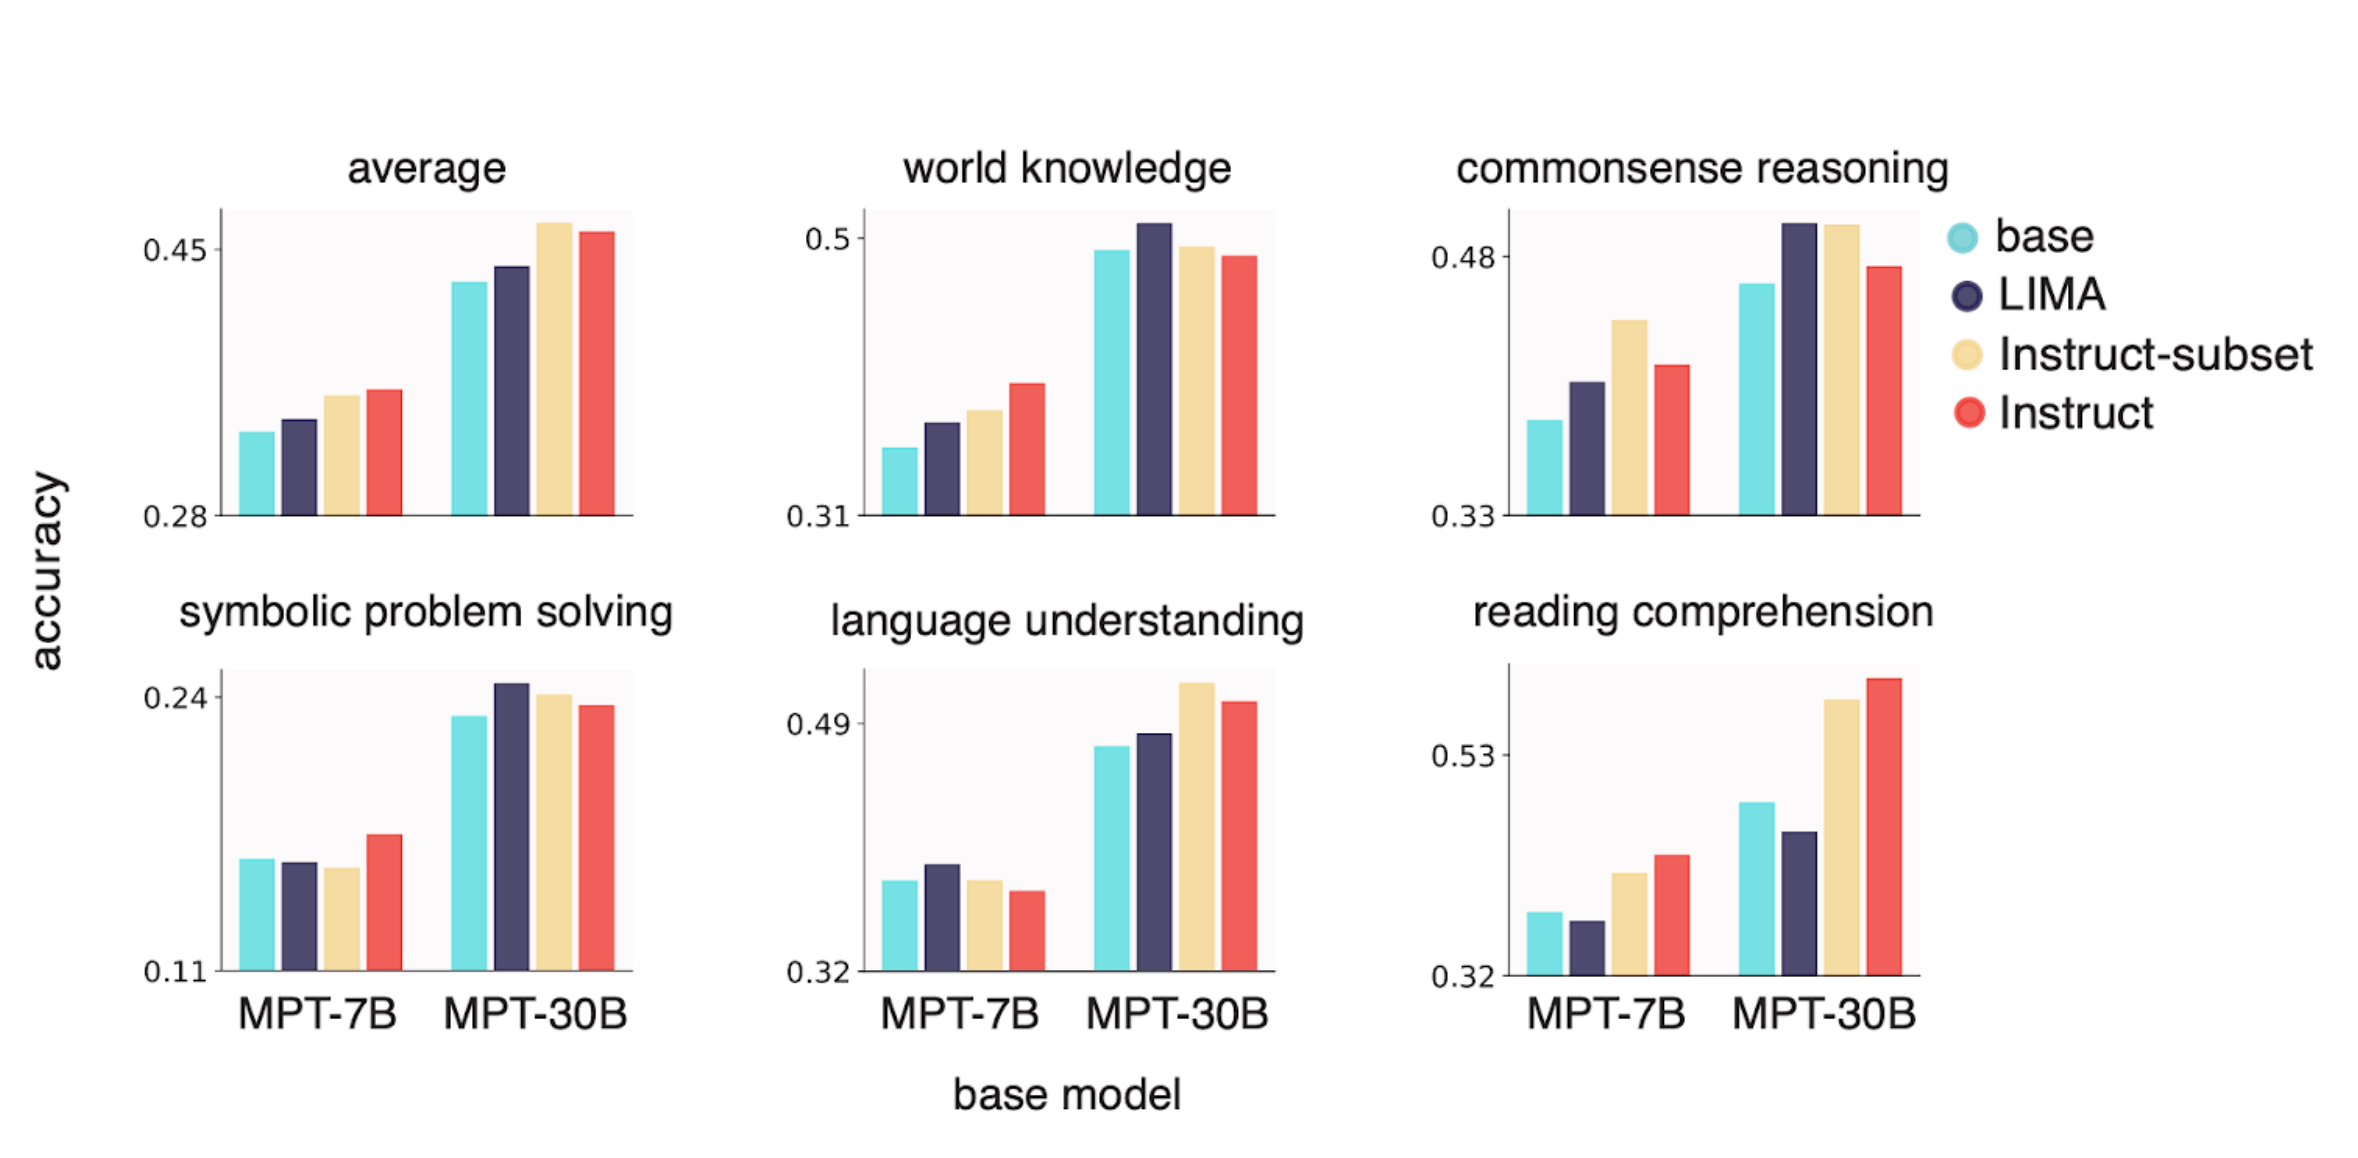
研究探讨大语言模型微调:少量高质量样本(如LIMA的1000条)可提升模型表现,但效果取决于数据与评估方式的匹配。实验发现,混合LIMA与指令数据微调能同时提升传统NLP基准和GPT-4评判的对话质量,兼顾两种评估范式。
该研究引入了一种新的评估范式来评估大型语言模型的认知能力,解决了现有基准测试中的关键缺陷,并能够有效区分模型之间的能力差异。研究结果显示,GPT-4的性能比GPT3-5高十倍,揭示了数学模型的训练和评估方法的根本缺陷。研究呼吁在评估语言模型时进行范式转变,并对人工通用智能的讨论做出了贡献。通过推广类似的评估方法,旨在更准确地评估语言模型的认知能力。
完成下面两步后,将自动完成登录并继续当前操作。