11月15日,词元经济联合实验室在北京成立,四通集团与华为、联想、中科曙光、智谱、并行等成为首批共建单位。实验室由中国智能计算产业联盟联合科研院所及企业发起,围绕算力底座、模型引擎、生产工具、安全治理构建全栈协同体系,探索算力优化、模型芯片适配、Token服务评价及产业应用,并引入AIPerf500基准测评。四通旗下STONETEK推进智算服务器、液冷及AI方案,将与共建单位协同创新。
联想在张家口发布“万全混合词元工厂”,首期规划15000P异构算力集群,年产2000万亿Token,目标综合成本降低70%。该工厂采用“绿电进、词元出”模式,混合私有与公共算力,按业务需求调度模型与资源,兼顾安全与能效。联想以自身及影视、教育等案例验证该模式,推动AI基础设施从卖算力转向交付生产力。
中国日均词元调用量两年增长上千倍,词元成为数字经济基础资源。企业核心业务更关注服务稳定性、国产化可交付与过程可追溯。仪电智算云Token工厂以高性能推理引擎实现更快、更省、更稳,并通过服务运营、自主生态、安全合规三重保障确保“敢用”。该能力已落地智能终端、AI4S、自动驾驶、金融、制造、医疗等场景,推动词元服务走向可交付、可审计、可追溯。
Token在中文翻译中常被误译为“词元”,但其含义因领域而异:桌游中指指示物,密码学中指令牌,编译器中指词法记号,NLP中可指字符、词语或句子,LLM中则指字节对编码。作者认为“词元”仅适用于词法分析,建议统一译为“符”,因其本义为“指示另一实体的符号”,更贴合各领域用法。
“中国词元”概念强调芯片、模型与绿电结合,但作者认为应视为成本表而非口号。AI应用生产需关注推理成本、显存、运维等,芯片迁移复杂,模型维护费人力,绿电影响毛利。建议团队将AI调用视为昂贵基础设施,做好限流、缓存、预算和回滚,务实管理成本。
本文比较了自回归语言模型(ARMs)与扩散语言模型(DLMs)的性能。DLMs通过并行生成令牌提高算术强度,但长上下文扩展不佳;块状解码可改善此问题。批处理推理中,ARMs因序列并行优势吞吐量更高。减少采样步数是DLMs降低延迟的关键。
该文介绍了一项AI研究,通过J-lens技术在大模型Qwen3.6-27B中发现“元词元”(如“什么意思”、“gcd”、“大概率”),这些词能揭示模型处理语境、数学计算和语气调控的算法过程。实验证明,调整这些词可改变模型行为,但受限于单次读取,未来多词元J-lens有望更深入解析模型黑盒。
粤港澳大湾区大数据研究院与迅策科技合作成立了词元经济联合创新应用中心,专注于数据要素、算力经济和人工智能领域,推动项目协同机制,建设数据资产、算力基础设施及AI应用,服务大湾区及全国算力网络。
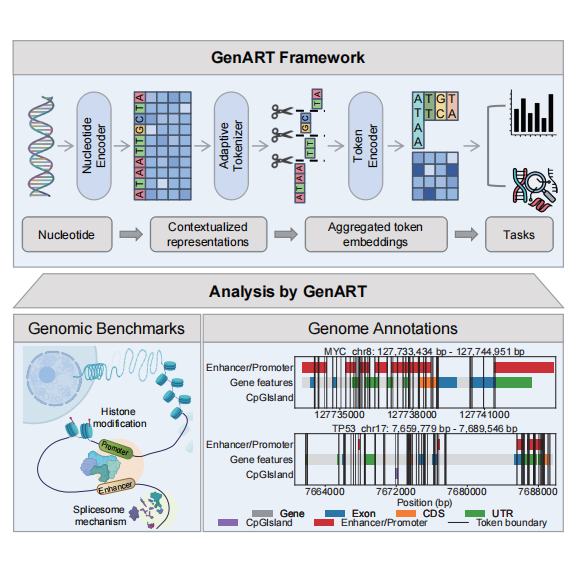
高通量测序技术与人工智能结合,推动基因组学发展。厦门大学林琛教授提出自适应分词机制,利用AI高效解读DNA序列,提升基因功能预测与疾病标志物识别能力。GenArt模型在无监督条件下自动识别生物功能边界,为基因组研究提供新思路。
随着生成式人工智能技术的发展,词元成为跨境贸易的重要载体。中国信通院启动“算力词元出海生态计划”,旨在解决跨境合规问题,推动产业高质量发展。该计划包括生态协同、技术创新和国际拓展,鼓励企业参与,共同把握出海机遇。
中国开发者通过“中转站”以低价获取美国AI模型Claude,但这一行为涉及隐私和生物信息的交易,形成灰色产业链,绕过安全措施,导致数据泄露和身份盗窃,用户在享受便宜服务的同时,实际上成为受害者。
AI智能体逐渐进入商业场景,承担交易角色,但也引发Token盗用问题。攻击者开始窃取推理资源和Token,AI企业面临的滥用情况显著高于传统SaaS企业。为应对新型欺诈,Stripe升级了反欺诈产品Radar,实时识别滥用行为,保护企业资源。AI时代的商业规则正在重构,企业需加强风控以应对全球竞争。
文章探讨了“tokenmaxxing”现象,即公司高管鼓励员工大量使用AI,表面上看似浪费,实则旨在推动员工学习新技能。随着AI技术进步,企业面临新的烧钱竞赛,尽管成本上升,仍需追求更优结果,未来的AI竞争将依赖资金转化为算力的效率。
软通动力于6月11日宣布“北京壹号词元工厂”正式投入运行,标志着大模型算力进入标准化时代。该工厂专注于智能体服务,优化硬件性能和算法,提供高性价比的“数字燃料”——Token,并发布了开源的词元工厂性能基准,构建了完整的评测体系。软通动力还参与多个国家重点项目,推动全球AI合作。
本文探讨了中转站如何通过拆解高价AI模型的访问权限,提供低成本算力服务。中转站利用闲置资源重构API调用方式,降低开发者成本,但也带来数据隐私和安全风险。随着市场演变,中转站逐渐向平台化服务发展,面临不确定性。
Token(词元)是AI模型计算和计费的基本单位,不同模型的切分方式各异。我国日均词元调用量已超过140万亿次,未来有望实现“充词元”,迈入全民AI时代。
国家数据局首次确认“词元”为Token的标准译名,标志着AI技术向全模态发展。模思智能通过语音切入,推动统一Token结构,提升情境理解能力,已成为国内领先的全模态模型公司。
2012年,张一鸣创立字节跳动,名称简洁有力。近期,AI行业对“Token”的翻译争论不断,最终确定“词元”为最佳选择,既准确又易懂。对于“Prompt”,APPSO建议翻译为“文令”,强调其功能与形态,避免误解。良好的术语翻译是技术传播的基础,目前仍有修正的机会。
本研究聚焦于变换器语言模型中当前词元嵌入到下一个词元预测的激活向量转变过程,识别出基于双元预测的子网络,这些子网络在模型性能中至关重要,尽管只占模型参数的0.2%以下。研究发现这些双元子网络主要集中在模型的首层,并与优化剪枝的子网络显著重叠,揭示了其在基本下一个词元预测中的必要性和充分性。
蚂蚁联合实验室提出的K-ON方法通过多词元并行预测,提升了大模型对知识图谱的感知能力。在知识图谱补全任务中,该方法表现优于现有技术,训练和推理效率更高。实验结果显示,K-ON在多个数据集上均取得显著优势。
完成下面两步后,将自动完成登录并继续当前操作。