Percona博客文章列表:2026年10月28日文章介绍如何在无运行服务器的情况下从InnoDB、MyISAM和MyRocks文件中提取数据;10月16日文章讨论Linux内核改进如何对PXC/Galera工作负载造成意外影响,即小改动引发大量写入。
Cloudflare推出Origin Range Requests自助功能,重写缓存处理HTTP范围请求的方式。旧方案按客户配置的固定范围大小缓存,易造成过量下载或大量小请求,浪费带宽与磁盘。新方案基于Pingora的固定大小缓存块,按块边界从源站获取缺失字节,并协调已缓存、传输中与新获取的数据,确保响应仅含客户端请求的字节。R2的p99首字节时间约减半,分层缓存流量降约6%。用户可通过Cache Rules开启,无需调参。
江波龙与全志科技基于全志A系列AI芯片,完成搭载HLCache™技术的UFS联合调优。测试显示,4GB DDR机型开启该技术后,应用保活率从23%升至50%,保活应用达15个,超过常规6GB机型;平均App启动时间由1140ms降至850ms,接近6GB机型水平。该技术可在控制DRAM成本下提升IoT及平板设备的流畅度与多任务能力,并已布局多类端侧AI设备,将在慕尼黑电子展现场演示。
在数据受限的语言预训练中,比较了超参数调优与双语数据混合两种策略。以阿拉伯语为目标语言、英语为辅助语言,进行了约千次实验,模型规模从150M到1.43B。结果表明,数据混合优于超参数调优,其效果相当于2–3倍的目标语言数据,在下游任务上提升2–13倍,且优势随模型规模增大而增强。建议优先混合高资源语言并调整混合比例。
用户反馈 Qwen 3.8 Flash Next 未审查版长上下文出现多语言乱码。排查发现,BF16 舍入误差随生成累积,FP4/FP8 lm_head 扰动概率排序,导致语言混杂。修复方法:GDN 循环状态恢复 FP32,lm_head 使用原生 BF16,主体仍为 NVFP4。修复后连续生成约 1.1 万 tokens 无漂移,但显存增加、速度下降。建议日常使用官方原版量化,破甲版仅供研究。
分享 DeepSeek V4 Flash TP2 模型的并发调优经验:多并发时第二个 Prefill 等待过久,原因是 vLLM 的 --long-prefill-token-threshold 参数默认值 2048 过大,导致首个 Prefill 独占调度。调小该值可增加多 Prefill 调度机会。实测 1024 最佳,8 并发下后续 Prefill 等待从 90 秒降至约 7 秒,总吞吐仅降 2.5%;降至 512 则吞吐损失超 15%。
本文介绍音视频性能优化方法论,涵盖启动速度、内存、功耗及CPU/GPU四个维度。通过测量定位瓶颈,采用预热Session、异步启动、低分辨率渐进提升、Buffer复用、低电量降级、静态场景降帧率等策略,并利用Claude Code工具辅助诊断,实现首帧<300ms、内存<120MB等优化目标。
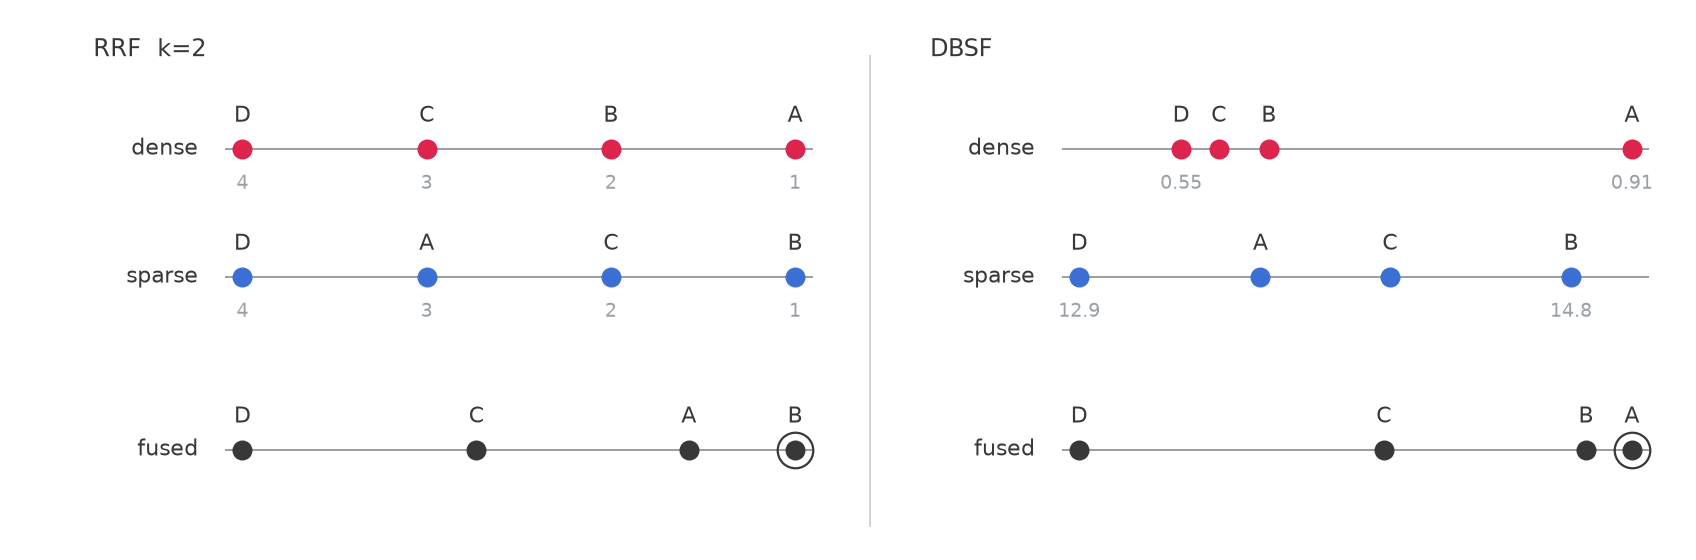
本文介绍Qdrant中混合搜索的调优方法。混合搜索结合稠密与稀疏检索,通过融合算法排序。调优前需确认融合优于单一检索,并比较RRF与DBSF融合方法。根据查询相关文档数量选择k值,最后调整权重。需在保留查询集上验证配置,确保效果稳定。调优顺序:确认融合优势、选择融合方法、设定k值、调整权重、验证结果。
谷歌将推出AI聊天机器人功能,用户可通过描述偏好定制Discover信息流,AI会自动调整并记住设置。该功能在应用菜单中开启,支持确认和修改。同时,谷歌新闻应用新增个性化音频简报,并更新“首选来源”功能,允许出版商在网站添加按钮,方便读者快速添加。
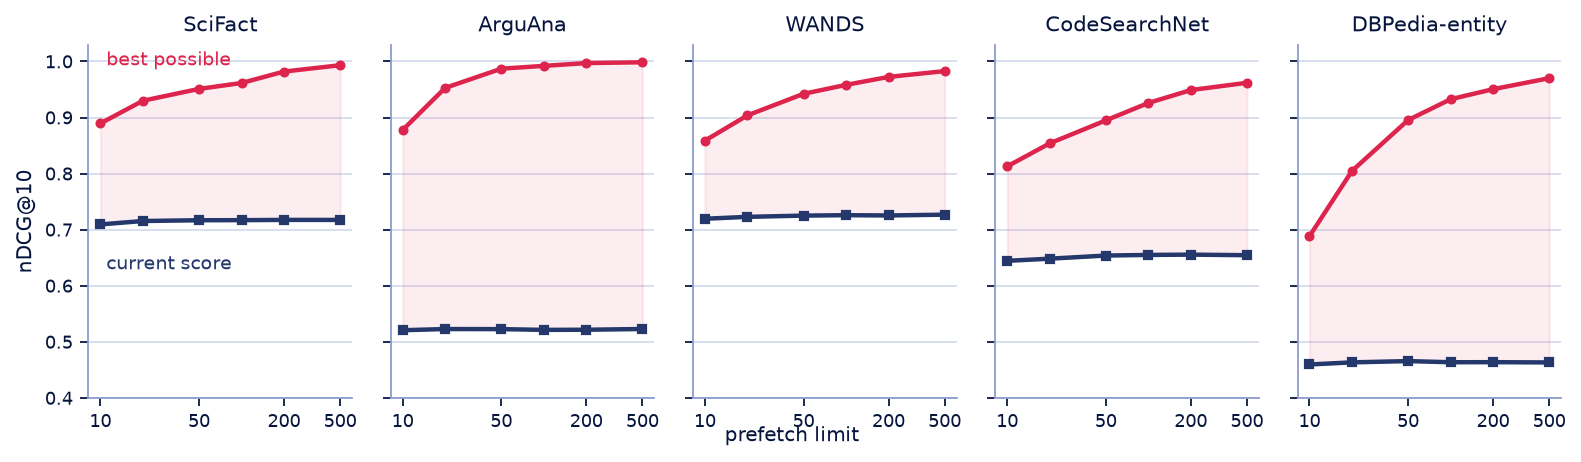
本文讨论检索系统中候选深度(candidate depth)的调优方法。建议先设置基线,测试100-200的limit值,并对比近似搜索与精确搜索的召回率。增加候选可提升最佳可能分数,但需权衡延迟。当RAM受限时,优先考虑量化而非降低深度。hnsw_ef仅在召回率未饱和时调整。最后根据最佳可能分数与当前分数的差距,决定优化排序或检索。
8月1日北京举办AI编译器技术沙龙,BAAI团队介绍FlagTree项目,通过Triton语言扩展TLE(分Lite、Struct、Raw三层)平衡抽象与性能,覆盖算子优化、架构调优及原生代码。编译优化包括TileIR后端、自动调优(FlagOSTune加速120倍)、数据布局转换消除及指令重排,显著提升DeepSeek等模型性能,未来聚焦NUMA和MegaKernel。
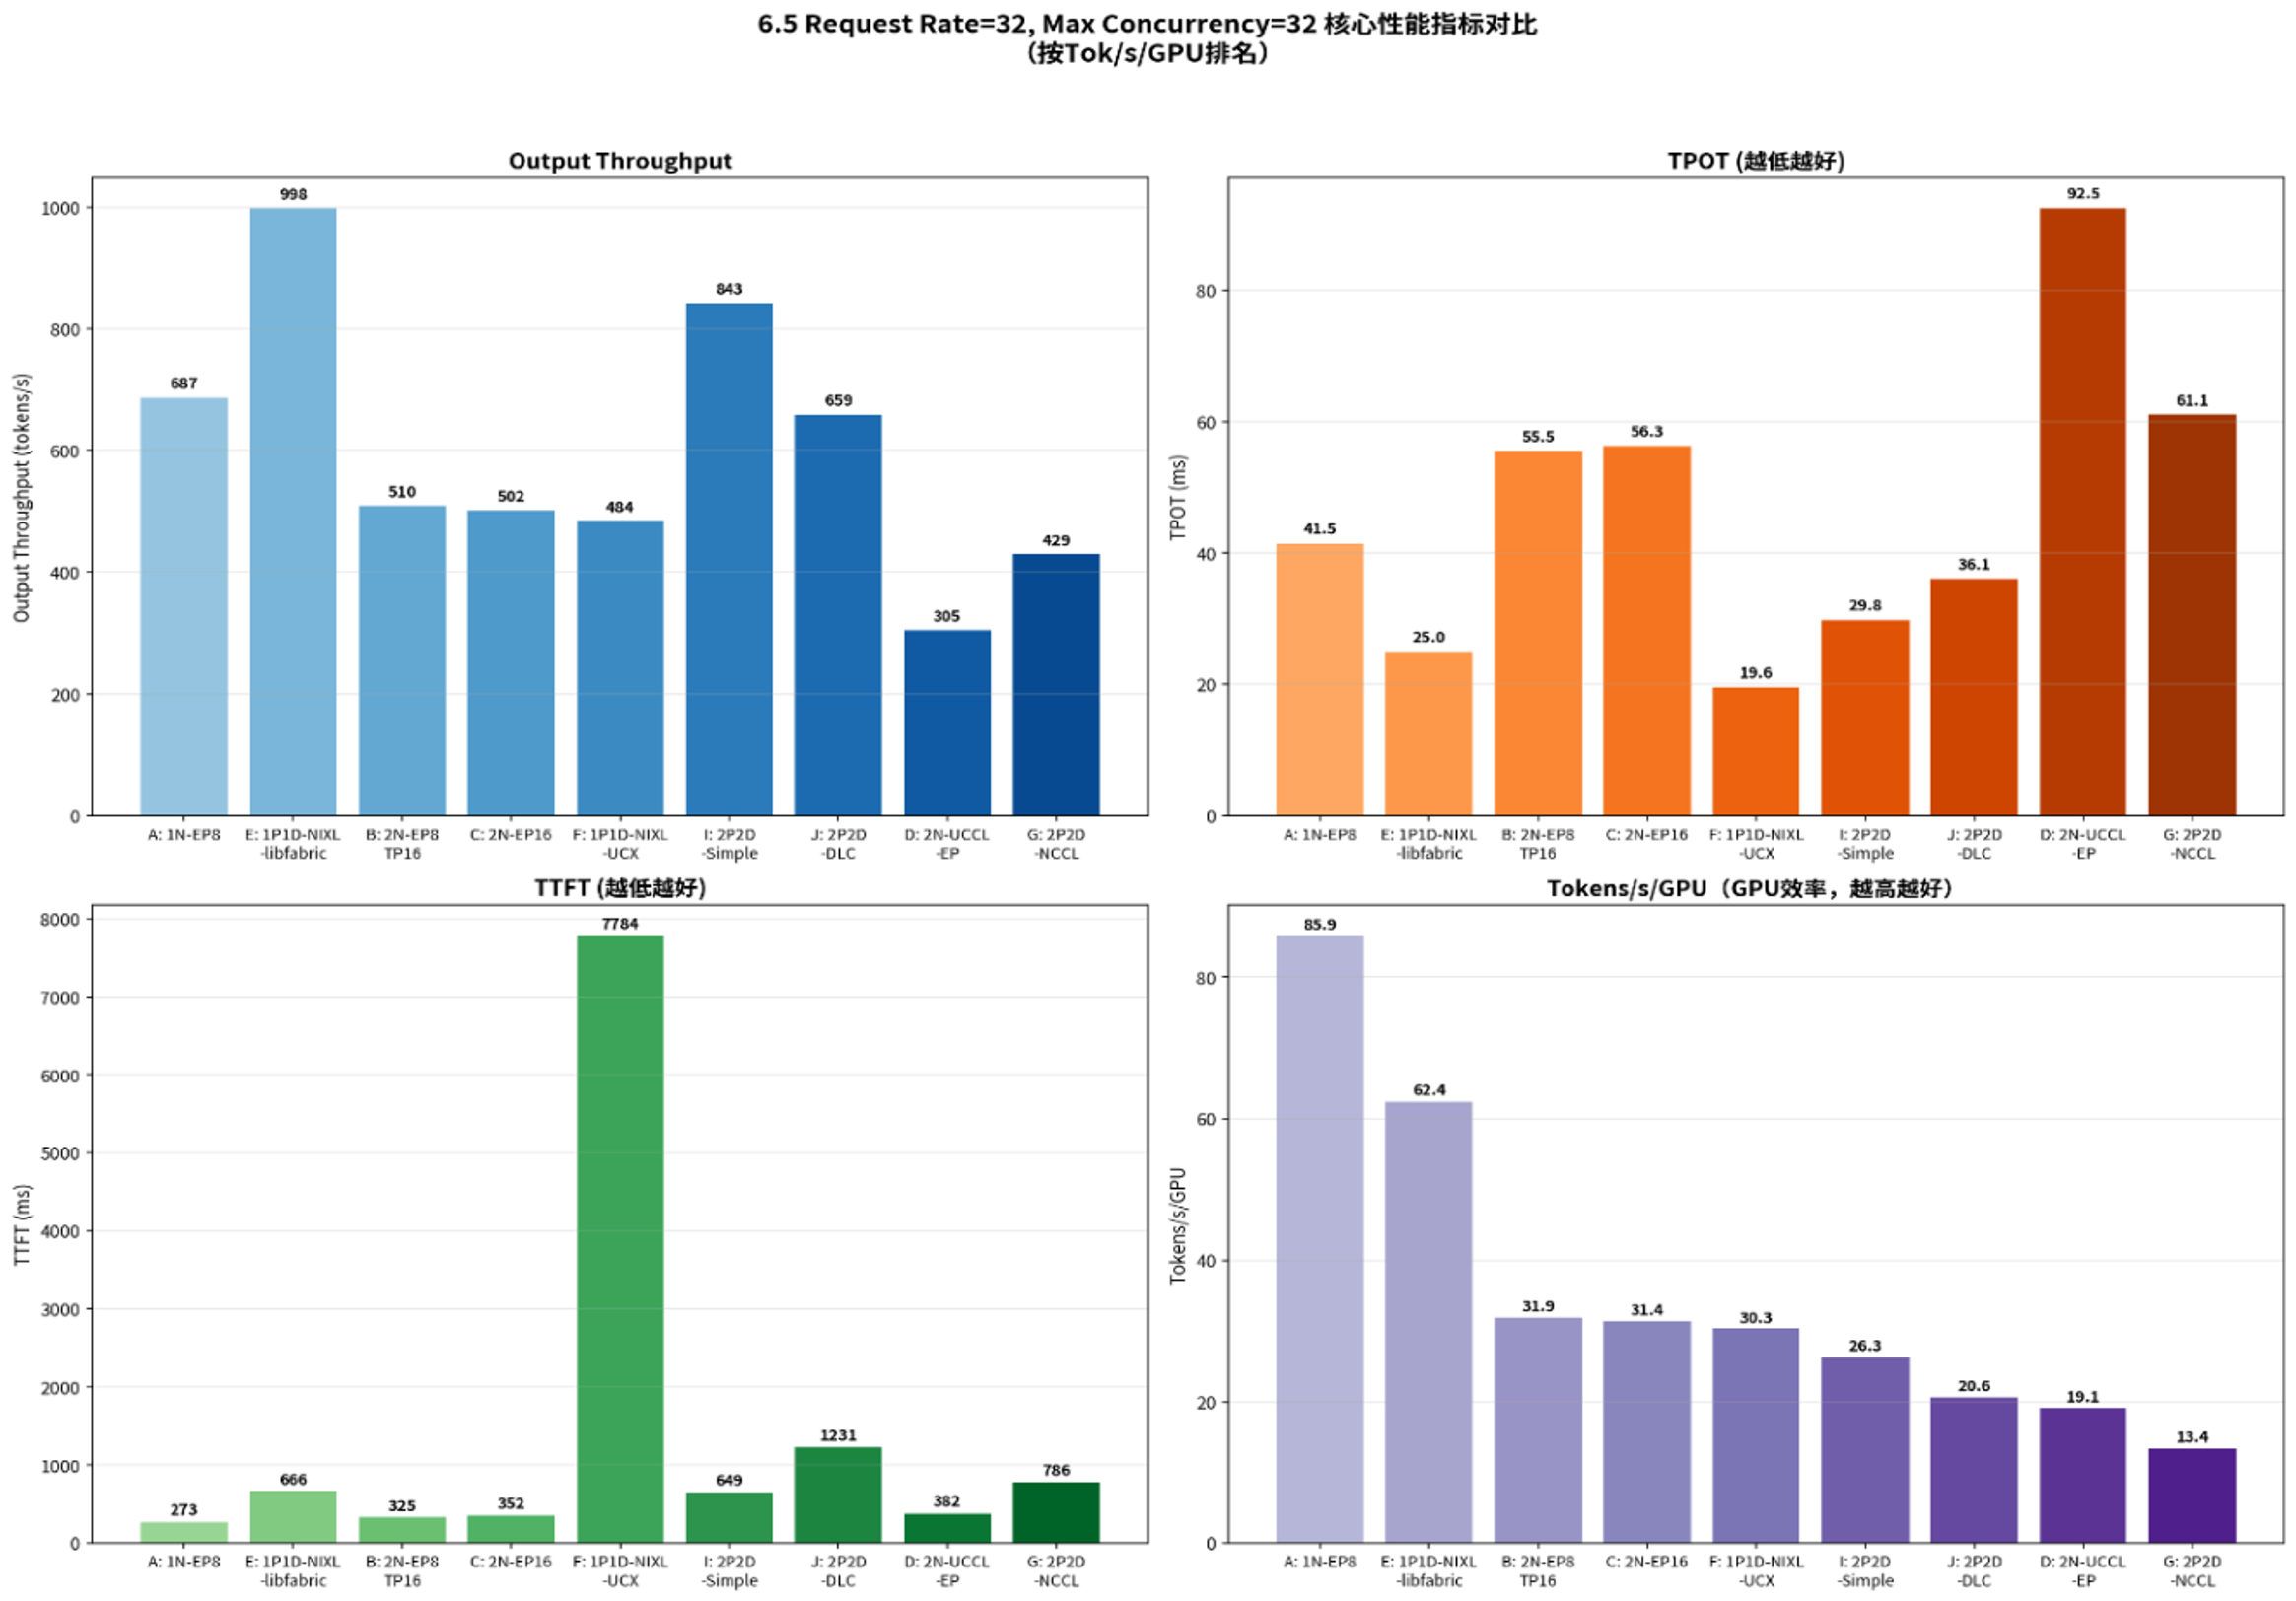
本文系统介绍基于SGLang的大模型推理部署实践,涵盖benchmark方法论、单机/多机Non-PD分离/PD分离等部署方案选型与性能调优。强调测试先行、无万能方案,需case by case验证。通过实验对比指出EP、并行策略、KV传输引擎等选择因场景而异,并提供调试建议与常见问题解决方案。
本文介绍如何优化SQL Server性能,涵盖T-SQL查询调优、索引设计、执行计划分析及实际优化技术。内容包括理解查询执行流程、识别慢查询、编写高效WHERE子句、优化JOIN和聚合操作、避免常见反模式,并通过Query Store和DMV监控性能。强调基于证据的迭代优化,避免过早优化,并展望智能查询处理等未来趋势。
VS Code团队与OpenAI合作,优化了GPT-5.5系统提示,以提高编码效率。通过实验,减少不必要的探索和加快验证降低了成本。最终采用“LargePromptSections”作为默认提示,显著提升了编辑速度和令牌效率,同时保持代码质量。团队将继续寻找改进方法,以提升用户体验。
本文探讨了Flink中RocksDB的状态管理与优化,分析了状态膨胀的原因及其对磁盘占用的影响,主要涉及窗口状态、TTL和MapState的无限增长等问题。提出通过调整RocksDB参数和设计来优化性能,强调在hot key倾斜情况下,改进状态设计比单纯调参更有效,并提供了调优建议和监控指标。
在Linux Debian GNOME Wayland下,机械革命泰钽 Plus 游戏本经历了多次调优。文章讨论了双显卡与独显直连的优缺点,独显直连模式提升了桌面流畅度,但导致腾讯会议摄像头黑屏和屏幕共享问题。最终选择放弃Waydroid,全面转向独显直连,通过调整设置修复了腾讯会议的功能,确保软件正常运行。
本文讨论了在高带宽(如10G及以上)环境下进行服务器网络性能调优的重要性,主要优化方向包括PCIe带宽、内存管理、NUMA架构、CPU调度和中断处理。通过合理配置网卡队列、CPU绑定和中断合并等手段,可以显著提升网络性能,降低延迟和丢包率。调优目标需明确,并根据具体需求进行权衡。
文章讨论了在本地运行小型开源模型的可行性,特别是使用llama.cpp项目。作者分享了在Windows上使用3060显卡运行Qwen3.6 9B模型的设置,包括CUDA版本和参数配置。尽管显存有限,这些模型在简单任务中仍能有效使用。
文章讨论了数据库中表和索引的膨胀问题,提供了计算实际大小、额外大小和膨胀百分比的SQL查询,重点在于识别和优化膨胀超过10%的表和索引。
文章讨论了如何通过修改内核参数和ulimit配置文件来增加Linux系统的连接数限制,默认最大文件描述符数量为1024,建议在开放服务器时进行调整。
完成下面两步后,将自动完成登录并继续当前操作。