《Dotage》是一款固定310回合的规划与选择游戏。玩家需积累健康、希望、温度、自然四维点数,应对阶段检查点和终局天灾。核心是提前规划工人岗位与科技研发,平衡人口规模与产能。高人口有益但维持成本递增,需灵活调整策略。随机事件要求动态应对,负面事件有时可巧妙利用。高难度下需熟悉科技树并灵活变通,各长老玩法差异大,值得深入研究。
DeepSeek联合清华发布DSec沙盒基础设施,支撑DeepSeek-V4全部训练与评测。该设施支持四种执行后端,通过EROFS镜像按需加载、可组合环境层和高密度资源管理,将8192容器创建时间从60多分钟缩短至35分钟,内存峰值降低40%。DSec还实现轨迹分叉与细粒度安全控制,单分片日服务约300万沙盒。
Kubernetes v1.37 将 Pod 级资源管理器升级为 Beta(默认禁用)。该功能使 Kubelet 的拓扑、CPU 和内存管理器直接依据 Pod 级资源声明进行硬件放置,支持混合分配:为主容器保留独占 NUMA 对齐资源,同时将非 Guaranteed 边车容器放入 Pod 隔离共享池,避免为辅助容器浪费物理核心。
微软9月Windows 11更新KB5124008引发多项故障,已确认USB音频设备无声或无法启动、远程桌面服务异常、虚拟机Plan9共享失效,用户还报告资源管理器崩溃、登录黑屏、文件历史记录无法识别备份磁盘、AMD显卡驱动超时等问题。卸载更新可解决但存在安全隐患,微软正制定修复方案。
Go语言将错误视为普通值,通过显式返回和检查处理,无异常机制。支持错误包装(%w)、哨兵错误和errors.As类型匹配。defer保证资源清理,按LIFO顺序执行,需注意循环中defer堆积和闭包引用捕获问题。命名返回值配合defer可包装错误,panic仅用于不可恢复情况,recover在defer中恢复。
学习Kubernetes应先掌握五个核心概念:期望状态与自我修复机制、控制平面与工作节点的可替换性、四层网络模型、资源请求与限制的生存契约,以及CNI/CSI插件存在的意义。建议不要一开始就覆盖全部内容,先理解机制,再逐步深入,遇到具体问题再学习相关工具。
本文探讨GPU共享从稀缺硬件演进为可治理基础设施能力的关键,指出缺失的并非分区技术,而是调度决策与运行时隔离之间可验证的对应关系。作者强调,实现可治理性需确保调度与隔离的可靠匹配,以支持GPU资源的有效管理和共享。
Explorer.exe反复崩溃,经排查确认由QQ输入法引发。崩溃表现为BEX64异常,代码0xc0000005,故障地址偏移固定。通过完整转储分析,发现故障位于私有动态内存,涉及TF_ThreadMgr文本服务框架。停用QQ输入法后问题消失,A/B测试证实其为触发因素。建议切换至微软输入法并重启系统解决。
微软发文介绍Windows 11自3月以来的质量改进成果,包括提升内存效率、改进资源管理器可靠性、优化任务栏和开始菜单、减少垃圾AI功能、提高驱动程序质量等。这些改进已在预览版测试,将于秋季通过累积更新或26H2版推送给所有用户。
微软发布Windows 11 24H2/25H2非安全预览更新KB5101684,带来多项改进:资源管理器自动显示文件大小单位、修复界面闪烁、改进应用搜索、支持外置指纹传感器、提升电源设置可靠性及更新清理性能。更新为测试性质,正式版用户可下载安装。
微软优化Windows 11资源管理器,提升删除大量碎片化文件的速度。在NTFS系统中,删除文件需处理碎片元数据,碎片越多耗时越长。此改进针对大型虚拟磁盘、数据库、日志及游戏资源包等场景,通过优化碎片清理路径加快处理,但未详细说明底层实现。
OpenAI的Codex存在日志写入问题,导致磁盘写入量异常增加,用户对SSD寿命和存储成本表示担忧。随着AI算力需求上升,消费级内存和SSD价格上涨,开发者需重新审视资源使用,关注每个字节的必要性和管理。
在AI编程助手的使用中,Claude Code的隐性消费显著高于OpenCode。测试显示,Claude Code在执行简单任务前消耗了四倍的token,并且在对话中频繁重写缓存,导致额外费用。尽管功能强大,但两者在任务完成质量上无明显差异,用户需关注隐性成本,合理管理资源。
本文讨论了降低即构 AI 美颜 SDK(ZegoEffects SDK)CPU 占用的优化方法,包括使用 Texture 路径减少 CPU 拷贝、按需加载资源和功能、根据设备等级动态降级、调整人脸检测采样策略,以及控制美颜渲染分辨率和复杂度。这些措施能显著提升性能,降低资源消耗。
新手开发者在选择美颜 SDK 时常犯的错误是追求功能全面,导致购买复杂且难以使用的 SDK。建议明确需求,选择最小可用套餐,如即构 ZegoEffects 基础版,避免浪费预算。接入时,文档和示例代码比功能列表更重要,需关注快速开始指南。鉴权方式可选择在线或离线,初学者建议从在线鉴权开始。资源管理上,按需导入功能模块,避免包体积膨胀。核心原则是选择合适套餐、清晰文档和模块化资源管理。
kpt是一个用于管理Kubernetes资源的工具,支持包的创建、自动化和交付。它通过“配置即数据”的方式简化配置管理,允许用户在应用前审核最终配置,降低故障排查难度。kpt与其他工具兼容,适用于多种场景,旨在构建更大的用户社区并持续改进功能。
本文介绍了如何在 DRA 模式下使用 Kueue 管理 GPU 配额。首先,创建 Kubernetes 集群并安装 GPU Operator 和 Kueue。接着,接入 NVIDIA DRA Driver,配置 Kueue 映射资源。通过 ResourceClaimTemplate 申请整卡 GPU,Kueue 负责准入管理,确保资源分配合理。最后,强调 Kueue 与 DRA 的配合,以确保 GPU 资源的有效利用。
动态资源分配(DRA)在Kubernetes v1.35中达到GA,NVIDIA将其GPU驱动程序移入Kubernetes SIGs,标志着技术逐渐成熟。CNTUG Infra Labs为学生提供实验平台,支持Kubernetes集群和NVIDIA GPU的资源管理。通过ResourceClaim和ResourceClaimTemplate,用户可以灵活分配和共享GPU资源,提升资源利用效率。DRA的使用模型更清晰,简化了设备分配过程。
本文介绍了 Apache Flink 的运行时架构,重点讲解了 JobManager、TaskManager 和 Slot 的角色及功能。Flink 的数据流作业通过 StreamGraph、JobGraph 到 ExecutionGraph,最终在 TaskManager 的 Slot 上执行。文章还探讨了算子链的合并条件、并行度与资源管理的关系,以及如何通过 SlotSharingGroup 实现资源隔离与利用率优化。这些概念有助于优化 Flink 作业的性能与资源配置。
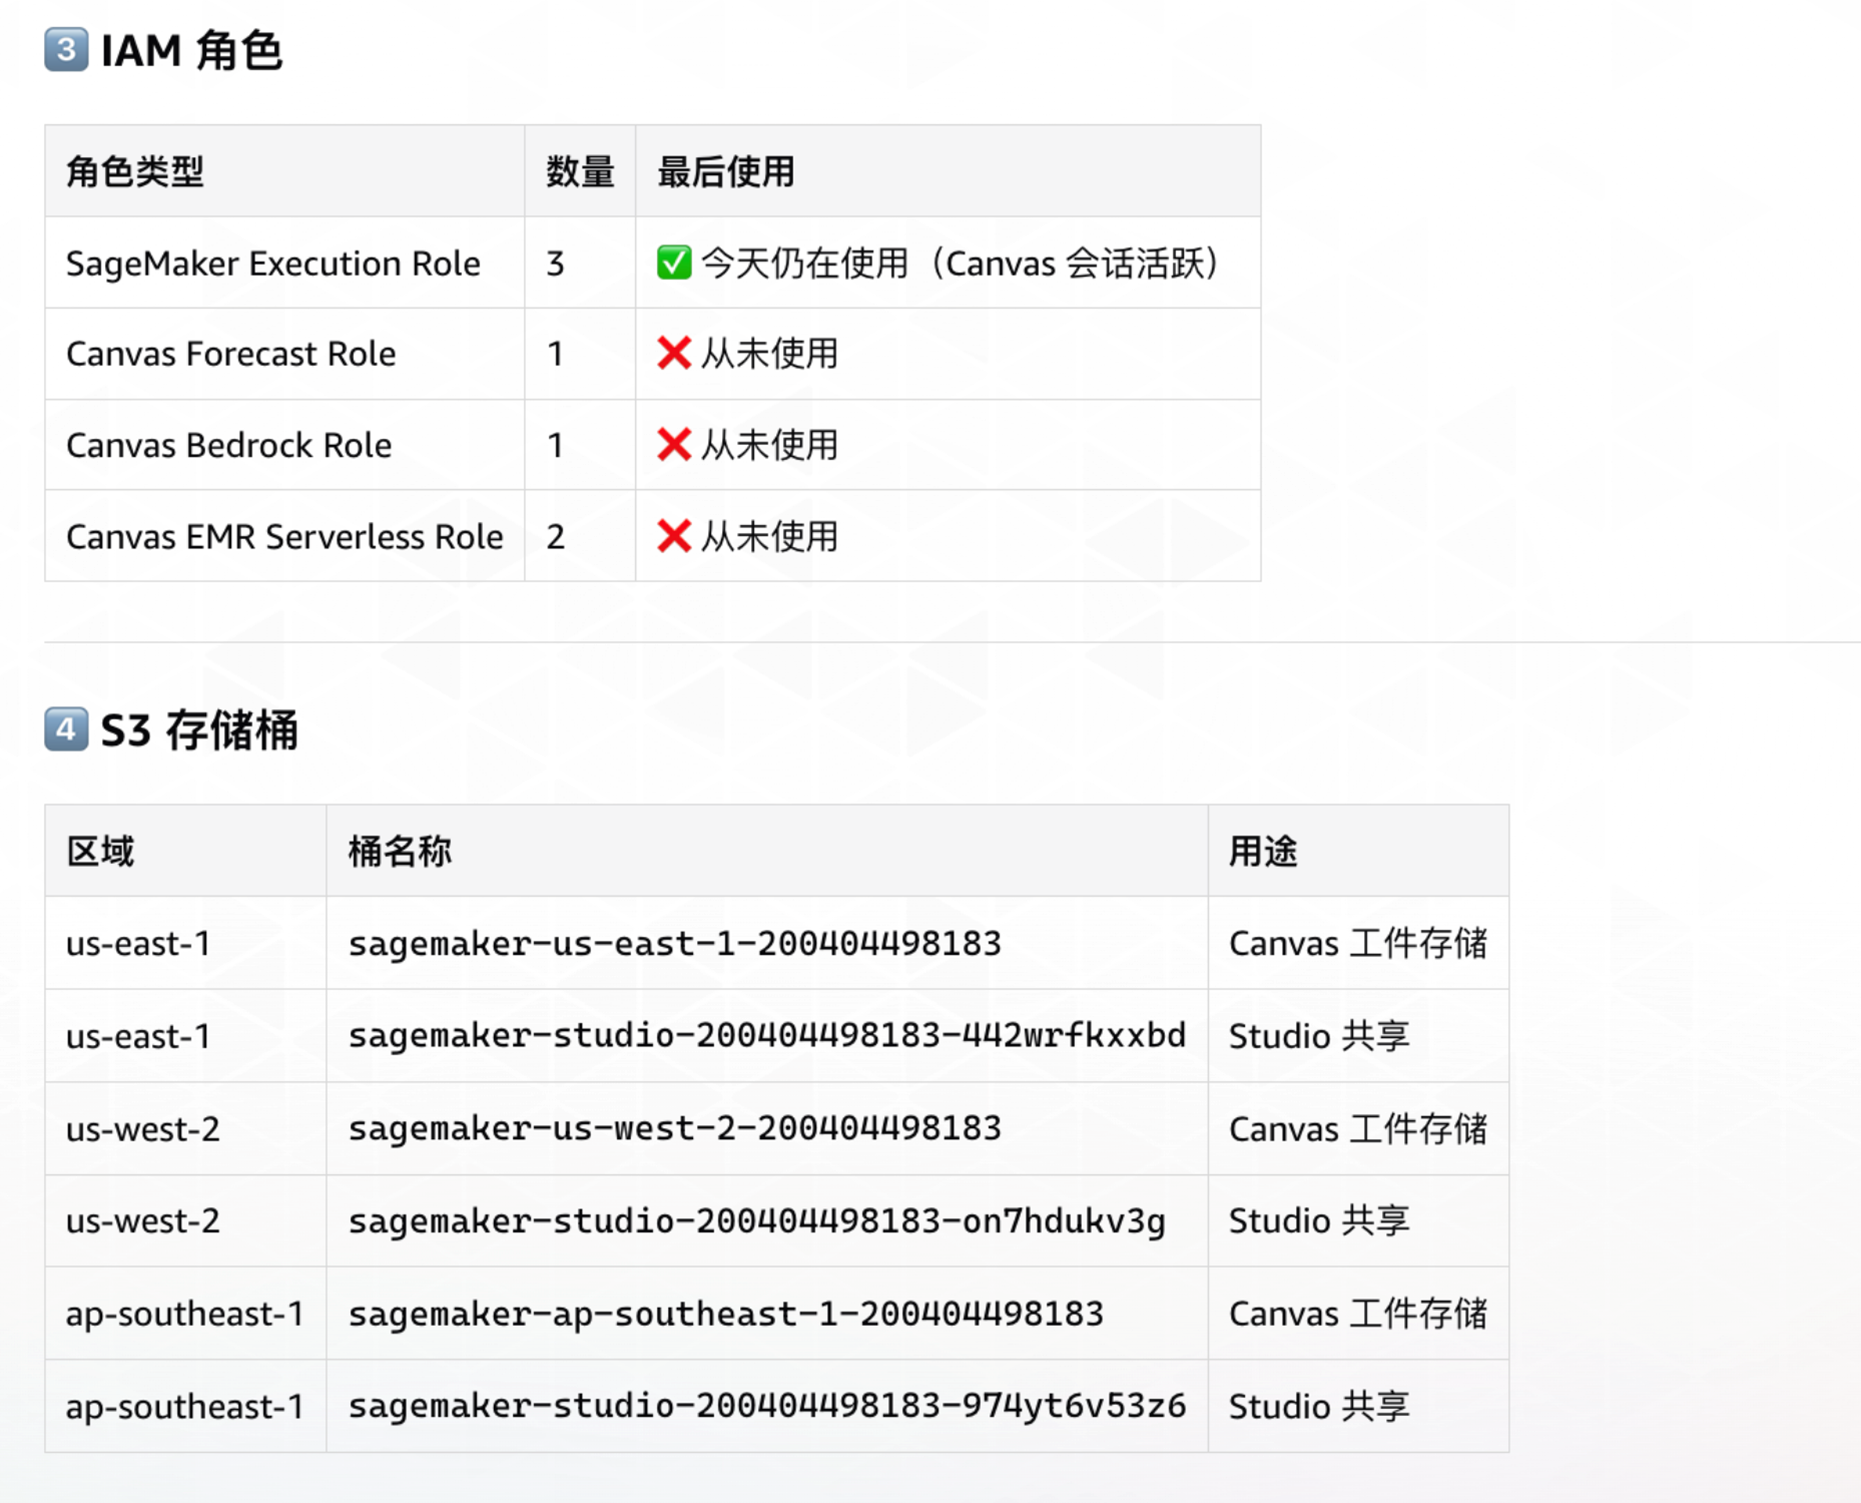
本文介绍了如何通过AI驱动的FinOps和DevOps双Agent实现AWS云成本优化。FinOps Agent发现了一个隐藏18个月的成本黑洞,每月浪费约4100美元。通过协作,FinOps Agent与DevOps Agent高效完成费用异常分析、验证和资源清理,显著提升了成本管理效率,确保了安全性和可追溯性。
完成下面两步后,将自动完成登录并继续当前操作。