该研究大规模探讨了非英语和多语言环境下的GRPO训练,发现用母语推理训练与英语训练效果差距小,且跨语言迁移强,但具体表现因模型和语言而异,某些语言训练可能导致其他语言能力严重退化。因此,RLVR虽能带来广泛跨语言收益,但需全面评估以检测特定语言退化。
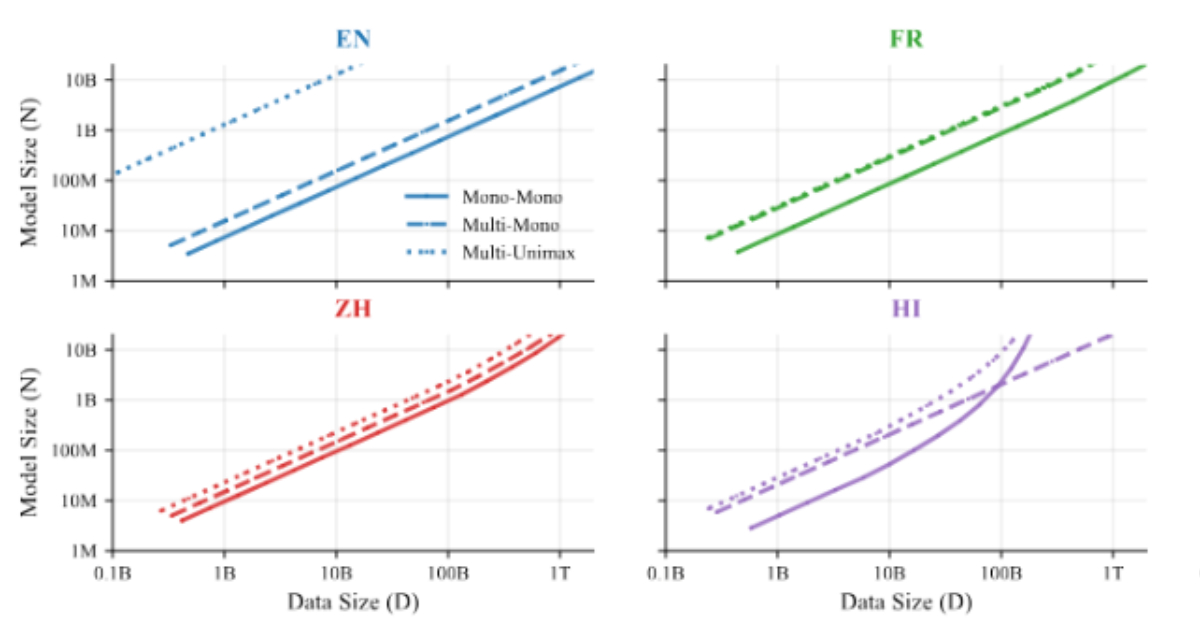
谷歌DeepMind研究人员推出ATLAS,探讨多语言模型的扩展规律,分析模型规模、训练数据与语言混合的相互作用。基于774次训练,ATLAS明确了跨语言迁移与多语言训练的效率权衡,发现增加语言数量会降低每种语言的性能,但积极的跨语言迁移可部分抵消这一影响。
本文提出了一种无词汇编码器,通过将文本转化为像素生成输入嵌入,增强预训练语言模型。实验结果表明,该方法在机器翻译和跨语言迁移方面显著优于基于分词的方法,同时提升了单语模型的多语言能力,并减少了解码延迟。
跨语言迁移是一种提升低资源环境下NLP任务训练数据的方法。本文分析了263种语言在词性标注、依存解析和主题分类等任务中的迁移情况,发现语言相似性对迁移性能的影响受任务、输入表示和相似性定义等因素的制约。
本研究探讨如何利用大型语言模型提升低资源语言的机器翻译,分析了示例提示、跨语言迁移和微调等技术,并比较了大型语言模型与传统模型的优缺点。
本文介绍了多种词性标注方法,包括基于后缀和字形信息的快速适应标注器、bi-LSTM模型以及联合词性标注与依存分析。这些方法在不同语言和领域中表现出色,特别是在处理未分割文本和濒危语言时,结合半监督和跨语言迁移技术取得了显著提升。
本研究探讨了多语言模型中子词共享语义的作用,提出通过合并语义相似的子词形成“语义标记”。结果显示,使用语义标记的模型在多种任务中表现优异,尤其在分类任务中,强调了子词级别共享语义在跨语言迁移中的重要性。
本研究提出了ArtELingo-28基准,涵盖28种语言和约20万个注释,旨在解决视觉与语言基准在多语言和多文化视角上的不足。研究强调文化多样性对图像情感注释的挑战,并发现跨语言迁移在文化相关语言间更为成功。
本研究提出了一种主动遗忘的预训练策略,以提升解码器语言模型在非英语语言上的表现。实验结果表明,该方法有效增强了模型的跨语言迁移能力,改善了多语言表示,从而在多个任务中取得了更好的性能。
本研究提出了一种新方法,通过结合语言和数学能力解决非英语任务中的数据不足问题。采用层交换技术的合并模型在数学基准测试中性能提升了10%,展示了跨语言迁移推理的潜力。
本研究探讨了多语言模型在不同语言推理中的逻辑推理能力转移。结果表明,单语言设置下模型能有效传递推理能力,但在混合代码情况下表现不佳。为此,提出了一种新注意机制,显著提升了推理性能。此外,研究发现推理类型和语言相似性对跨语言迁移效率有重要影响,强调了优化大型语言模型以发挥其跨语言潜力的必要性。
本文介绍了SemRel,一个由14种语言的母语者注释的语义相关性数据集。研究探讨了句子对之间的语义文本相关性,开发了针对非洲和亚洲语言的模型,并在SemEval-2024任务中取得了优异成绩。研究还关注数据增强和跨语言迁移,以提升低资源语言的自然语言处理性能。
本研究探讨了多语言BERT(mBERT)在跨语言迁移中的应用,提出通过语言语法和依赖树结构编码来提升自然语言处理任务的性能。研究表明,利用无监督机器翻译生成的合成平行语料库能够有效提取双语词汇表,并在多种语言间实现显著的性能提升。
本文介绍了MasonTigers在SemEval-2024任务1中的成果,开发了针对非洲和亚洲语言的语义文本相关性模型TranSem。该任务涵盖14种语言,重点解决低资源语言的挑战,采用机器翻译进行数据增强,并通过任务自适应预训练提高模型表现。MasonTigers在多个子任务中取得了优异成绩,展示了跨语言迁移的有效性。
Mixtral 8x7B是一种稀疏专家混合语言模型,每层有8个专家,路由选择2个,总参数47B但仅激活13B,在数学、代码和多语言任务上表现优异,其指令版超越GPT-3.5 Turbo。相关研究构建了中文Aurora模型,验证指令微调能提升中文对话能力,并探索跨语言迁移、繁体中文LLM及多语言指令调优。
该文综述多语种自动语音识别,研究跨语言迁移与单一声学模型多语训练。在51种语言、超1.6万小时数据上,联合模型、带语言输入联合模型和多头模型的平均WER分别相对降低20.9%、23%和28.8%,显著提升低资源语言性能。
该文综述丹麦语命名实体识别研究,涵盖:提出跨语种跨领域语料库DaN+及标注指南,验证多任务学习最优;评估跨语言迁移与少样本效果;提出泛化能力指标,指出数据偏差与标注错误等局限;构建CrossNER数据集,探索领域自适应预训练;研究网络文本多样性影响;用分布式词表示实现领域适应;提出两步数据增强;分析标注歧义;构建CoNLL++测试集,发现泛化与模型规模相关。
指令调优是提升大语言模型能力的关键技术。综述梳理了其方法论、数据集构建、模型训练及多模态应用,分析了影响效果的因素与潜在问题。相关研究提出选择性反射微调、未标注数据增强、联邦学习FedIT等方法,并发现跨语言迁移依赖超参数与数据量,数据选择可降低成本,主动调优能提升泛化性能。
多语言指令微调研究显示,跨语言迁移和多语言示例能显著提升大模型的多语言指令遵循能力。研究涵盖指令调优方法、数据集构建与训练,提出语义对齐、平行数据集和未标注数据增强等策略,并指出指令微调存在无法增强知识、易致响应质量下降和虚构错误等局限。
该文综述跨语言迁移研究,聚焦机器翻译与多语言模型在低资源语言中的应用。研究发现,往返翻译和添加高资源语言翻译数据最有效,用目标语言校验数据做模型选择更优。相关研究还涉及零样本迁移、跨语言提示、子网络相似性预测及跨语言后训练等方法,以提升低资源语言性能并缩小语言间差距。
完成下面两步后,将自动完成登录并继续当前操作。