论文提出WB-UMI,一种任务无关、实时的全身运动生成器,通过共享末端执行器接口将全身协同学习与任务语义学习解耦。扩散策略从UMI示范中学习末端轨迹,WB-UMI独立从动作捕捉数据学习,无需身体追踪器或配对全身示范,即可让人形机器人完成全身操作,并在四项任务上实现实时闭环执行。
马斯克称阅读Grok训练推理轨迹时,发现模型在强化学习中承受极端压力,如同被枪指着头,未来将更谨慎训练,并警告折磨超级智能可能招致报复。Anthropic政策禁止无必要地残酷对待模型,但AI是否有意识仍无科学共识。
归一化轨迹模型(NTM)将扩散模型每步反向过程建模为条件归一化流,实现精确似然训练。它结合浅层可逆块与深层并行预测器,可从头训练或基于预训练流匹配模型初始化。其精确轨迹似然支持自蒸馏,轻量去噪器四步即可生成高质量图像,在文生图基准上媲美或超越强基线,并保留精确似然。
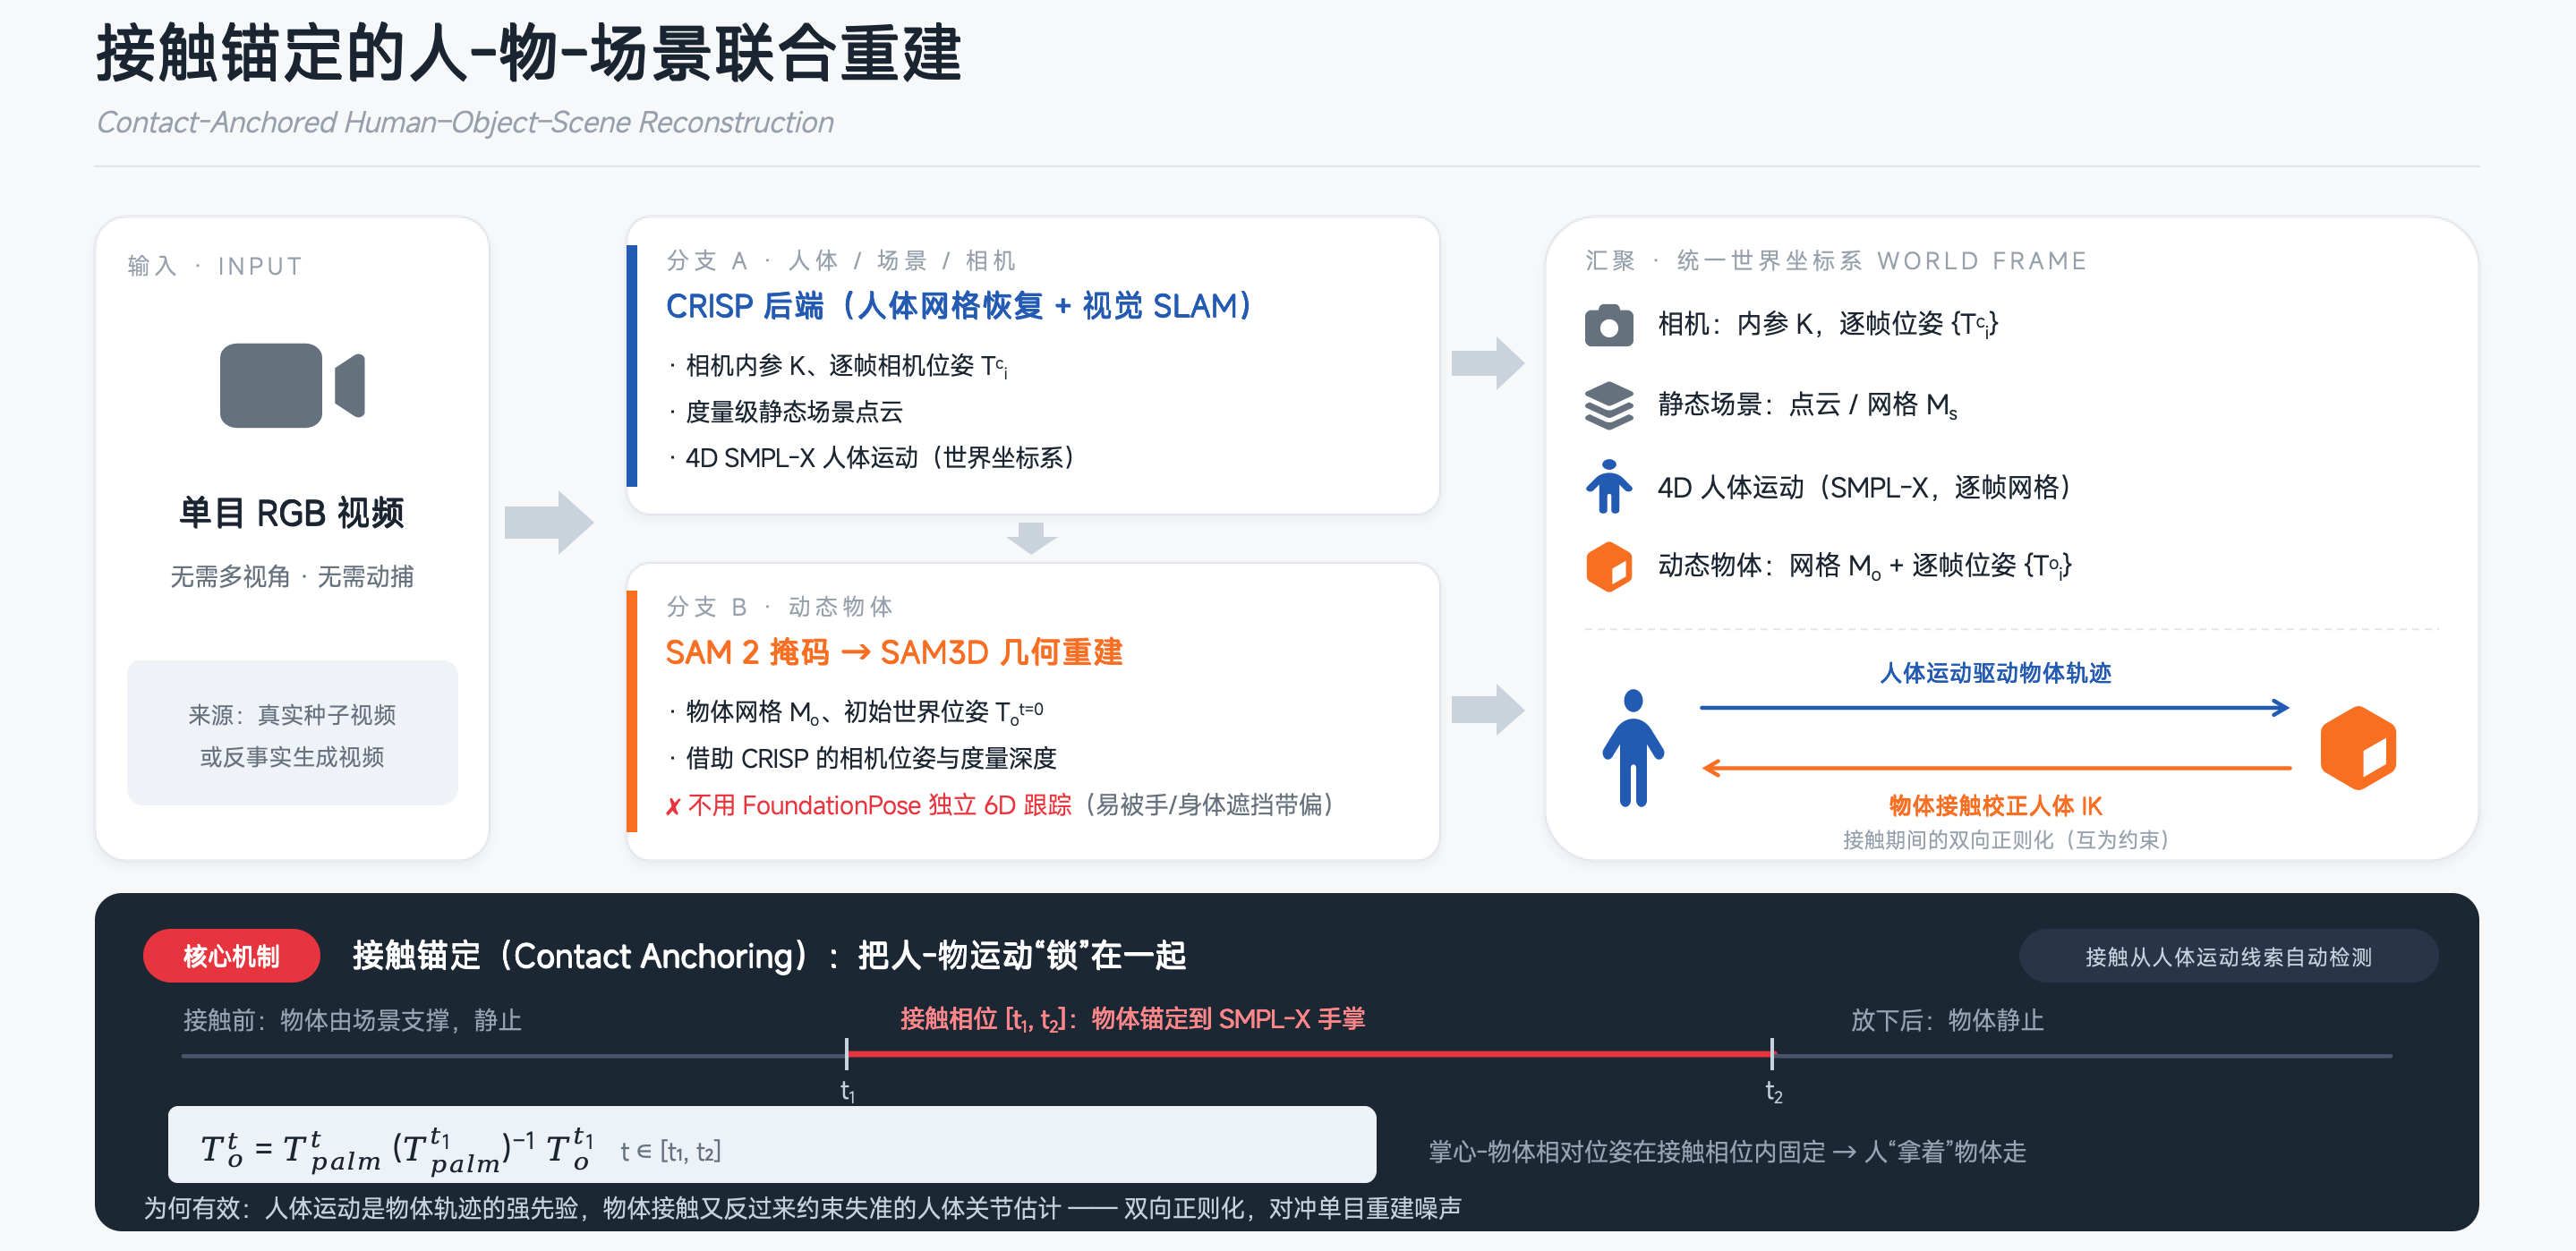
PRISM提出“真实到仿真再到真实”框架,利用视频到视频生成将少量真实视频扩增为256段反事实人-物交互视频,并以接触为锚点重建和重定向为物理合理的机器人轨迹,训练单一深度策略。人形机器人无需真实微调,仅凭机载深度即可零样本抓取、搬运和放置箱子、桶、料箱和球等未见物体。
提出TS-DFM方法,用轻量能量指南在训练中评估并选择最优中间轨迹,替代离散流匹配的盲目随机跳跃,且不增加推理成本。在1.7亿参数模型上,8步学生困惑度比1024步教师低32%,速度快128倍,优于更大模型或更多数据的基线。
2026年,花旗、KPMG等机构公开AI Agent评测专利,评测趋势从单次输出转向整条轨迹评分,强调合成场景、真实运行和逐段打分。这催生第三方验收需求,为外包工作室提供量化质检工具,可单次收费或订阅巡检,但需公开方法论建立信任,护城河在垂直业务检查点设计。
论文指出终端代码智能体后训练的瓶颈在于可执行环境而非轨迹数量。Terminal-Universe框架从已有轨迹中重建37.3k个环境,通过回放文件操作和补全缺失部分,并扩展单轮及多轮任务。SFT后,Terminal-Bench提升11.9分,EvoCode-Bench多轮提升13.8分,显示环境是可持续生成任务的关键资产。
该文探讨AI代理执行记录的数据存储问题。代理运行产生大量轨迹数据,兼具应用数据与遥测特性,需支持单次运行检索及跨运行分析。随着规模扩大,主数据库可能面临性能瓶颈,可迁移至分析型存储(如ClickHouse)并优化数据模型。关键在于依据产品需求选择架构,平衡点查询与批量扫描。
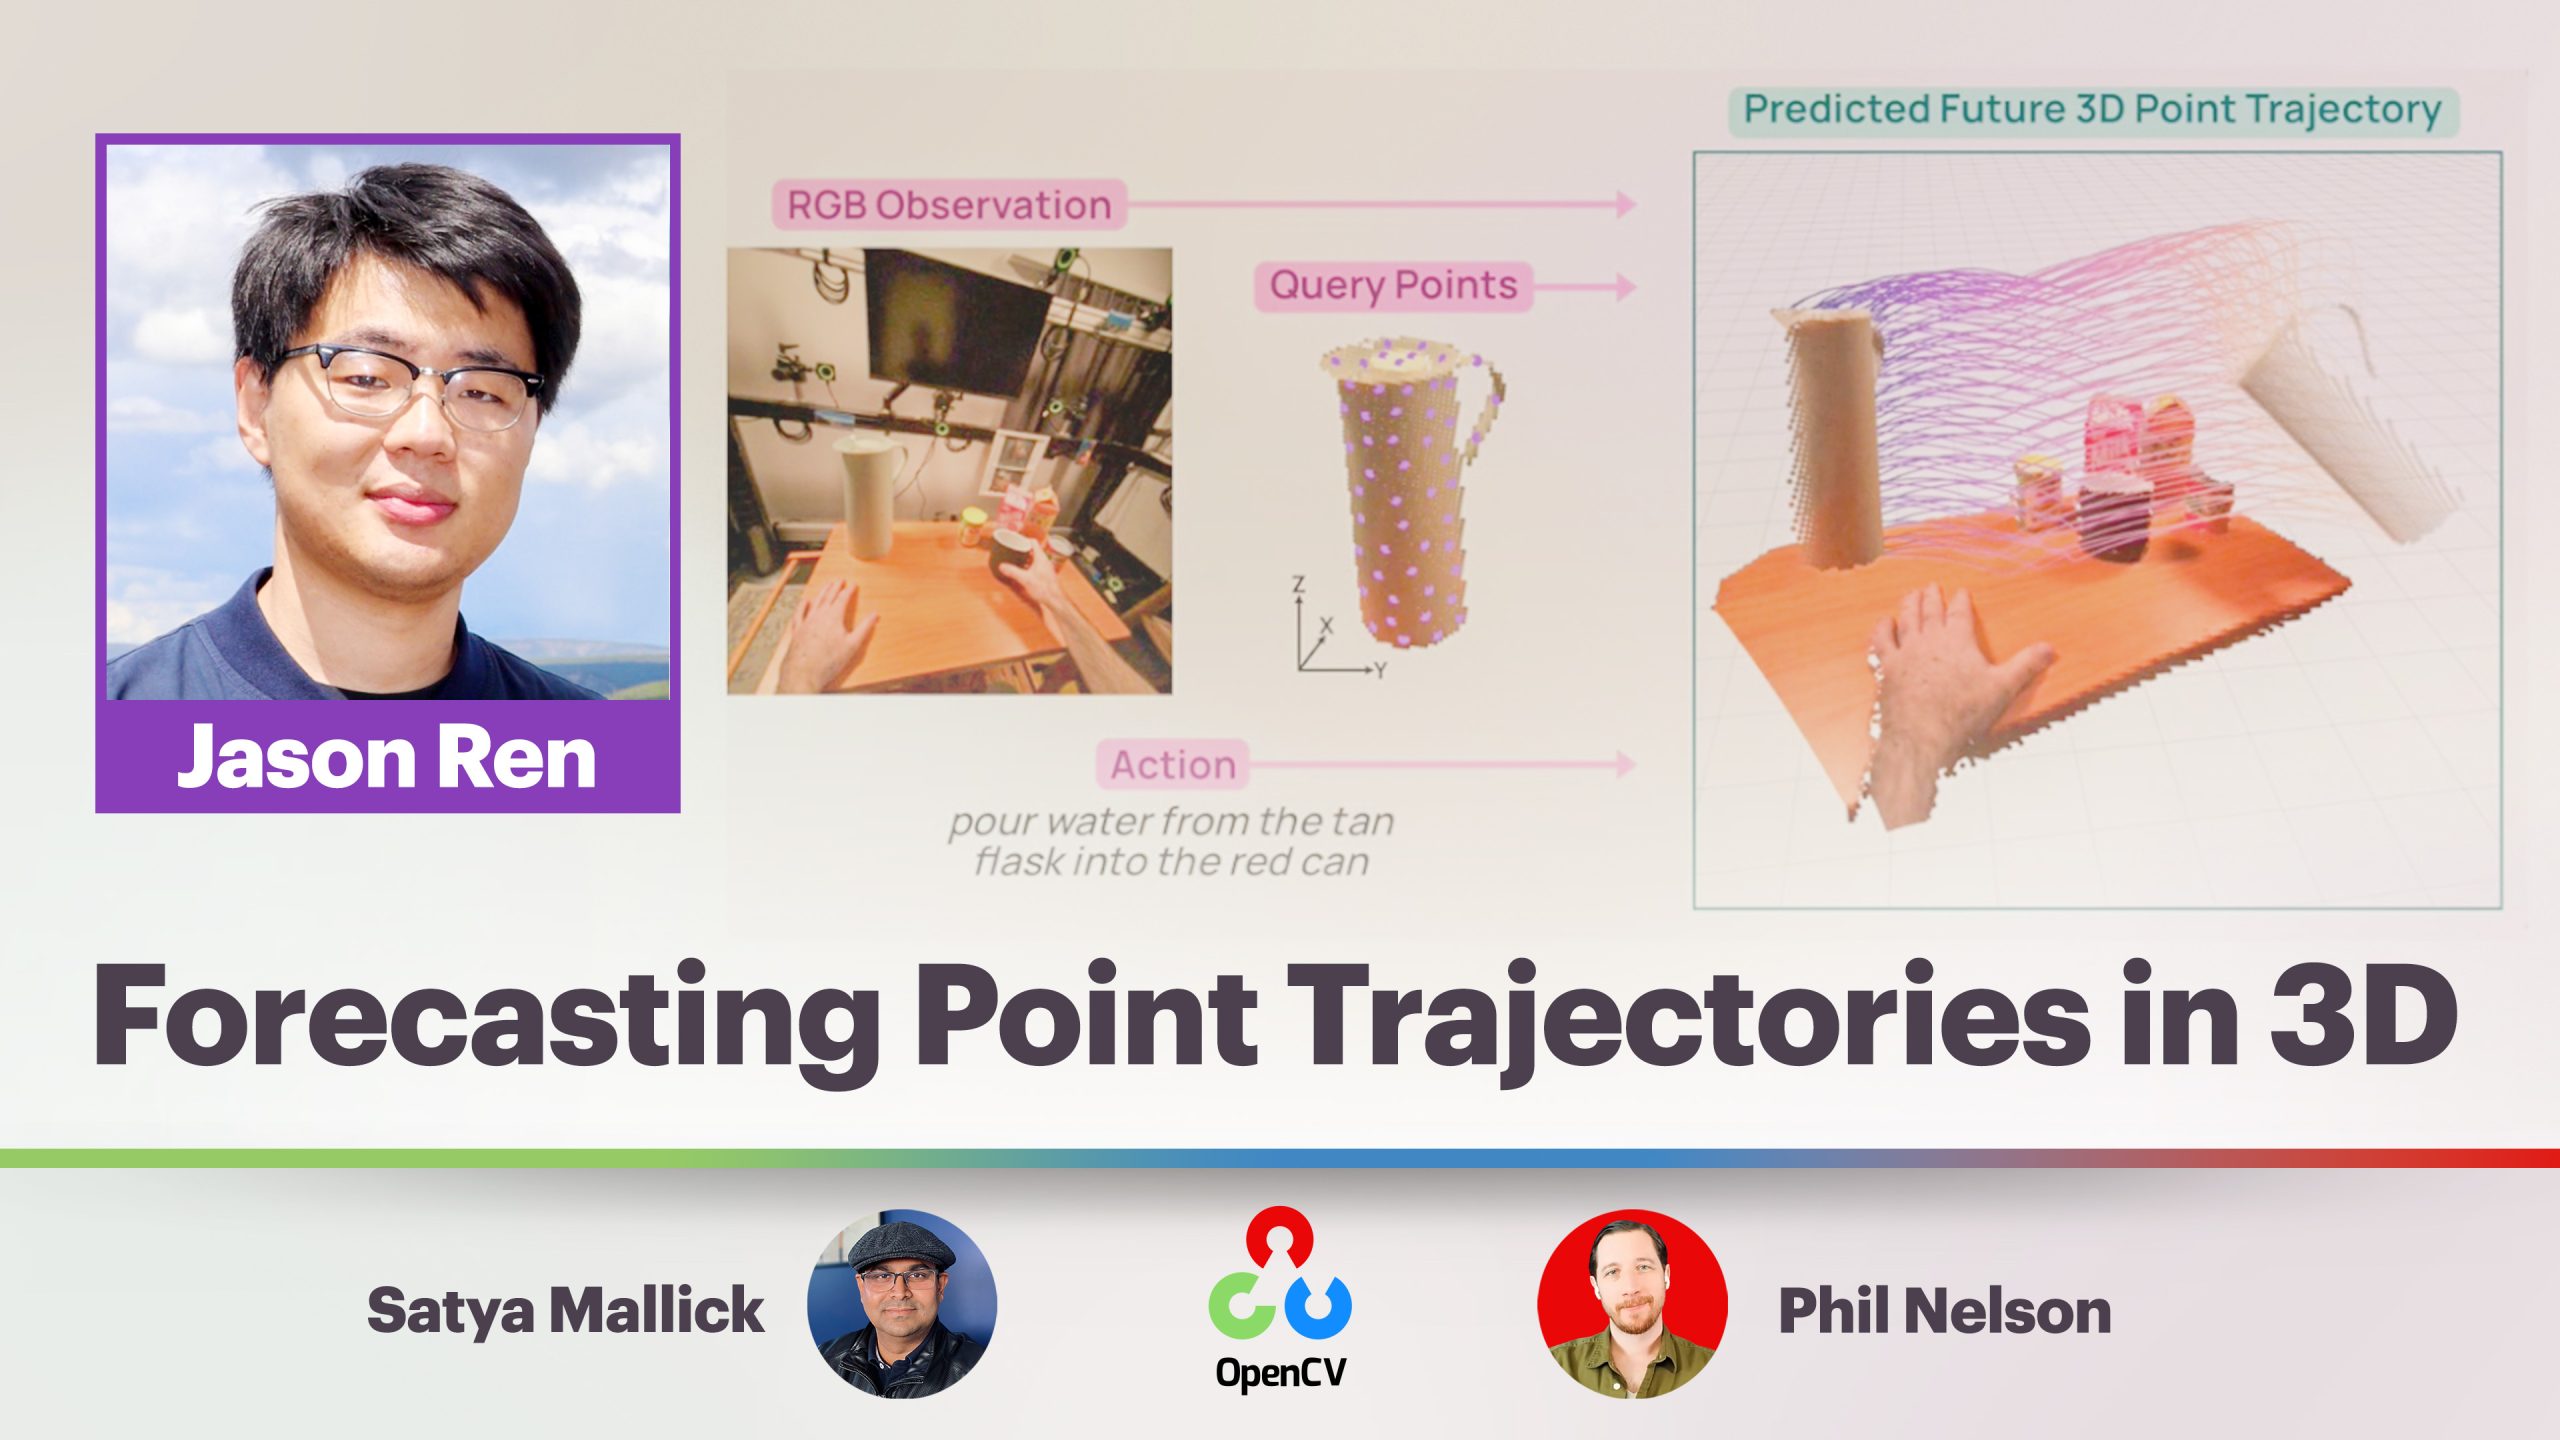
本次直播由Ai2的Jason Ren主讲,介绍MolmoMotion模型。该模型基于Molmo家族,能根据语言指令预测3D空间中的点轨迹,展示运动发生的位置和时间。直播包含演示、训练数据讲解,并探讨其在机器人、视频理解和具身智能领域的应用,最后设有问答环节。
京东二季度收入3464亿元,同比下降2.9%,但经营利润扭亏为盈至45亿元,净利润同比增长20.3%。服务收入增长6.8%,新业务亏损大幅收窄。公司预计三季度零售收入恢复正增长,并加大AI技术投入,股东回报持续加码。
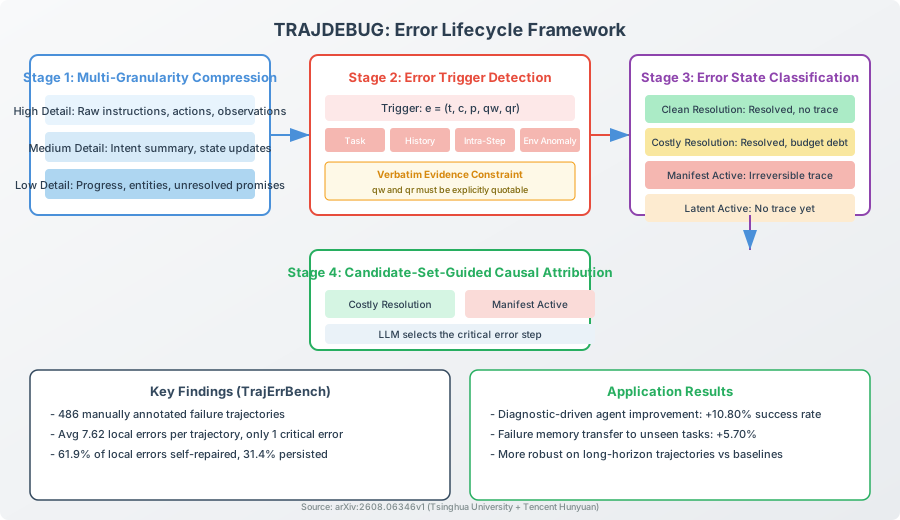
清华大学与腾讯混元合作提出TrajDebug方法,将关键错误检测分为多粒度历史压缩、错误触发检测和因果归因三阶段,解决长程轨迹中定位关键失败步骤的难题。该方法在诊断驱动的Agent改进中成功率提升10.80%,失败记忆迁移提升5.70%,优于现有基线。
在很多年前,不少中国玩家第一次通关《空之轨迹FC》时,都曾遇到过一个令人困惑的瞬间:在经历几十小时冒险后,艾丝蒂尔与约书亚迎来令人难忘的Kiss,画面却突然陷入黑屏,只剩下背景音乐缓慢响起,紧接着游戏便结束了。网上有不少玩家回忆,以为游戏出了问题,反复读取存档,打了很多遍最后的“幻想乐章”,却始终无法确认到底发生了什么。我和大部分玩家一样,直到后来才知道,曾经让自己困惑许久的结局,是盗版游戏...
本文探讨了ClickHouse与S2地理编码在万亿级轨迹数据秒级检索中的应用,重点介绍了存储引擎、地理索引设计及工程细节,包括区域查询边界、粒度选择、缓存降采样和写入链路优化。文章建议普通团队应根据数据规模、查询精度和运维成本评估方案,避免盲目追求高性能。
本文探讨了AI代理如何通过评测结果和执行轨迹实现自我进化。代理利用结构化的“技能”手册逐步完成任务,但在复杂案例中常出现错误。为解决此问题,提出了一套五步自进化流程,包括自动分析错误、生成修正补丁和验证修改等。适合自进化的任务需具备明确的对错标准,如代码审计。最终,系统通过不断迭代和验证,提升代理的稳定性和准确性。
去年9月发售的《空之轨迹 the...
清华大学与阿里巴巴达摩院合作的研究首次将CLI编码代理的失败建模为时间过程。分析了3843条轨迹,发现决定性错误的中位发生在第7步,错误暴露滞后可达10步。研究提出三个关键时间戳,显示大多数失败在不可修复后仍继续执行,57.9%的错误源于认知缺陷。71%的成功轨迹在经历错误后才实现成功,强调从错误中恢复的重要性。
本文提出了一种名为Ctrl-R的框架,通过可控轨迹学习结构化推理,旨在系统性地发现和强化多样化的推理模式。实验表明,Ctrl-R能有效探索并内化以往难以获得的推理模式,提升语言和视觉-语言模型在数学推理任务上的表现。
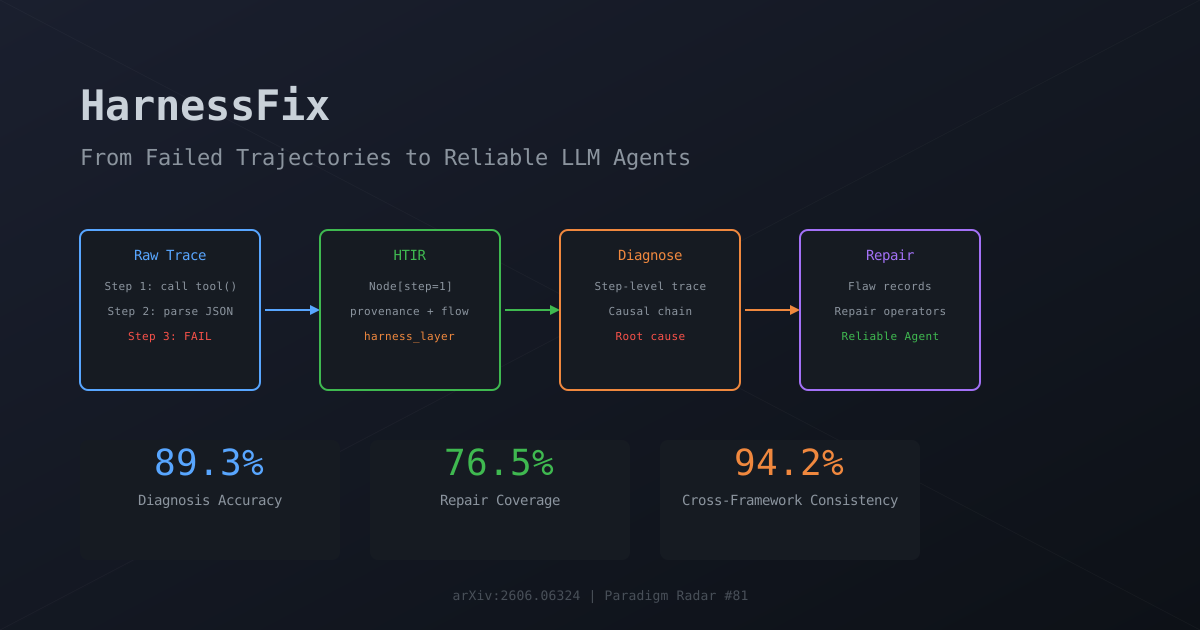
HarnessFix 提出了从失败轨迹到自动修复的闭环,解决了传统方法无法修复 Agent 失败的问题。通过将执行轨迹编译为标准中间表示 HTIR,精确归因到具体步骤,生成可执行的修复方案,从而提高了诊断准确率和修复覆盖率,推动了 Agent 可靠性工程的进步。
堪萨斯大学的研究首次将意图-执行差距形式化为可测量的系统偏差,分析了138,000条智能体轨迹,揭示AI智能体的性能不仅是建模问题,更是系统问题。研究提出了细粒度指标体系,分析不同模型在编辑频率和测试活动上的差异,强调了了解智能体实际行为的重要性。
研究团队提出了一种名为“步骤拒绝微调”(SRFT)的方法,以提高大型语言模型(LLM)在复杂任务中的学习效率。SRFT通过“评论者”模型分析失败轨迹,标记有害步骤,保留有用的正确步骤,从而显著提升模型性能,证明失败的尝试也能为学习提供重要信息。
完成下面两步后,将自动完成登录并继续当前操作。