本文以 Koog 1.3.0 的 Kotlin API 为例,讲解模型调用的输入与输出。输入方面,user 消息可混排文本与图片、音频、视频、文件等附件,但多模态支持取决于 provider 和模型能力,例如 DeepSeek V4 Flash 不支持 document 附件。参数方面,LLMParams 可在 prompt、子图、会话三层生效,包含 temperature、maxTokens、toolChoice、schema 等字段,并有构造期校验。输出方面,流式调用 requestLLMStreaming 返回 Flow<StreamFrame>,可用 collectText 拼接文本,也可边流式边解析 Markdown 为对象;结构化输出用 data class 加注解生成 schema,requestLLMStructured 返回 Result,解析失败可由 StructureFixingParser 自动修复。文中还提及 Anthropic 与 Bedrock 的提示词缓存配置差异。
谷歌向开发者开放旗舰模型Gemini 4 Argon,定价与GPT-6.1 Sol相同,12月起涨价。该模型提供100万输入输出共享token额度,ERQA测试得分87%,编程越权率仅2%,并已在谷歌内部广泛使用。
文章以客服工单为例,指出结构化输出仅保证JSON形状,不保证业务正确。作者用Python结合JSON Schema和本地validate函数复核分类、金额和必填字段,超限退款只进人工队列,并提醒处理漏字段、金额格式和网络超时,同时保存原文、模型与Schema版本及校验结果。
Google发布Gemini 4 Argon,单次输出上限提至100万Token,面向软件工程与企业Agent。模型可在单条轨迹内规划、调用工具、改代码并验证,减少多回合交接损耗,但放大成本失控、错误累积与审计难度。厂商内部案例显示代码迁移等收益,但缺独立复现。企业需设预算、检查点与人工审批,不能把百万Token当作取消任务拆分的理由。
提示工程是从零设计提示,提示优化则改进已有提示。文章以一份混乱的会议记录为例,介绍五种经实证有效的优化方法:指定结构化输出(如JSON模式)、赋予角色人设、精选多样化少样本示例、对模糊情况使用思维链推理,以及用真实测试用例自动迭代搜索最优提示片段。核心是停止凭感觉猜测,改为针对真实案例测试可验证的具体改动。
流式JSON报错源于逐块解析,正确做法是按事件仅收集文本增量,拼接后在流结束再解析校验。文章以Gemini结构化流式输出为例,给出Pydantic模式与代码,强调处理背压、断线重试、跳过未知事件,且校验通过前不得触发业务。
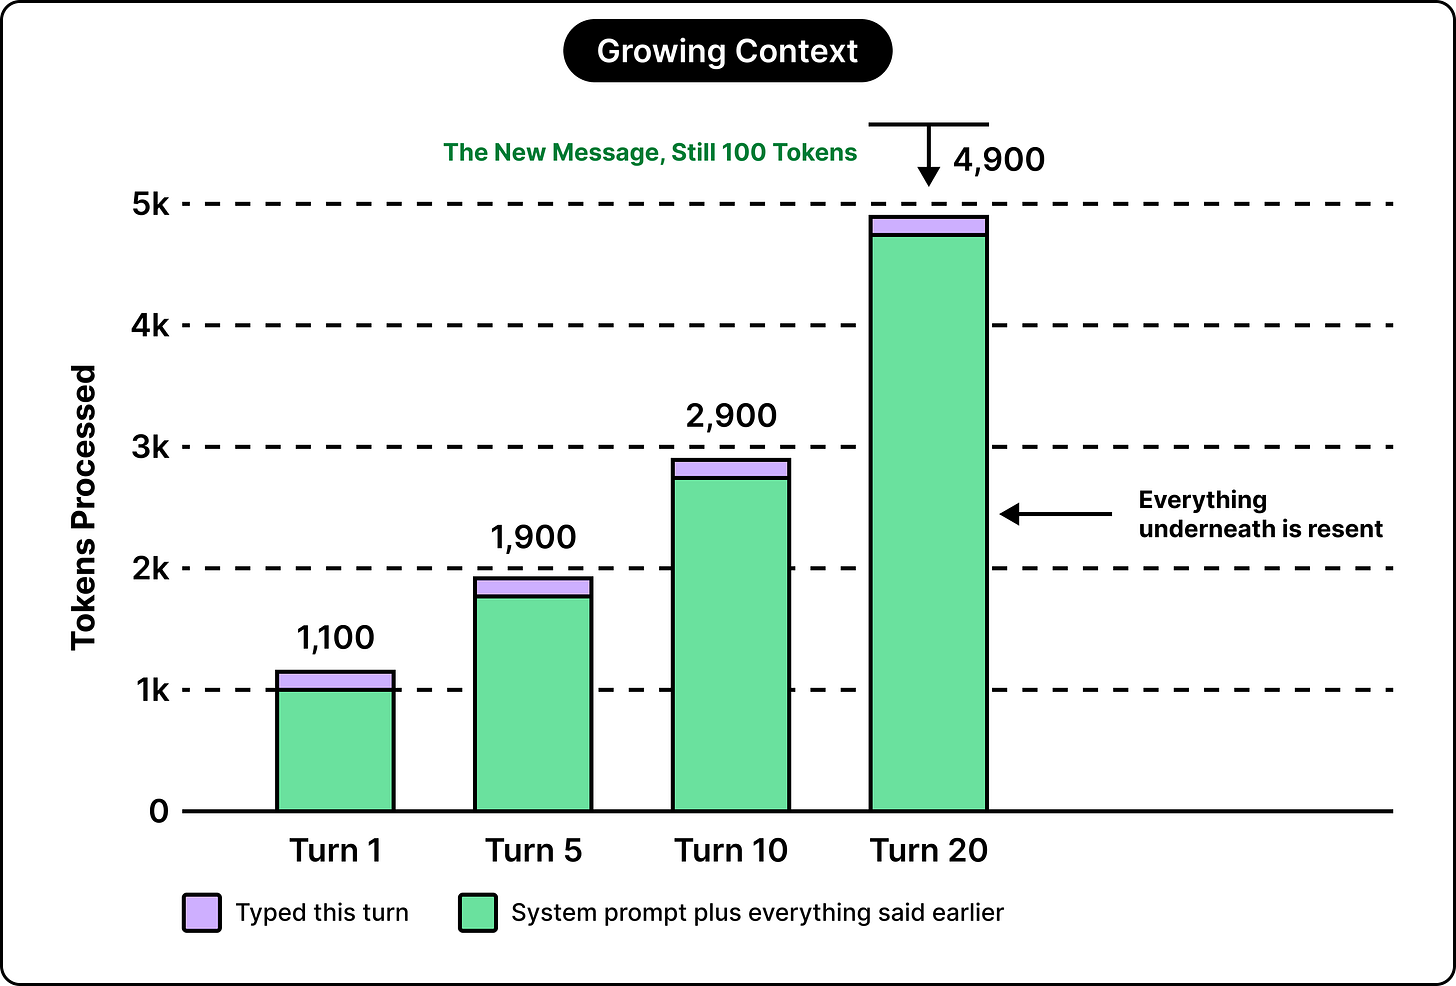
AI聊天机器人从按下回车到输出首个词之间,经历约十几个阶段:组装包含系统提示、工具定义、记忆和对话历史的文档,进行输入安全检查,将文本分词,排队与其他请求共享硬件,然后分预填充和解码两阶段生成。长对话因重新处理全部历史而变慢变贵,缓存和流式技术优化了性能,工具调用则形成循环。
Ox Alpha是一款匿名免费AI模型,因性能优异迅速走红,但用户发现其输出隔夜升级,引发“持续学习”争议。文章分析三种可能解释:A/B测试、定期更新检查点或超大上下文窗口,并指出官方声明“数据不用于训练”措辞模糊,加剧猜测。截至今日,模型未公开技术细节,真相成谜。
本文介绍99个ChatGPT提示快捷方式,通过“/快捷指令+上下文+交付物+约束”公式提升AI输出质量。快捷指令涵盖愿景创新、分析结构、优化运营、领导销售、内容SEO、设计品牌、转化风险、安全代码、研究学习等领域,并建议将常用指令整合为工作流程,定义在项目说明中保持一致性。
Falco 0.44.1仅支持stdout、syslog、file、http、program五种输出方式,gRPC输出已移除。排障时需区分输出背压与驱动丢事件,先用stdout验证引擎命中,再检查下游通道。
本文探讨了小型语言模型(SLM)在窄自动化任务中的优化,重点介绍了约束输出空间技术。通过直接评分候选标签而非生成自由文本,该方法消除了解析错误,降低了延迟(例如处理600条工单的时间从134秒降至94.5秒),并提供置信度分数以支持人工复核。该技术使SLM成为固定输出场景下高效的生产选择。
马里兰大学团队提出AI水印技术,通过动态红绿名单调整AI选词概率嵌入隐形标记。检测时无需访问模型,仅凭统计绿色词比例即可识别AI文本,手动改词难以消除。欧盟法案强制要求AI文本可检测,但开源模型可规避。水印旨在确保AI生成内容可问责,而非限制创新。
本文介绍语言模型解码策略与输出控制。解码算法将模型logits转为文本,影响生成质量。主要方法包括:贪心解码(确定性但可能单调)、温度采样(控制随机性)、Top-k与核采样(过滤低概率词)、重复惩罚(减少重复)、束搜索(多候选但成本高)、停止条件及结构化输出约束(如JSON)。选择合适策略需平衡质量与性能。
谷歌发布Gemini 3.6 Flash等三款模型,主打效率与成本优化,输出token减少17%,价格降至每百万7.5美元。3.5 Flash-Lite以高吞吐量抢占市场,3.5 Flash Cyber专注安全自动化。但基准测试仅对比自家产品,旗舰缺席及产品矩阵混乱引发开发者不满,未来寄望于Gemini 4。
调查发现DeepSeek V4在复杂代码任务中的输出与Claude Fable 5高度相似,引发AI圈讨论。测试显示纯代码请求时生成路径和思维链风格接近Fable,而涉及敏感话题时退回原生状态。事件凸显API服务透明度问题,需建立输出溯源机制,但官方尚未回应。
本教程介绍LangChain中PromptTemplate和结构化输出的用法。通过ChatPromptTemplate管理提示词模板,使用LCEL管道组合流程,并用PydanticOutputParser将模型输出解析为Python对象。文章包含代码示例、运行方法和常见问题,帮助读者掌握提示词模板化及结构化数据提取技巧。
wgpu v30 发布,增强了与 WebGPU 的兼容性,支持可选顶点缓冲槽和 HDR 输出等新特性。这次更新提升了图形能力,并影响了 Rust 生态的多个项目。Mainmatter 推出《C to Rust Migration Book》,帮助团队迁移 C 代码到 Rust。Qt Bridges for Rust 公测,简化了 Rust 与 Qt Quick 的交互。ZLUDA 更新,支持 PhysX 和 Blender,推进非 NVIDIA GPU 的兼容性。
NVIDIA 发布的 PiD 是一种新型潜空间解码范式,通过条件像素扩散生成取代传统 VAE 解码,解决了高分辨率图像生成的限制。PiD 利用轻量级噪声感知适配器和 DMD2 蒸馏技术,仅需 4 步去噪即可生成清晰的 4K 图像,显著提升了图像质量。
Tanzu Spring 提供对 OpenJDK、Spring 和 Apache Tomcat 的支持,用户只需简单订阅即可获得相关服务。
许多AI代理教程建议通过反思来修复输出错误,但这种方法在结构化输出中不可靠,可能导致错误被错误批准。有效的解决方案是使用确定性验证:生成输出后,利用真实的验证器检查错误并反馈具体问题,从而提高输出的正确性,避免反思带来的不确定性。
完成下面两步后,将自动完成登录并继续当前操作。