大语言模型推理工程旨在降低延迟、提升吞吐、减少内存。本文推荐5个实践项目:从零构建迷你vLLM、用Triton编写FlashAttention内核、搭建量化实验、实现投机解码、构建生产级推理服务,帮助深入理解KV缓存、连续批处理、量化等优化技术。
本文介绍vLLM推理优化:通过连续批处理让GPU持续忙碌,用PagedAttention分页管理KV缓存减少碎片,并利用前缀缓存跳过重复计算。还介绍GuideLLM测性能、lm_eval测质量,以权衡成本、准确率与性能。
本教程介绍如何使用vLLM扩展AI代理的LLM推理。文章解释了LLM推理的预填充和解码阶段,以及AI代理工作负载为何难以服务。vLLM通过连续批处理、PagedAttention和前缀缓存优化并发推理。教程演示了在本地安装vLLM、启动服务器,并通过OpenAI兼容API连接AI代理的步骤,最后讨论了这些优化技术的重要性及适用场景。
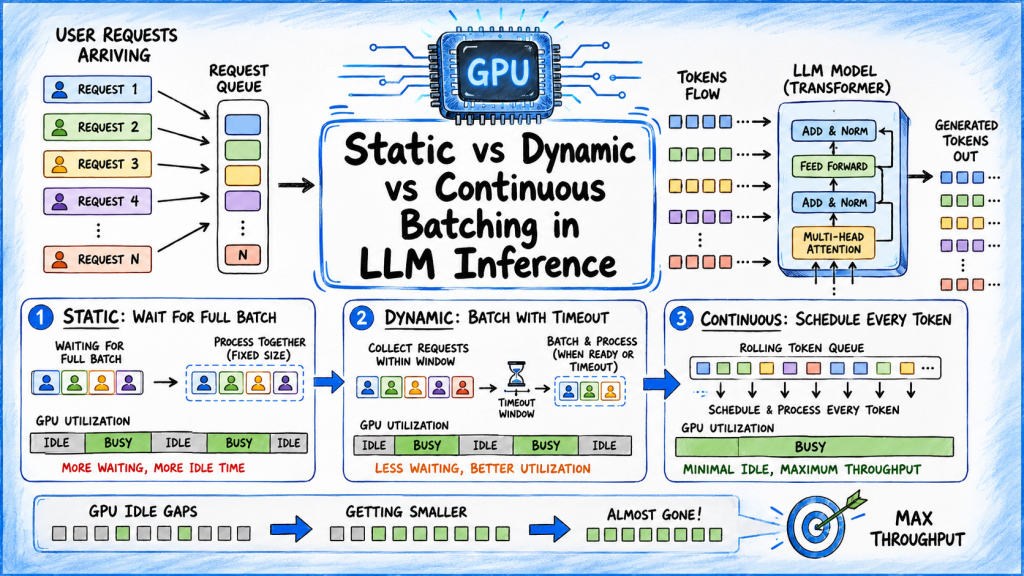
静态批处理等待批次满后才运行,延迟高;动态批处理通过超时窗口改善等待,但批次内仍受最慢请求影响;连续批处理以解码步骤为单位调度,序列完成即释放槽位,吞吐量高,适合生产级LLM服务。
本文讨论了大语言模型(LLM)推理引擎的现代化技术,包括连续批处理和分页注意力。这些技术显著提升了LLM的吞吐量和GPU利用率,同时优化了显存利用率。文章还介绍了分块预填充和前缀缓存等策略,以降低延迟和提高效率,强调在生产环境中应用这些技术的重要性。
完成下面两步后,将自动完成登录并继续当前操作。