

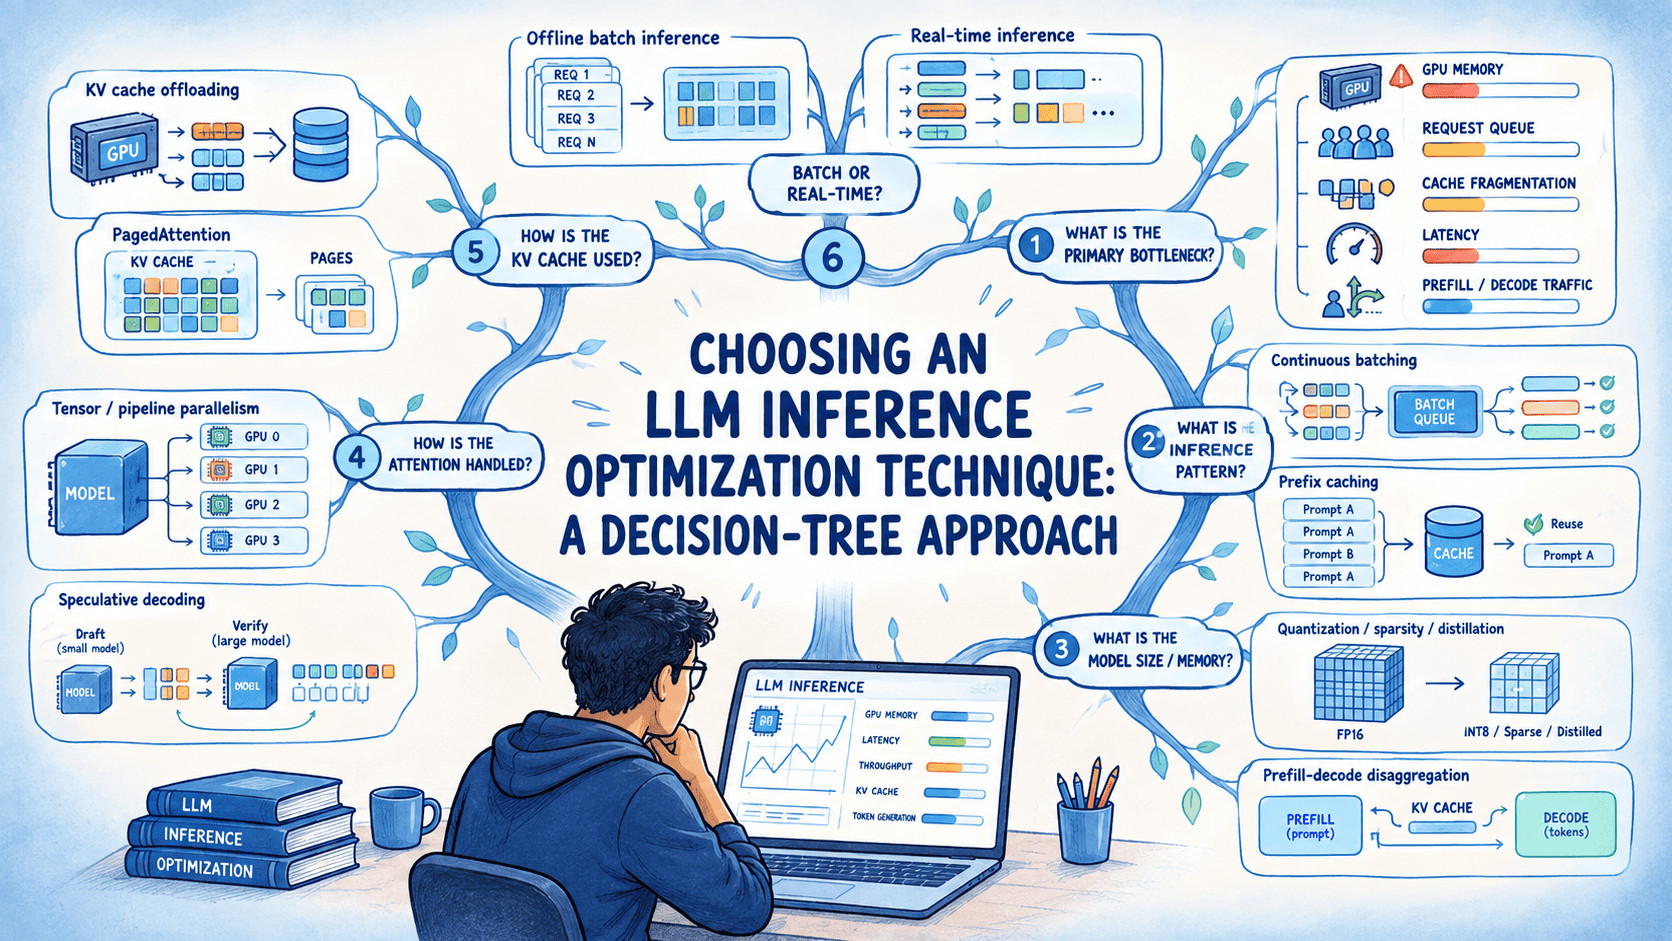

如何选择LLM推理优化技术:决策树方法
内容提要
文章提出用六问决策树为LLM推理选择优化技术:先判断模型是否适配硬件,不适配则采用量化、稀疏化或蒸馏;再依次考察提示前缀复用(前缀缓存)、并发变长请求(连续批处理)、KV缓存碎片(PagedAttention)、逐token延迟(推测解码)及预填充与解码争用(分离部署)。强调按瓶颈选型,并列出各技术的权衡与失效症状。
延伸解读
先判断模型是否适配硬件,再考虑服务栈优化
文章强调,决策树的第一问是模型能否舒适地放在目标硬件上。如果模型勉强装进GPU内存,KV缓存空间所剩无几,批大小会被卡死,调度器再好也难提升吞吐。此时应先做模型级压缩(量化、稀疏化或蒸馏),这些技术独立于服务栈,并决定剩余硬件容量。若模型已有余量,再进入前缀缓存、连续批处理等服务栈优化。
前缀缓存收益高,但依赖字符级完全匹配
对于聊天、智能体或RAG等重复使用相同系统提示或对话历史的场景,前缀缓存是最高杠杆的技术,能跳过已处理token的KV缓存重算,且对话越长收益越明显。但文章提醒,共享前缀必须逐字符完全一致才生效。若命中率接近零,常见原因是序列化不确定或动态内容被放在提示开头,应把稳定内容前置、变量内容后置。
连续批处理与PagedAttention多为默认能力,先检查是否启用
当并发请求输出长度差异大时,朴素批处理会让整批等待最慢请求,连续批处理能让完成的序列立即离开、新请求马上进入,多数服务引擎已默认开启。若KV缓存因预留最大长度而碎片化、限制批大小,PagedAttention可将缓存分页分配。文章建议,在增加新配置前,先确认这些引擎能力是否已启用,而不是假设默认值一定合适。
推测解码与分离部署有明确适用条件,失效症状可帮助回退
推测解码适合逐token延迟敏感的单用户场景,但需要草稿模型有较高接受率,否则额外验证开销会让它比普通解码更慢。预填充-解码分离部署适合大规模流量下两阶段争用同一GPU的情况,小负载或短请求为主时反而可能增加延迟。文章列出失效症状,如推测解码变慢、分离后延迟更差,提示应检查技术背后的假设是否成立,而非继续叠加复杂度。
Q&A
LLM推理优化技术有哪些主要类型,各自针对什么瓶颈?
文章列举了多种技术:量化/稀疏化/蒸馏针对模型过大或计算受限;前缀缓存针对重复提示前缀;连续批处理针对并发变长请求;PagedAttention针对KV缓存碎片;推测解码针对逐token解码延迟;预填充-解码分离针对预填充与解码争用GPU;张量/流水线并行针对模型无法放入单设备;KV缓存卸载针对GPU内存不足;离线批推理针对非交互式吞吐优先场景。
如何判断我的模型是否需要先做量化或蒸馏?
首先检查模型是否能舒适地放入目标硬件。如果模型勉强放入GPU内存,几乎没有空间留给KV缓存,会限制批大小;或者即使批大小为1推理也是计算受限,则应优先考虑模型级压缩:量化(降低权重和激活精度)、结构化稀疏(移除不重要权重减少计算)或蒸馏(训练小模型模仿大模型)。这些技术独立于服务栈,并决定剩余硬件容量。
前缀缓存什么情况下最有效?有什么限制?
当大量请求共享完全相同的提示前缀时(如聊天历史、系统提示、RAG指令),前缀缓存最高效,可跳过已处理token的KV缓存重计算,且对话越长收益越大。但它要求共享前缀逐字符完全匹配,任何字符级不匹配都会失效。应将稳定可复用内容放在提示前部,可变内容放在末尾。
连续批处理解决什么问题?什么时候不需要它?
连续批处理(in-flight batching)解决并发请求输出长度不一导致的GPU空闲问题:在朴素批处理下,整个批次要等待最慢的请求完成;连续批处理让完成的序列立即离开批次,新请求无需等待批次边界即可开始。大多数服务引擎默认启用。如果流量已经良好批处理且GPU空闲不是问题,则不需要额外关注。
PagedAttention如何帮助提升批大小?
一些引擎为每个请求预留固定连续内存块(按最大可能序列长度),即使请求很短也会浪费内存并阻塞其他请求。PagedAttention将KV缓存分成固定大小的页,按更小粒度分配内存,减少碎片和过度预留,从而允许更大的批大小。多数现代服务引擎已支持,应检查是否启用而非新增配置。
推测解码在什么目标下有用?代价是什么?
当目标是降低每个用户的逐token解码延迟(更快的流式输出)而非提高整体吞吐时,推测解码有用。它使用较小的草稿模型预测多个token,主模型一次验证,若预测正确可合并多个解码步骤,降低间token延迟。代价是额外模型和验证开销;若没有合适草稿模型或接受率太低,可能得不偿失。
预填充-解码分离部署适合什么规模?有什么开销?
预填充-解码分离适合大规模生产流量,当长预填充延迟解码请求,同时损害首token时间和间token延迟时。它将预填充和解码放到专用硬件:预填充节点处理提示,然后将KV缓存传给解码节点。代价是KV缓存传输和路由开销,因此仅在流量足够大时才合理;小负载或非交互请求用离线批推理更简单。
优化技术上线后效果不佳,有哪些常见症状和排查方向?
常见症状包括:前缀缓存命中率接近零(检查序列化是否确定、动态内容是否前置);批大小上不去(检查PagedAttention是否启用、页大小配置);推测解码反而更慢(草稿模型接受率太低,换更接近的草稿模型或放弃);分离部署使延迟更差(负载太小或请求短且缓存重,回退本地预填充);量化后吞吐未提升(可能只量化了权重而激活仍全精度,需分析时间花在哪里)。
