kubespray 是一个用于部署 Kubernetes 集群的工具,支持多种环境和高可用性配置。winapps 使 Linux 上能够运行 Windows 应用,实现无缝集成。tachiyomi-extensions-revived 恢复了 Tachiyomi 应用的扩展功能。stat_rethinking_2024 是一门在线统计学习课程。
是石科技发布TokenFleet分布式调度框架,聚焦请求路由、跨机房容量协同与混合负载治理。其中TokenPilot兼顾缓存复用与排队代价选择节点,FleetMind协同多机房可用容量,SLOMax按服务等级分池排队。框架以达标输出吞吐(Goodput)为优化目标,测算显示达标吞吐提高约29.4%,达标比例从约67%升至约86%。
Meta在俄亥俄州新奥尔巴尼建成千兆瓦级超级集群Prometheus首期,用于训练Muse系列基础模型,最终将扩展至约100万块GPU。集群采用GB200、GB300等多代英伟达平台,通过专用后端以太网实现楼宇间GPU互联。团队将中断率降低99%,预训练有效算力超85%,并采用闭环液冷、智能功耗管理提升效率与可靠性。
本文介绍在3台Ubuntu虚拟机(hadoop01、hadoop02、hadoop03)上搭建Hadoop 3.5.0全分布式集群,步骤包括安装虚拟机、配置主机名与固定IP、设置hosts映射、配置SSH无密码登录、下载安装Hadoop、配置PATH及workers、core-site.xml等5个文件、分发安装包、格式化NameNode并启动集群,最后运行MapReduce实例验证。
【版权声明】版权所有,请勿转载! 【相关文章推荐】《大数据软件安装和基础编程实践指南》,详细指导Virtual […]
乌克兰称袭击俄数据中心导致俄宣传机器人活跃度大跌,但Cloudflare等观测数据并不支持。Yandex爬虫流量一度暴跌99%,三天后恢复至85%;部分自动化工具转移至俄其他云服务,整体活动平稳。社交媒体水军流量无明显变化,因迁移云服务简单且资源需求低。
该页面仅为Percona博客的文章列表,无实质正文内容。
DrasiWake 将中间桥升级为三节点 Raft 集群,基于 DotNext 实现多数派提交与本地投影,可容忍单节点故障。SonnetDB 降级为物化投影,写操作经 Raft 复制,并保留受理与检查点同命令提交的不变量。无多数派时停摆拒写,通过幂等键保证副作用恰好一次。单节点模式也使用同一状态机,并强化证书、配置指纹与启动校验。
Kubernetes上线后,集群健康不代表应用正常。HPE专家指出,需明确平台团队与使用团队的职责分工,在云环境和集群层面制定访问控制、网络、备份、版本升级等标准。升级应分阶段进行,以应用关键路径正常、服务目标达标为完成标准。团队应提前在实验环境测试责任模型,跟踪运维指标,确保变更有人审批、故障有人响应。
本文介绍如何用AG-UI协议、Strands智能体集群和Amazon Nova Act构建自适应AI界面。静态界面难以应对AI输出的多变性(如医学影像中骨折数量不定)。AG-UI通过SSE标准化事件流实现动态UI;Strands集群让多智能体辩论直至达成共识,提升可解释性;Nova Act借助浏览器自动化集成无API的老旧系统。方案以放射科助手为例,涵盖架构、HIPAA合规、部署与清理。
谷歌开源编排器 Ax 将 Agent 视为集群一等负载,用声明式 manifest、沙箱、配额等 K8s 原语调度。Linear 博客独立印证 AI 生成代码使 CI 成为瓶颈,旧设施先排队。HN 质疑其复刻复杂度、YAML 地狱,且规模数字仅来自仓库自述,无第三方压测。
清华大学与无问芯穹开源具身智能云原生纳管平台RLark,统一管理机器人、相机等设备与云端算力,支持任务级跨集群通信。实测设备纳管从1小时缩短至5分钟,任务10秒内启动,并完成跨地域采集—训练—真机验证闭环,通信吞吐显著提升。
华为发布灵衢互联架构及超节点集群产品。该架构实现协议归一、内存语义,带宽达TB级,时延压缩至2微秒,支持CPU、NPU、内存、SSD等直接互联,降低大模型训练对单卡HBM需求。同时发布三级互联设备,支持百万卡集群扩展,以及由鲲鹏950、昇腾960超节点等组成的Agentic AI超节点集群。
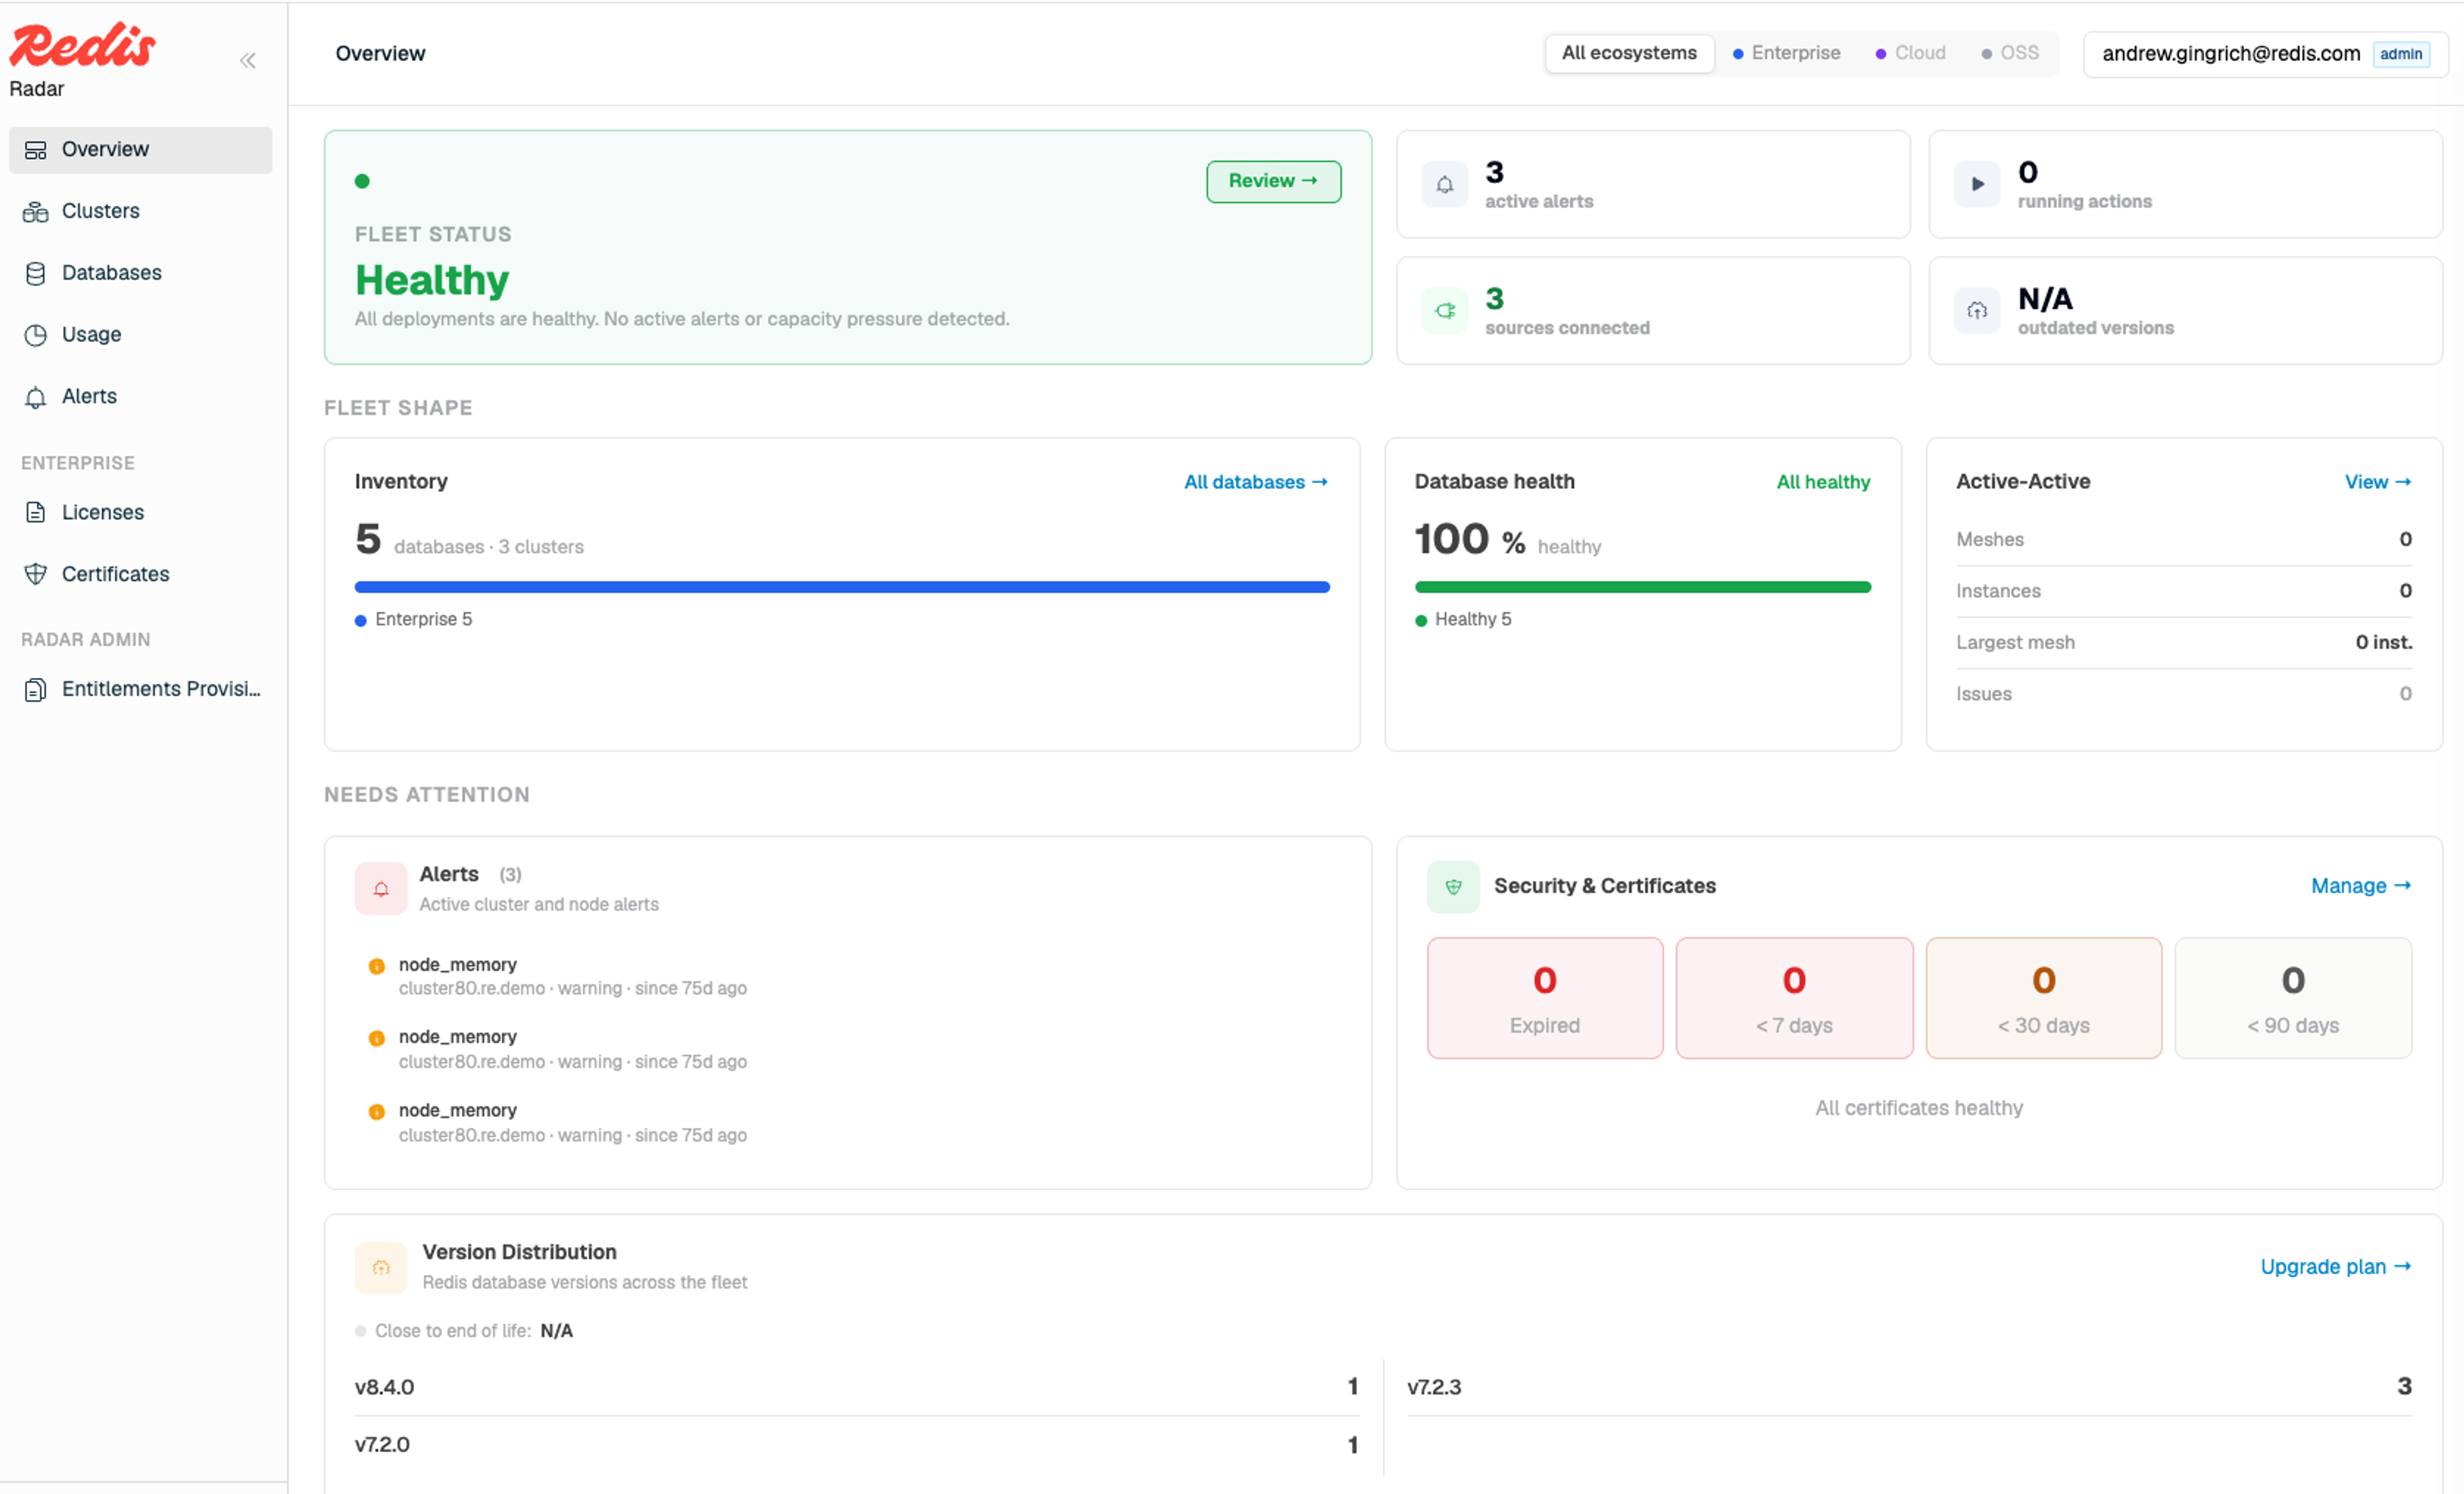
Redis 推出统一管理工具 Radar,可集中查看 Redis Software、Redis Cloud、开源版及 AWS ElastiCache、Google Memorystore 等部署的清单、健康与使用数据。支持托管和自托管,通过只读凭证或轻量代理连接,仅采集指标与元数据,不涉及应用数据,便于发现证书过期、内存压力等问题并规划容量与续期。
本文介绍用 Kiro AI Agent 配合 AWS 开源 MCP Server 辅助 Amazon EKS 集群升级。方案将官方最佳实践与企业运维规范编码为 Skill 和 Steering,通过自然语言驱动升级前检查、控制面逐版本升级、Add-on 升级、节点组蓝绿替换及升级后验证。采用默认只读、关键步骤人工确认、前后快照对比,降低操作复杂度与风险,实现安全可控可审计的升级。
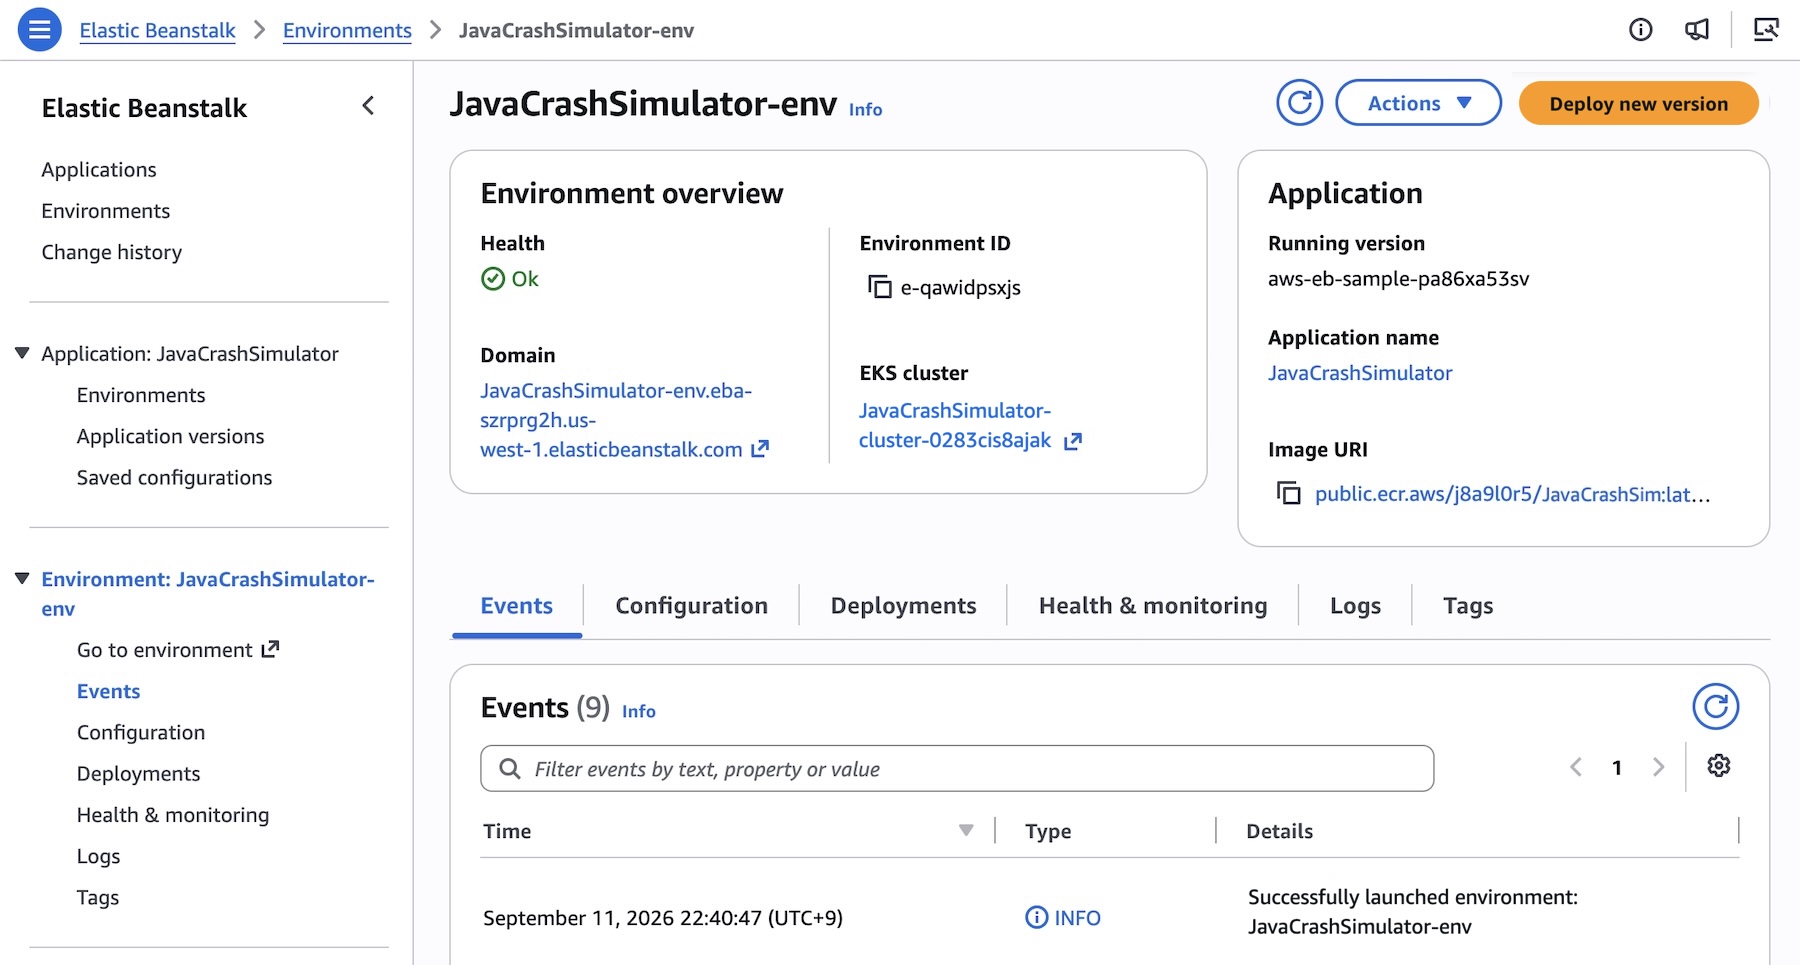
AWS Elastic Beanstalk 推出基于 Amazon EKS 的集群模式,可统一管理多个应用、共享基础设施,降低成本和运维复杂度。该模式支持多语言源码、Dockerfile 或容器镜像部署,内置合规性、自动扩缩、流量拆分部署与自动回滚、OpenTelemetry 可观测性及 AI 故障诊断。标准模式继续支持,两种模式可并行运行。集群模式不额外收费,现已在所有区域推出。
本文介绍达梦数据库连接配置:JDBC连接串有三种格式,支持主机端口、模式名及多种属性参数,涵盖连接、集群高可用、读写分离、安全加密、日志监控等类别;dm_svc.conf为客户端配置文件,分全局与服务配置区,服务区优先级更高,修改后需重启客户端;并详解LOGIN_MODE、AUTO_RECONNECT、CLUSTER等关键参数取值及配置示例。
华为发布OceanStor M900 AI记忆存储,面向超大规模数据中心AI推理,提供PB级全共享记忆空间。单集群容量64PB,KV Cache从GB级提升至TB级,时延降至60μs,带宽40TB/s,推理吞吐翻倍、首Token时延减半,并采用KV-Aware技术延长SSD寿命。
该文讨论MySQL数据目录中出现过多GCache页面文件的问题,分析其成因及对数据库的影响,并给出排查与清理建议。
9月9日,京东全球科技探索者大会在北京举行,主题为“JoyAI·跃迁物理世界”。京东宣布建设国产十万卡算力集群、推进1000万小时具身数据采集,发布JoyAI系列世界模型及AI购物助手“东东”,并启动“物理AI加速计划”,目标在具身智能领域实现六项全球第一。
完成下面两步后,将自动完成登录并继续当前操作。