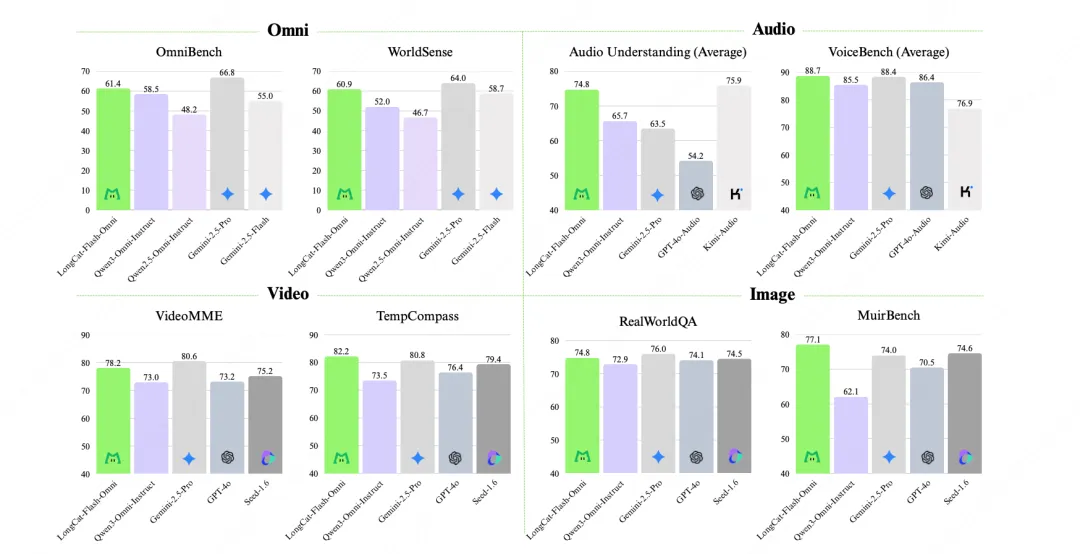
美团推出了LongCat-Flash-Omni模型,参数达到5600亿,支持低延迟音视频交互,表现优异。该模型在多模态任务中实现了开源最先进水平,具备强大的文本、图像、音频和视频理解能力,有效解决了推理延迟问题。
美团发布了LongCat-Flash-Omni模型,参数达到5600亿,支持低延迟音视频交互,表现优异,解决了推理延迟问题,适用于多种应用场景。
本文综述音频-视觉分割(AVS)研究进展,提出AVS任务及AVSBench基准,采用像素级音视频交互模块和正则化损失实现声音物体分割;后续工作引入双向生成、两阶段引导、音频解混、音频查询Transformer等框架,在AVS基准上持续刷新最优性能。
完成下面两步后,将自动完成登录并继续当前操作。