Softmax Attention想必大家已经不陌生,它是定义在有限向量集合下的一个加权混合算子。近日,论文《Continuum Attention》提出了一个很有意思的想法——将注意力连续化。...
本文探讨Transformer注意力机制的计算复杂度问题,指出标准注意力在长上下文下时间和空间开销呈平方增长。文章概述了高效注意力、FlashAttention和线性注意力等优化方案,其中线性注意力通过将Softmax替换为elu+1特征映射,将复杂度降至线性,并引入RNN式递归状态,为后续Kimi等长上下文模型奠定基础。
本文解析Kimi K3模型中的Attention Residuals(注意力残差)结构。该机制将残差连接视为深度方向上的RNN,通过可学习伪query对embedding及各层输出做softmax加权,替代固定求和。K3采用Block形式,将93层分为8块,块内普通求和,块间注意力聚合,共9个来源。相比普通残差,此设计提升多步推理能力,降低输出幅度增长,并支持高效两阶段推理。
上个月,我们发布了迄今为止最大的开源模型K3。作为K2的继任者,K3并不是一次从零开始的重新设计,而是沿着我们过去一系列工作自然演化而来,并融合了我们对效果、效率、稳定性的一些最新理解和改进。可...
在文章《LogSumExp和Softmax的泰勒展开》中,我们介绍了LogSumExp和Softmax的近似展开,并由此得到了一种线性化Softmax Attention的简单方案。但在那篇文章...
Summer in the Northern Hemisphere has gotten off to a very hot start. This has focused attention on the impacts of heat on health, infrastructure, and economic productivity—and how to best manage...
As AI changes how consumers discover products and impact is measured, advertising value will shift to the players that can shape what is seen, selected, and purchased.
本文探讨了大语言模型中KV Cache的产生与管理及其在推理过程中的重要性。KV Cache通过缓存历史K/V向量,优化生成过程并减少计算复杂度。Prefill阶段处理所有输入,而Decode阶段逐步生成输出,二者需分离以提升性能。vLLM采用页式内存管理,解决内存碎片问题,提升存储效率,确保高效的推理系统。
Part 5 of the “User Psychology Series.” Over the last four chapters of the “User Psychology Series,” we have explored how users think, feel, decide, hesitate, trust, and drop off. Each article...
本文回顾了2014年Bahdanau等人提出的注意力机制在神经机器翻译中的应用。该机制通过动态计算上下文向量,克服了固定长度向量的局限性,显著提升了长句翻译的质量。Bahdanau的研究为现代自然语言处理中的注意力机制奠定了基础,尽管后来被Transformer取代,但其核心思想仍然具有深远影响。
多头注意力机制的核心在于独立计算不同的注意力分布,而非简单平均。理解位置限制和计算复杂度是后续研究的重点。
本文探讨了自注意力机制的核心概念及其与传统模型的比较。自注意力允许序列内的每个token相互沟通,解决了RNN的长依赖问题。由于自注意力对位置无知,需通过位置编码注入位置信息。多头注意力使不同头学习不同关系。尽管自注意力在长序列处理上表现优异,但其计算复杂度为O(N²),引发了对优化的研究。
《Attention Is All You Need》论文于2017年发表,提出了Transformer架构,摆脱了RNN和CNN,专注于并行化训练。其核心贡献包括多头自注意力和位置编码,显著提升了机器翻译的训练速度。尽管初期反响平平,但后来成为大语言模型的基础,影响深远。作者团队背景各异,后续大多离开Google,成为AI领域的重要人物。
这篇文章介绍我们的一个最新作品Attention Residuals(AttnRes),顾名思义,这是用Attention的思路去改进Residuals。不少读者应该都听说过Pre Norm/P...
The quality of consumer attention that gaming captures is exceptional. Growth in the next era will depend on publishers, platforms, and partners rethinking how to maximize the value of that attention.
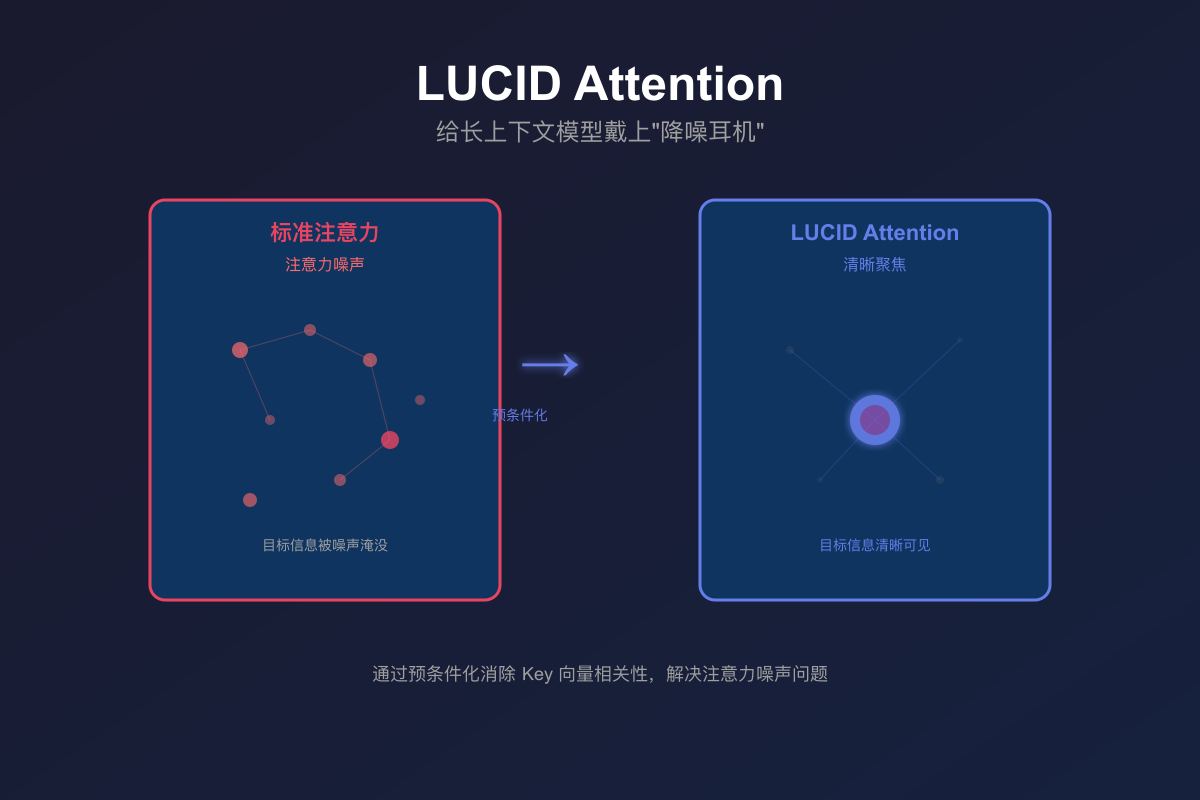
LUCID Attention 提出了一种新型注意力机制,通过去相关化 key 向量,解决了长上下文模型中的噪声和学习困境,提高了信息检索精度,计算开销几乎不变,适用于长上下文任务。
阿里巴巴Qwen团队的论文《Gated Attention》提出在Transformer注意力机制中引入门控,以解决训练不稳定、注意力聚焦和长上下文表现不佳的问题。该方法通过选择性过滤信息,提升了模型性能和训练稳定性,已在Qwen3-Next模型中应用,效果显著。
谷歌新论文《嵌套学习:深度学习架构的幻象》指出,大型语言模型存在“数字失忆症”,无法有效记忆新知识。研究强调优化器不仅是训练工具,更是记忆系统,提出“嵌套学习”新范式,强调模型深度与更新频率的平衡。新架构HOPE模仿人脑记忆机制,展现了解决持续学习问题的潜力,可能改变AI设计逻辑。
Nvidia推出的Alpamayo-R1(AR1)是一种具备结构化推理能力的视觉-动作模型,提升了复杂驾驶场景下的决策能力,为四级自动驾驶提供了可行路径。
UK consumers watch hours of content daily. But in an increasingly fragmented media market, companies that truly understand the value of attention are most likely to get ahead.
完成下面两步后,将自动完成登录并继续当前操作。