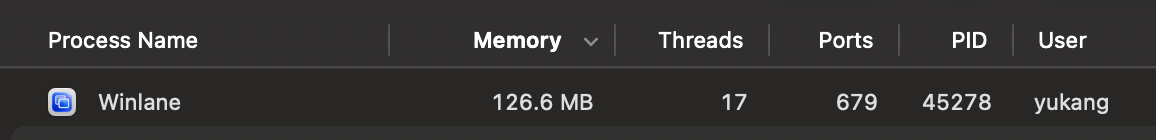


作者因 Contexts 多年未更新,用 Rust 和 AI 重写了类似工具 Winlane,集成窗口切换、Raycast 常用功能、Caffeine、Scroll Reverser、ShowyEdge、InputSourcePro 等,内存约 100MB。开发中重点优化界面响应速度,解决中文输入法候选窗闪现问题,并新增自动关闭闲置窗口的 auto-appclose 功能。
本研究针对临床对话数据集稀缺问题,提出了一种新的合成数据集类型学,以分类和评估不同的数据合成方式,从而推动医疗领域对话处理的研究进展。
本文提出了MLRBench,一个新的多语言长上下文推理基准,旨在克服现有基准的局限性。研究表明,高资源语言与低资源语言之间存在显著差距,且大型语言模型在多语言环境中有效利用的上下文长度不足30%。
本研究评估了重抽样技术在因果分析中的应用,解决了非实验方法验证因果模型的不足。通过理论和模拟实验,揭示了重抽样方法与算法调优参数的关系,并提供了选择重抽样方法的指导。
本研究提出了一种新方法EpMAN,旨在提升大型语言模型处理长上下文的效率。实验结果显示,EpMAN训练的模型在长上下文回忆和问答任务中表现更佳。
本研究提出了RetroLM框架,旨在提高大型语言模型在长上下文处理中的效率。该框架通过KV级别检索增强技术,增强了鲁棒性,并在多项基准测试中显著优于现有方法,尤其在深度推理和极长上下文理解任务中表现突出。
本研究提出了一种基于变换器的多模态知识图谱补全方法,解决了传统方法在处理真实世界图谱时的效率和规模问题。通过结合知识图谱嵌入模型与预训练的视觉语言模型生成的跨模态上下文,显著缩小了模型规模,并在多个大规模数据集上保持了竞争性能。
本研究提出了一种评估生成式人工智能工具在文化背景下创造实践的方法,以增进对生成艺术作品文化多样性的理解,帮助艺术家更有效地运用技术。
本研究探讨了大型语言模型在多跳问答中对外部知识的偏好,提出了证据链的概念,强调知识点之间需相互支持。研究表明,证据链能提高生成的准确性和答案的可信度。
本研究提出了LLM-RG4框架,解决了放射学报告生成模型在处理多样输入时的灵活性问题。新数据集MIMIC-RG4提高了模型生成报告的准确性,实验结果显示其在临床效率和自然语言生成方面表现优异。
本研究提出QUENCH,一种基于文本的英语测验基准,旨在评估大型语言模型的世界知识和推理能力,结合地理背景与常识推理,以加深对LLMs缺陷的理解。
本研究提出了LLMSteer框架,旨在改善大型语言模型(LLM)在长上下文理解和计算成本方面的不足。该框架通过无查询依赖的注意力引导,显著提高了LLM性能,缩小了65.9%的性能差距,并将运行延迟减少了4.8倍。
本研究探讨大型语言模型(LLM)在处理分散经验信息时的决策能力,提出OEDD语料库评估LLM在干扰情况下的表现,结果显示其在复杂决策背景下的能力有限,表现低于随机选择。
在C语言中,程序的执行上下文包括寄存器、变量和指令流,是实现多任务处理的关键。本文通过contexts.c文件演示上下文切换,使用ucontext.h库创建ContextPing、ContextPong和ContextMain三个上下文。Ping和Pong函数在各自上下文中交替执行,使用swapcontext进行切换。main函数中,ContextMain使用主线程的堆栈,无需额外分配内存。代码展示了上下文切换如何保持函数中的变量状态。
本文研究了大型语言模型在上下文学习中的脆弱性,尤其是在认知负荷过重时容易受到攻击。研究提出了一种新的提示注入攻击方法,成功率高达99.99%,显示现有安全机制不足,需开发更稳健的保护措施。
本研究提出了RetrievalAttention方法,用于解决Transformer模型在处理长上下文时的推理延迟和GPU内存消耗问题。该方法通过在CPU内存中构建近似最近邻搜索索引,利用注意力的动态稀疏特性,降低了推理成本和内存需求,同时保持了模型准确性。检索注意力仅需16GB的GPU内存,显著提高了推理效率。
I have a question regarding bounded contexts in DDD terms. Let's assume that I have bounded context called Tenant (With Tenant Admin who can create Tenant Member), Library (With Reader, who can...
完成下面两步后,将自动完成登录并继续当前操作。