文章介绍CUDA内存栅栏函数:编译器优化可能改变内存访问顺序,多线程或GPU并行编程中需用内存栅栏强制顺序一致性。CUDA提供三个函数:__threadfence_block保证线程块内可见,__threadfence保证设备内可见,__threadfence_system保证系统内所有线程可见。三者作用范围依次扩大,开销也依次增加,应根据所需可见范围选择以兼顾正确性与性能。
本文介绍OpenJDK Babylon项目的Java代码反射API及其异构加速器工具包HAT。HAT通过反射、转换、加速三阶段,将Java计算代码转为GPU友好表示并卸载至OpenCL或CUDA执行;演讲以张量核心编程和矩阵乘法为例演示,并用NVIDIA Nsight工具分析调优CUDA后端性能。
文章探讨在CUDA中优化sigmoid函数以提升GPU指令吞吐性能。作者用Triton实现三种版本:原生tl.sigmoid、基于FTZ的近似实现,以及用tanh.approx.f32的近似实现。在RTX 5080上测试,tanh近似因只需一条MUFU指令,速度约为原生实现的两倍,FTZ版快约5%,但tanh数值误差略大。
文章将 PostgreSQL 与 CUDA 比作“双胞胎”:二者起源不同,但都遵循“不让独立工作无谓等待”的理念。PostgreSQL 通过 MVCC 实现读写并发互不阻塞,CUDA 则让 GPU 并行处理海量独立计算。面对上亿行的简单运算,CPU 负责查询、事务与顺序逻辑,GPU 负责重复并行计算。PG-Strom 扩展将二者结合,用 GPU 加速合适负载,但并非万能提速。核心是让正确的工作交给合适的硬件,同时保持数据可信。
DeepSeek把给英伟达写的全套家伙什原封不动扔到了华为昇腾950上! 这套工具链包含六件核心装备,从编程语言到通信库全部开源,每一件都能
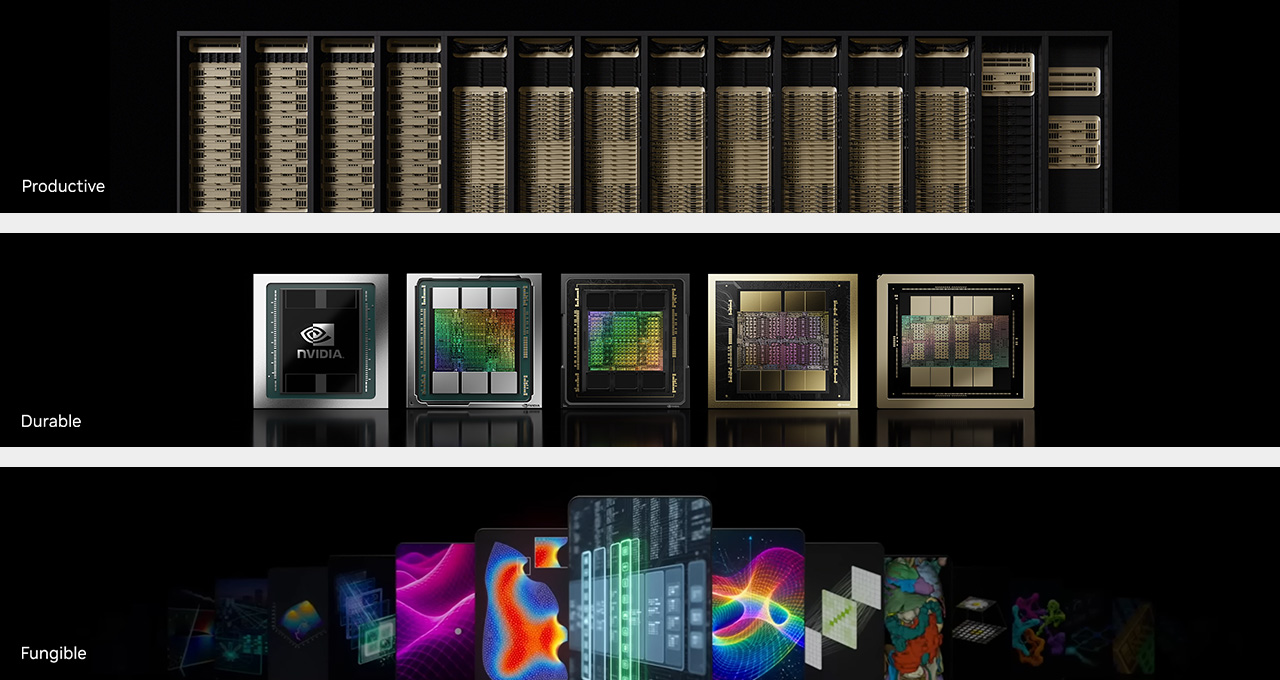
英伟达AI工厂每兆瓦建造成本约6000万美元,投资回报取决于产能、寿命和需求。其平台具备高产、耐用、通用三大特性:每兆瓦吞吐量最高、每token成本最低;GPU多年后仍可创收;可运行各类AI及非AI负载。全栈协同设计与CUDA软件持续优化,使旧硬件不闲置,从而最大化回报。
CUDA_DEVICE_MAX_CONNECTIONS 环境变量控制 GPU 硬件并发连接数,默认仅为 8。即使软件层创建大量 CUDA 流,若该值不足,GPU 仍会因硬件队列限制而利用率低下。实验用 32 个流测试,吞吐量随该值从 1 增至 32 几乎翻倍,达 84601 QPS。每个流映射一个硬件队列,建议将其设为与流数一致以最大化 GPU 利用率。AMD GPU 对应变量为 GPU_MAX_HW_QUEUES,默认 4。
德国初创公司Q.ANT开发了用光而非电进行AI计算的光计算处理器,并在GitHub发布免费开源工具包,允许开发者在普通电脑上模拟编程,支持Python和C。该工具目前仅支持已训练模型的推理,如手写数字和图像物体识别。Q.ANT称光计算可减少参数和能耗,但芯片尚未开放,开发者需等待云端或本地服务器接入。
华为提前9个月发布昇腾960,并全面开源CANN,旨在跨越英伟达CUDA生态鸿沟。华为通过遵守开源规则、捐赠资金和派遣工程师维护vLLM、PyTorch等项目,使昇腾获得主流系统接纳。目前昇腾在推理场景已可用,但预训练仍困难,仅有美团LongCat等少数案例。结论:在封闭市场同时尊重开源规则,才能突破生态壁垒。
CUDA线程块执行顺序会影响L2缓存命中与GEMM性能。文章介绍了线性、分组2D面板、Morton和异或等swizzle算法,并用Triton进行基准测试。结果显示,预测的缓存命中率与实际吞吐量几乎不相关,列主序明显慢于行主序,原因可能在于DRAM访问模式等底层因素。结论是应针对具体配置实测,而非依赖缓存命中率预测。
2026年9月,英伟达发布cuda-oxide和cutile-rs,首次支持用Rust直接编写GPU内核并编译为PTX,无需C/C++。cuda-oxide采用SIMT路线,需nightly工具链,用DisjointSlice保证内存安全;cutile-rs采用Tile路线,stable Rust即可,靠所有权与分区机制。两者均能在编译期捕获内存别名与数据竞争。但社区指出,CubeCL/Burn等已有先例,且地址空间抽象、供应商锁定与性能可移植性仍是“纯Rust AI栈”的真正障碍。
AI模型部署耗时主要来自加载权重、KV Cache初始化和CUDA内核编译。作者在T5000芯片上预编译CUDA内核,将cache、triton、nv等目录打包为缓存包,用户下载后无需重复编译,部署时间从40分钟缩短至16分钟。
DeepSeek开源C++20库DeepJIT,为英伟达CUDA与华为昇腾NPU提供统一的内核JIT编译、缓存与启动接口,统一的是编译外围流程而非编译器本身。核心亮点是含自定义签名的多级缓存与分布式共享缓存,可减少集群重复编译。相比Triton、CuPy各有取舍,目前缓存预热和Python API尚未完成。
NVIDIA推出CUDA Rust,支持SIMT和Tile两种编写GPU内核的路径,前者需nightly版本,后者稳定版即可。另有纯Rust图表语言Lini、Rust重写的Battle.net服务Tavern,及讨论Rust空类型非bottom type的文章。
CUDA时间切片是GPU默认共享机制,但低利用率进程会拖慢其他进程。NVIDIA MPS允许多进程并发执行内核,提升GPU利用率。文章通过Triton内核测试展示,启用MPS后8个单SM工作负载的吞吐量从3.02提升至17.09请求/秒,约6倍改进,并提供了启用/禁用MPS及Docker配置方法。
本文介绍ABACUS第一性原理计算软件GPU版本的编译方法。文章对比平面波与数值原子轨道基组,指出GPU可加速电子步等耗时计算。详细说明使用conda配置CUDA 12.2环境、安装依赖库、编译ELPA及ABACUS的步骤,并通过BaTiO3示例验证GPU版本比CPU快1.60倍,且数值精度几乎一致。
英伟达以129.3亿美元收购开源AI平台Hugging Face,交易金额暗藏表情符和品牌色梗。此举旨在掌控开源生态,被视为下一代CUDA,以巩固其统治地位。创始人牺牲个人收益,换取英伟达长期支持,以应对巨头竞争。该交易被视为时代最重要的并购,可能锁定未来AI标准。
TensorSharp 是纯 .NET LLM 推理引擎,三天内接入 GLM-5.3-Flash 和 Qwen3.8-Flash-Next 新架构。它支持进程内推理,性能上 decode 速度翻倍,prefill 持平,并强调正确性验证和部署便捷性。对 .NET 团队,这标志着前沿模型架构跟进加速,值得纳入 PoC 评估。
英伟达拟以129亿美元收购Hugging Face,类似微软收购GitHub,旨在掌控开源模型生态。开源模型因成本低、易运行,正抢占市场,威胁OpenAI和Anthropic。此举确保开发者继续使用英伟达CUDA软件栈,巩固其硬件主导地位。开发者应构建适应模型变化的系统,而非依赖单一默认。
CUDA Graph在多流执行中效果有限,仅能消除CPU开销导致的GPU气泡,无法解决其他流中阻塞内核引起的气泡。若GPU利用率已高,启用CUDA Graph收益甚微,不应过度投入。仅当气泡主要由CPU开销造成时,启用才可能有益,但需验证分析痕迹的准确性。
完成下面两步后,将自动完成登录并继续当前操作。