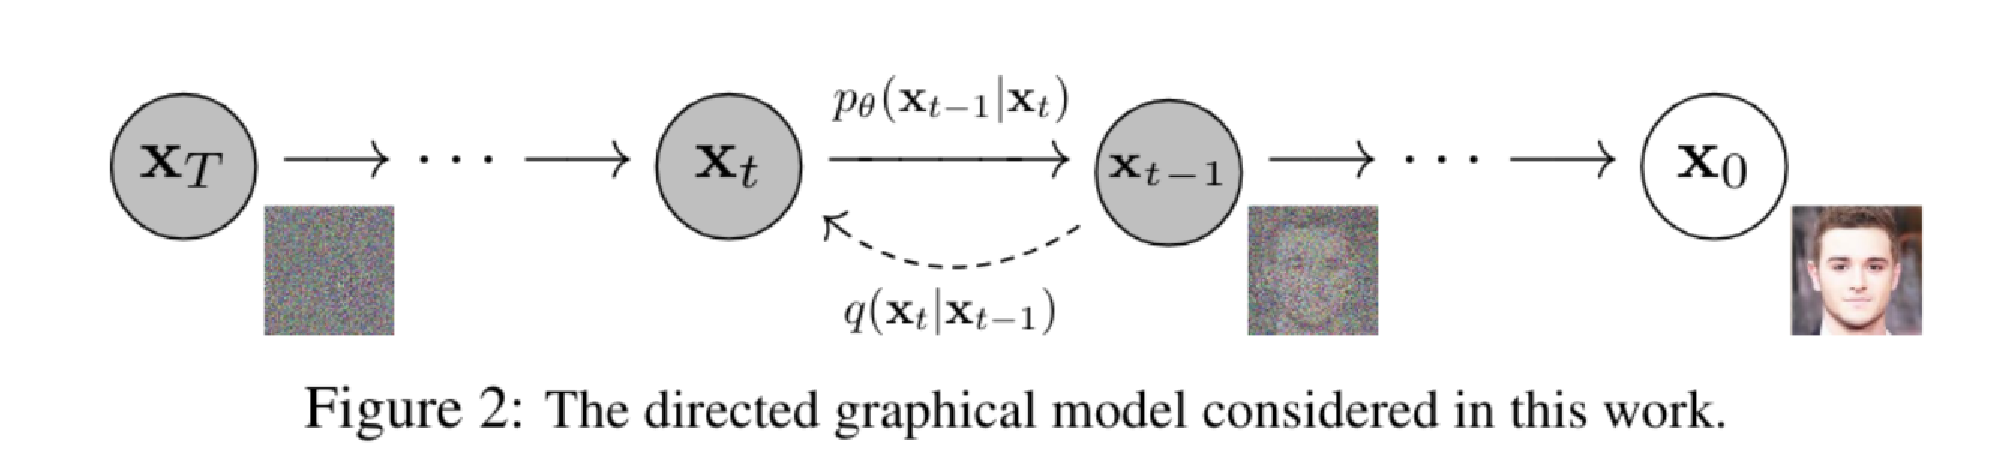
DDPM(去噪扩散概率模型)通过逐步添加噪声生成图像,利用神经网络预测并去除噪声。模型依赖高斯分布,损失函数使用均方误差(MSE)衡量真实噪声与预测噪声的差异。训练过程中,模型优化以提升生成图像质量,最终通过积分将预测的高斯分布转化为清晰图像。
我们研究了无分类器引导(CFG)的理论基础,揭示了其与DDPM和DDIM的不同之处,并指出CFG生成的分布存在误解。我们将CFG描述为一种预测-修正方法(PCG),在去噪和锐化之间交替。通过在SDE极限下的分析,我们证明CFG等同于结合DDIM预测器和Langevin动态修正器,从而为CFG的理解提供了理论支持。
本研究提出了一种热扩散模型(HDM),有效解决了图像生成方法在细节保留方面的不足。实验结果表明,HDM在生成质量上优于DDPM和一致性扩散模型(CDM)。
本文探讨了无分类器引导(CFG)的有效性,指出其与DDPM和DDIM的不同交互。研究表明,CFG是一种预测-校正方法(PCG),在去噪和锐化之间交替。DDPM-CFG在SDE极限下等同于应用于条件分布的DDIM预测器和伽马分布的Langevin动态校正器。
Fast-DDPM是一种高效的图像生成方法,通过仅使用10个时间步显著提高训练和采样速度,尤其在医学图像生成中表现优于现有技术。此外,研究还提出了多种基于扩散模型的图像修复算法,如RePaint和DDDM,展示了在处理未知蒙版和减少训练次数方面的优越性能。
本研究提出了一种名为 Vision Mamba UNet (VM-UNet) 的医学图像分割模型,采用状态空间模型和不对称编码器-解码器结构,有效捕获上下文信息。实验结果表明,VM-UNet 在医学图像分割任务中表现优异,为未来高效分割系统奠定基础。
本文综述脑部MRI修复技术,目标是从病态扫描合成健康脑扫描,属于BraTS 2023挑战任务。研究将2D修复方法适配3D MRI数据,并评估多种技术,包括基于DDPM的细胞图像生成、弱监督病变生成、RePaint、GradPaint及贝叶斯COPAINT等,用于补全缺失信息并提升可解释性。
该文综述深度展开优化研究:用反向传播构建高效等效模型,统一展开与分析微分;提出PES进化策略消除截断偏差;证明展开反向传播与迭代求解渐近等价;并探讨DDPM推断冗余、泛化误差边界及在线训练非可微求解器等方法。
该文综述扩散模型图像编辑中的反演技术,涵盖DDPM替代噪声空间、LEDITS轻量编辑、InfEdit无显式反演、ZIP零样本框架、Prompt重描述、Pivotal反演、直接反演、Prompt Tuning Inversion及DPM精确反演等方法,以实现高保真文本引导编辑。
本文综述扩散概率模型在医学图像合成与分割中的应用:条件扩散模型可生成肠道息肉、结肠镜、视网膜OCT及心脏超声等合成图像,缓解数据稀缺与隐私问题;合成数据能提升分割模型精度,并支持半监督分割与领域泛化。
扩散模型研究取得多项进展:DDM将扩散过程分解为两个简单过程,显式近似图像分布,新训练目标可分别预测噪声和图像成分,支持少步生成;UDPM降低潜变量维度,仅7步生成高清图像;改进DDPM可学习反向方差,减少采样传递次数;D3PM针对离散数据设计过渡矩阵,文本生成效果好;连续动力系统去噪网络参数减至四分之一,推理提速70%;扩散模型改进对抗训练达最先进鲁棒准确率;PartDiff扩散至中间潜在状态,减少去噪步骤;ResEnsemble-DDPM提升图像分割性能;DiffuSSM降低高分辨率生成计算复杂度;DDPM在CIFAR10获FID 3.17。
本文提出了离散去噪扩散概率模型(D3PM),用于离散数据的生成模型。研究发现过渡矩阵的选择对生成结果至关重要,新损失函数在字符级别文本生成上表现良好。
研究人员提出了一种新的去噪扩散过程Resfusion,可以整合现有的端到端模型和去噪扩散模型,提高图像分割性能。实验结果显示Resfusion在分割任务中表现出色,具有竞争力。
该文介绍了一种利用深度学习的新方案来解决噪声无线信道上的图像传输问题。该方案利用目标图像的范围 - 零空间分解,通过编码传输图像的范围空间,并采用 DDPM 逐步改进其零空间内容。实验结果表明,该方案在重建图像的失真和感知质量方面有显着改进。作者将公开共享源代码以促进进一步的研究和可重复性。
本文提出了一种基于DDPM和物理感知的图像去雾框架DehazeDDPM,适用于复杂的浑浊场景。该框架通过物理建模和DDPM的生成能力相结合,补偿浓雾引起的信息损失。实验证明,该方法在合成和真实世界的浑浊数据集上取得了最先进的性能。
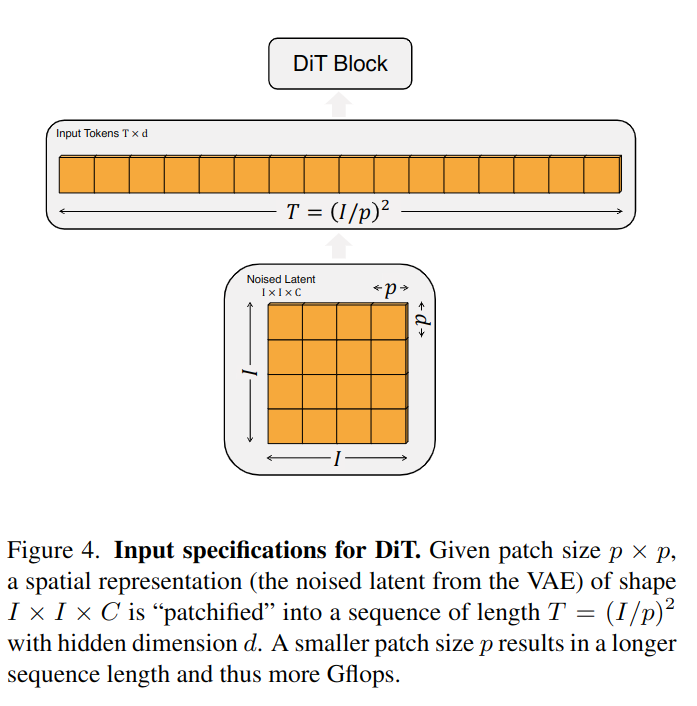
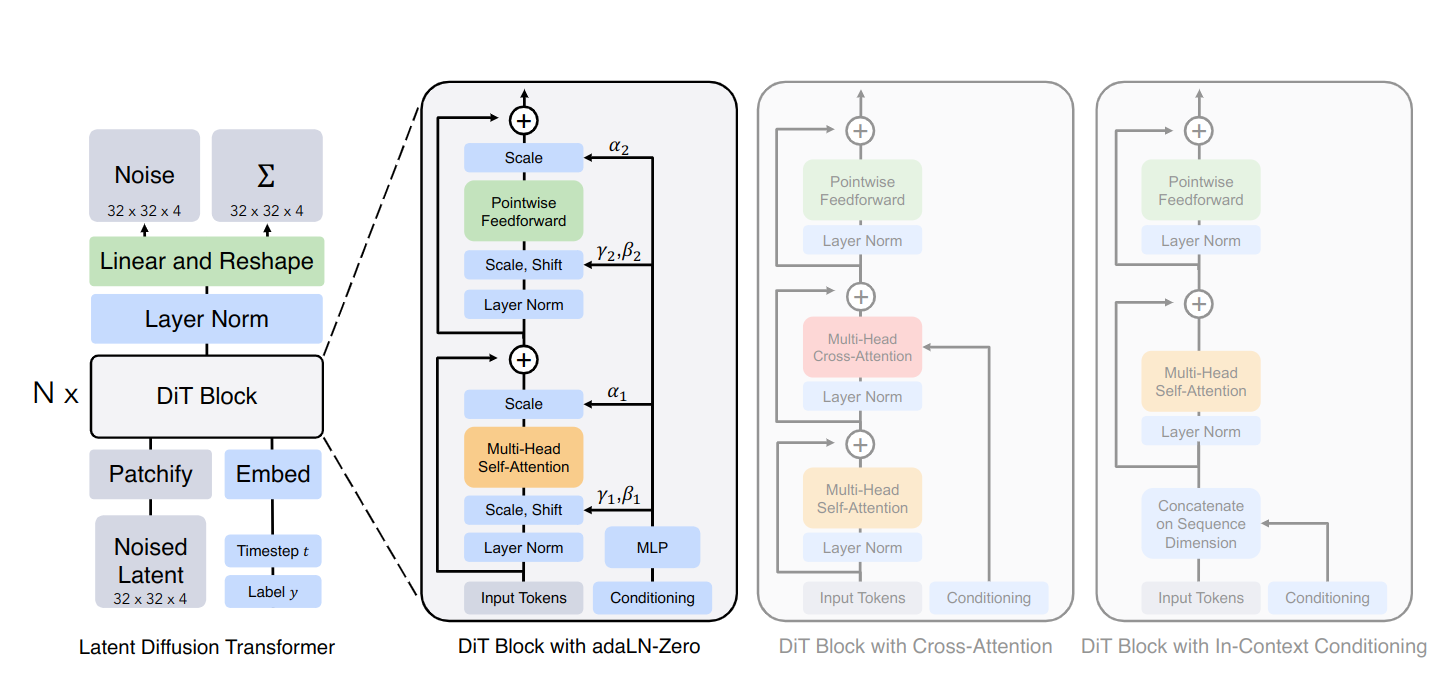
本论文提出了一种名为Diffusion Transformer-DiT的模型,用于替代DDPM中的UNet。作者通过训练四种不同大小的模型,并探索了补丁大小、变压器块架构和模型大小等设计空间。模型首先对补丁序列进行操作,然后使用diffusion transformers进行设计。作者使用标准线性解码器将输出解码为噪声预测和对角协方差预测。最后,将解码的token重新排列到原始空间布局中,得到预测的噪声和协方差。
本文探讨了用ViT替代DDPM中的UNet,提出了Diffusion Transformer-DiT模型。作者训练了四种不同大小的DiT模型,研究了补丁大小、变压器架构和模型规模。模型通过处理补丁序列进行操作,并在设计中加入去噪步数和类别标签,最终输出噪声预测和协方差。
本文介绍了CV领域的典型视觉模型,包括R-CNN、YOLO、DETR等,并重点介绍了从VE、VAE到Diffusion Model的模型原理。VAE通过添加高斯噪声和让所有趋近于标准正态分布来保证模型有噪声和随机性。而DM则是一种新的生成模型,可以用于图像生成和插值。
扩散模型是人工智能生成内容的前沿研究方向,包括GAN、VAE、NF和DM四个流派。它通过变分推断训练参数化的马尔可夫链,在许多任务上展现了优于其他生成模型的效果。扩散模型的核心思想是通过正向过程将噪声逐渐加入数据中,然后通过反向过程预测每一步加入的噪声,最终还原得到无噪声的图像。DDPM是扩散模型的重要基石算法,通过神经网络学习从纯噪声数据逐渐对数据进行去噪的过程。扩散模型的生成效果已达到甚至超过人类画师的水平,但仍存在采样速度慢、生成效果差和内容不可控等问题。
完成下面两步后,将自动完成登录并继续当前操作。