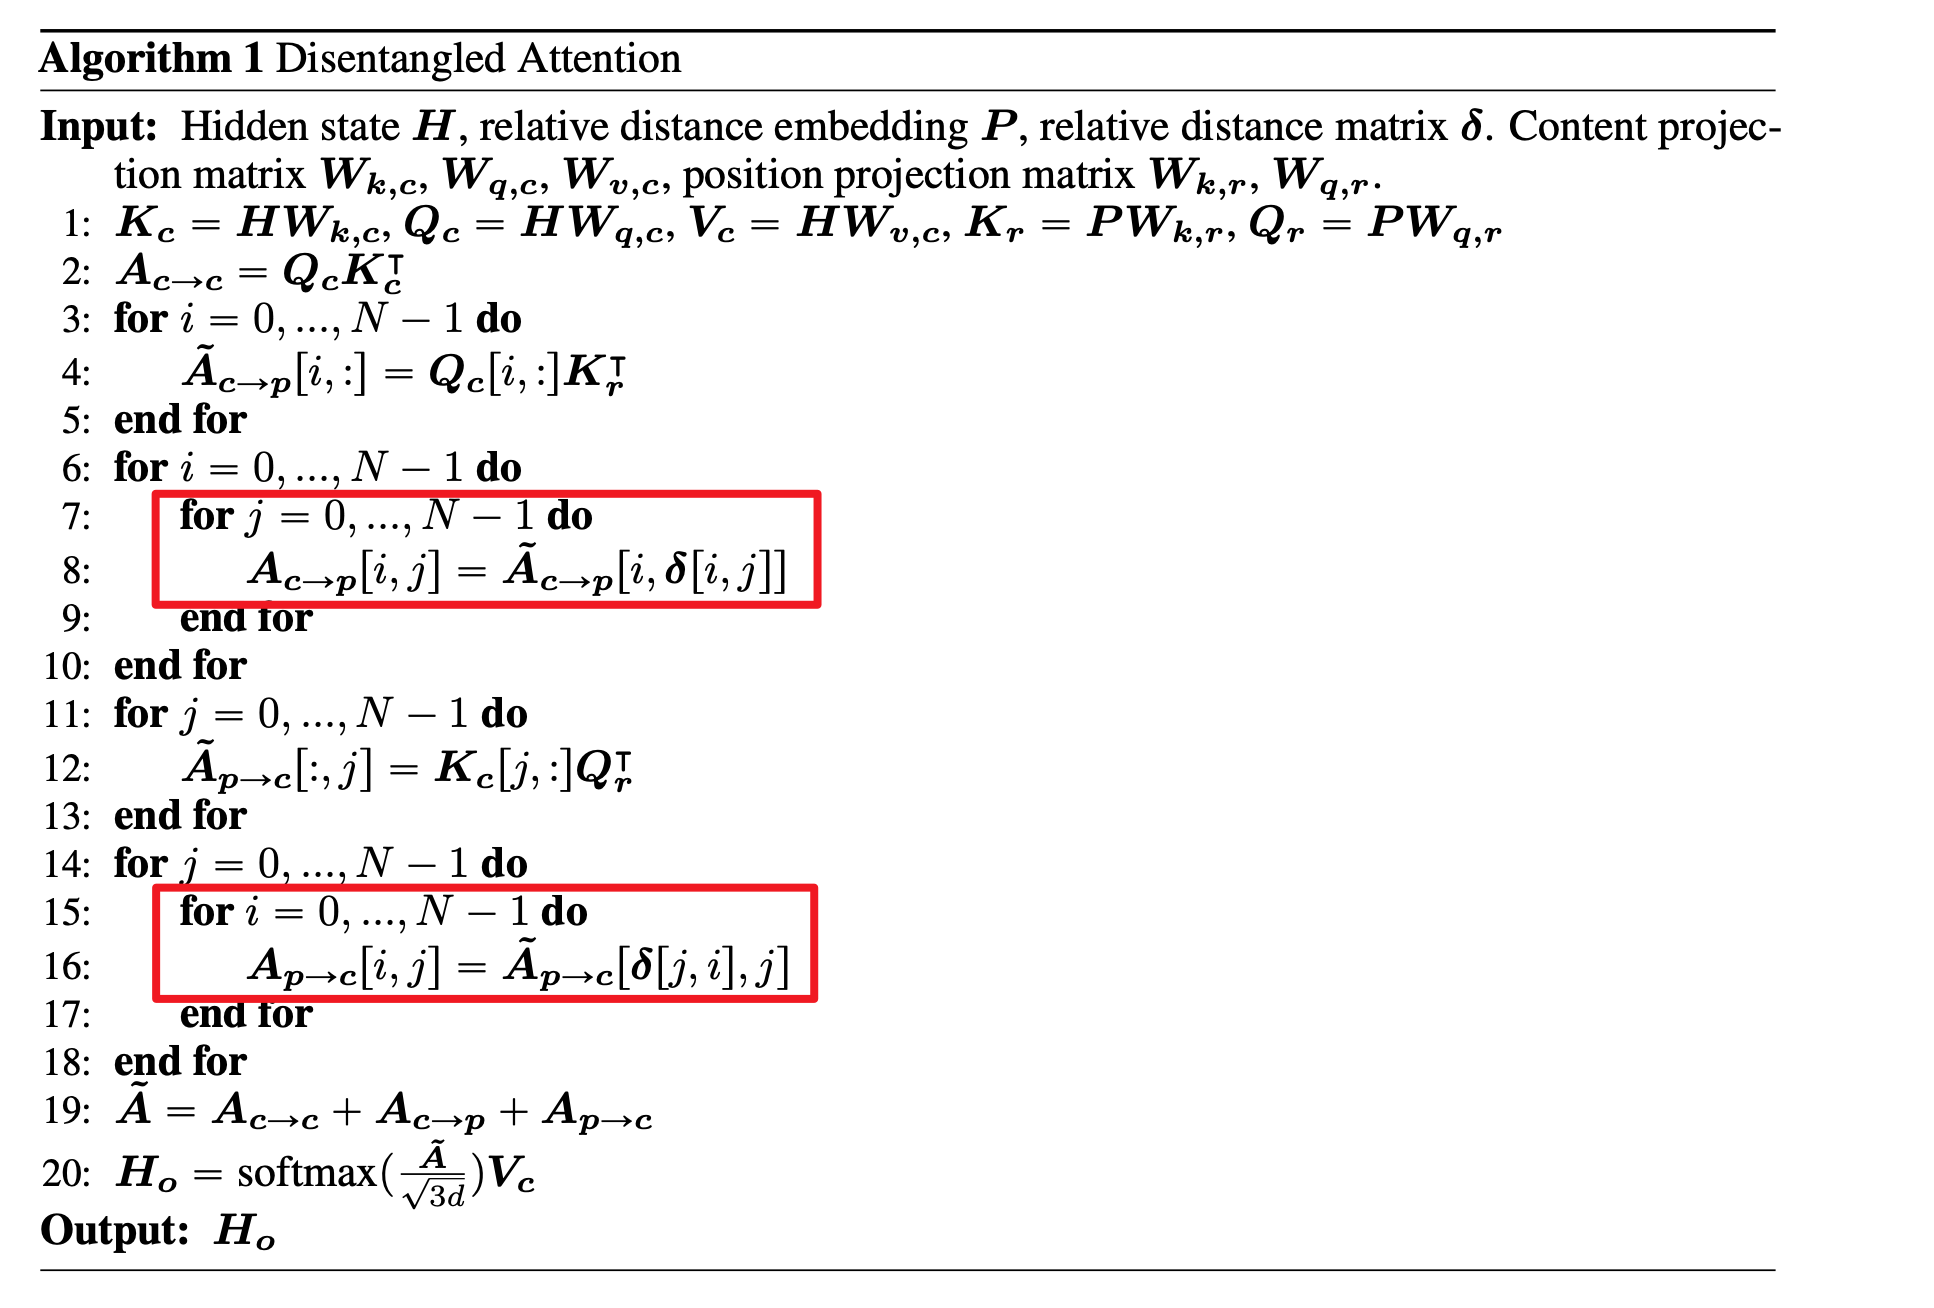
作者用Paddle复现DeBERTa,因算力有限仅跑通demo。核心难点是disentangled attention:语义与位置编码分别计算再求和,Paddle的gather仅支持一维索引,实现比PyTorch复杂。MLM预测需同时引入绝对位置编码;在layer norm后的embedding上加扰动可提升训练稳定性。
完成下面两步后,将自动完成登录并继续当前操作。