


DeBERTa
内容提要
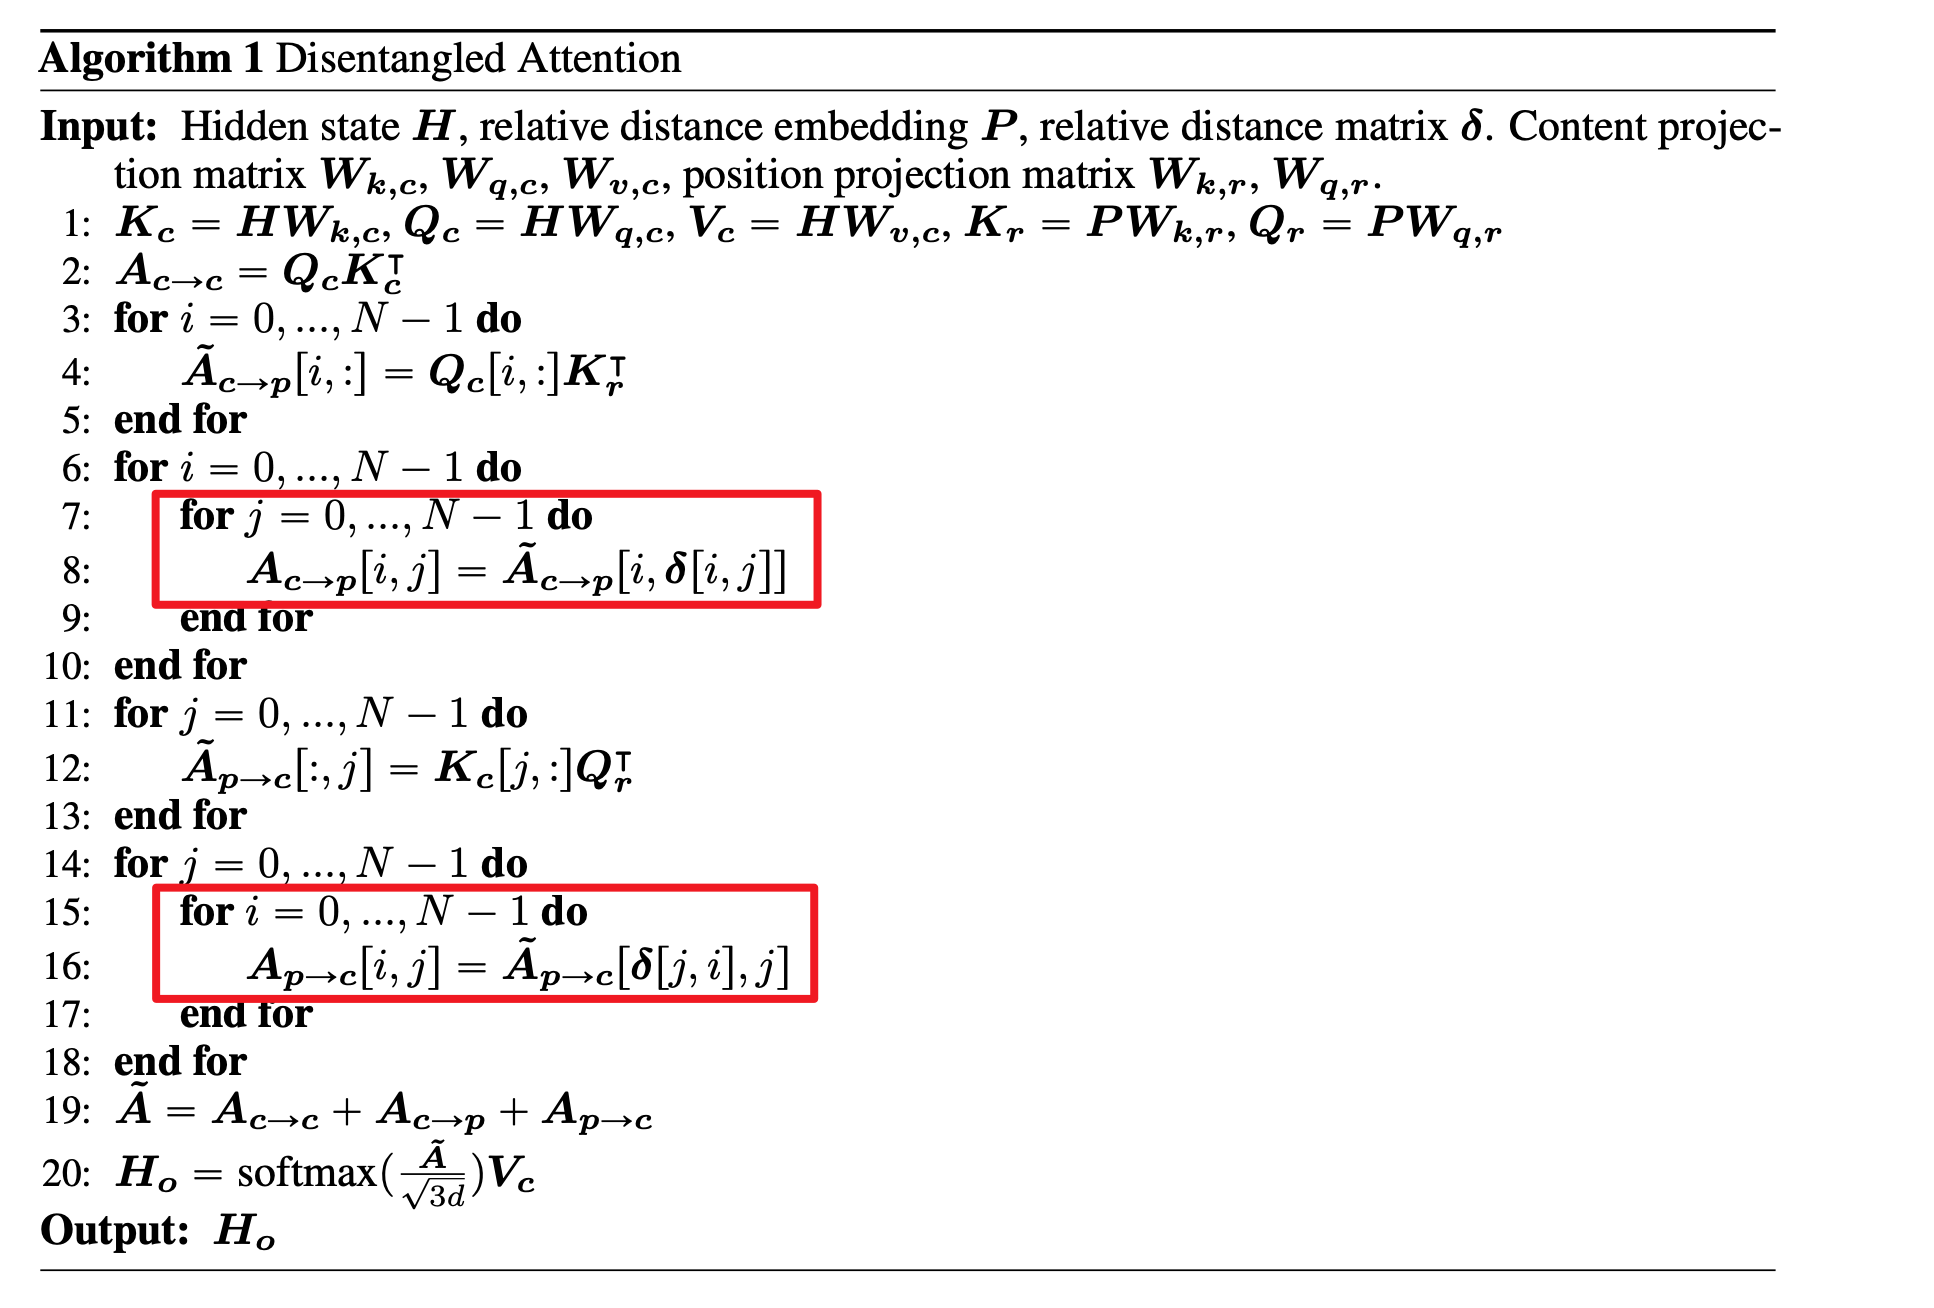
作者用Paddle复现DeBERTa,因算力有限仅跑通demo。核心难点是disentangled attention:语义与位置编码分别计算再求和,Paddle的gather仅支持一维索引,实现比PyTorch复杂。MLM预测需同时引入绝对位置编码;在layer norm后的embedding上加扰动可提升训练稳定性。
延伸解读
复现动机与算力现实
作者因算力有限,仅用Paddle跑通DeBERTa demo,未进行完整训练。这提醒读者,复现大模型需评估计算资源,可先实现核心逻辑验证理解,而非盲目追求全量训练。
Paddle gather 的实现差异
DeBERTa的disentangled attention需重排索引,PyTorch的gather可轻松实现,但Paddle的gather仅支持一维索引,无法参考其他维度值,导致实现更复杂。跨框架移植时需注意此类底层API差异。
绝对位置编码的必要性
DeBERTa在attention中引入相对位置编码,但MLM预测时仍需绝对位置编码,二者缺一不可。这提示模型设计时,不同任务可能需要组合多种位置信息,不能简单替换。
扰动训练的稳定技巧
NLP中因词汇量大,输入扰动效果不稳定。原文发现,在layer norm后的embedding上加扰动,能提升训练稳定性。这为NLP鲁棒性训练提供了一个可借鉴的实操点。
Q&A
DeBERTa 的核心创新点是什么?
DeBERTa 的核心创新是 disentangled attention,即将文本的语义编码和位置编码在计算 attention 时分别两两计算再求和。
为什么作者没有完整训练 DeBERTa 而是只跑通 demo?
因为算力有限,参考原 BERT 参数在 A100 上跑一轮需要 3 个小时,作者觉得算力顶不住,所以放弃完整训练,只用 Paddle 实现跑通 demo 来锻炼编码能力。
用 Paddle 实现 DeBERTa 时,disentangled attention 的主要难点是什么?
主要难点在于 Paddle 的 gather 函数与 PyTorch 不同,Paddle 的 index 只能是一维的,重定向 index 时无法参考其他维度的值,导致实现比 PyTorch 更复杂。
DeBERTa 在 MLM 预测时除了相对位置编码还引入了什么?
DeBERTa 在 MLM 预测时还引入了绝对位置编码,两者缺一不可。
在 NLP 中如何提升扰动训练的稳定性?
原文发现,在 layer normalized 之后的 embedding 上添加扰动,对提升扰动训练的稳定性很有帮助。
处理大规模数据集时,Paddle 的 DataLoader 提供了什么来支持逐行读入?
Paddle 的 DataLoader 提供了 IterableDataset,可以逐行读入数据,并自行编写随机逻辑。
