
小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ

本文介绍DiT(扩散Transformer),用Transformer替代U-Net作为扩散模型去噪网络。DiT在潜在空间通过patchify和adaLN-Zero条件注入,以更少计算量取得更优FID,但U-Net经调优仍具竞争力。视频生成中,时空token数量爆炸,联合注意力成本随帧数平方增长,需用分解式注意力平衡效率与一致性。Sora架构细节未公开,且承认物理模拟等局限。

【Transformer 与注意力机制】47|Diffusion + Transformer:DiT 与 Sora 为什么用 Transformer

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-08-06T00:00:00Z
emoji 也能控制语音生成?Irodori-TTS 基于 RF-DiT 架构的日语 TTS;Eczema and Tinea Skin Disease 数据集:支持医学图像分类与迁移学习

Irodori-TTS是由开发者Aratako于2026年发布的日语语音合成项目,具有高保真音质和零样本声音克隆能力。核心模型Irodori-TTS-500M-v3支持48 kHz专业音频输出,用户只需提供3-10秒的参考音频即可精准复刻目标音色,并通过Emoji注释调节情绪和语调。

emoji 也能控制语音生成?Irodori-TTS 基于 RF-DiT 架构的日语 TTS;Eczema and Tinea Skin Disease 数据集:支持医学图像分类与迁移学习

HyperAI超神经 HyperAI超神经 · 2026-07-03T09:07:54Z
字节开源统一框架Bernini:给DiT配个“大模型军师”,AI视频编辑先理解再动手

字节推出了开源视频生成与编辑框架Bernini,强调“先理解再生成”。该框架利用多模态大模型进行语义理解,并通过扩散模型实现高质量渲染,解决视频编辑中的一致性和自然性问题。Bernini支持多种编辑选项,如天气、风格和焦点,能够处理复杂视觉效果,提高创作的可控性和稳定性。

字节开源统一框架Bernini:给DiT配个“大模型军师”,AI视频编辑先理解再动手

量子位 量子位 · 2026-06-02T09:28:00Z
Ψ0——人形全身VLA:先用800h人类自视角视频数据和30h的真实机器人交互数据预训练VLM,再后训练MM-DiT,最后用AMO做下肢RL跟踪

本文介绍了Ψ0模型,该模型结合大规模人类视频数据与真实机器人数据,训练出一种用于类人机器人灵巧运动的视觉-语言动作模型,能够有效提取运动先验,实现复杂的全身控制。

Ψ0——人形全身VLA:先用800h人类自视角视频数据和30h的真实机器人交互数据预训练VLM,再后训练MM-DiT,最后用AMO做下肢RL跟踪

结构之法 算法之道 结构之法 算法之道 · 2026-03-21T11:15:57Z
X-VLA——基于Soft Prompt的Transformer编码器练就可扩展的跨本体VLA:VLM做多模态感知,DiT-style做动作生成

本文介绍了一种新型机器人学习模型X-VLA,采用软提示技术以提升跨具身机器人学习的适应性和泛化能力。通过引入可学习的嵌入,X-VLA有效解决了不同硬件和任务环境下的异质性问题,增强了模型在多样化数据集上的表现。该模型在多个基准测试中表现优异,展现出在灵巧操作和适应新领域方面的强大能力。

X-VLA——基于Soft Prompt的Transformer编码器练就可扩展的跨本体VLA:VLM做多模态感知,DiT-style做动作生成

结构之法 算法之道 结构之法 算法之道 · 2026-02-21T05:00:30Z
DualVLN——基于像素目标点的双系统VLN基础模型:VLM做全局规划且预测中期路径,DiT策略头依托高频RGR输入和“来自VLM的低频潜在特征”生成动作轨迹

本文回顾了作者创业11年的历程,并介绍了上海AI LAB发布的DualVLN模型。该模型结合视觉-语言导航推理与实时控制,采用双系统架构,分别负责高层推理和低层动作执行,提升了动态环境中的导航能力。实验结果表明,DualVLN在多种场景中表现优异,成功率高,导航误差低。

DualVLN——基于像素目标点的双系统VLN基础模型:VLM做全局规划且预测中期路径,DiT策略头依托高频RGR输入和“来自VLM的低频潜在特征”生成动作轨迹

结构之法 算法之道 结构之法 算法之道 · 2026-01-19T10:48:45Z
DiT-Air:重新审视文本到图像生成中扩散模型架构设计的效率

本文研究了扩散变换器(DiTs)在文本到图像生成中的效率,分析了架构选择和训练策略。结果表明,标准DiT在性能上与专门模型相当,但参数效率更高。通过层级参数共享策略,DiT-Air和DiT-Air-Lite在保持竞争力的同时,模型尺寸减少了66%。DiT-Air在GenEval和T2I CompBench上表现优异。

DiT-Air:重新审视文本到图像生成中扩散模型架构设计的效率

Apple Machine Learning Research Apple Machine Learning Research · 2025-12-11T00:00:00Z

Crazy Time Live van Evolution – Waar je dit popul […]

Crazy Time Live van Evolution Waar je dit populaire live dealerspel kunt spelen.203

运维派 运维派 · 2025-11-21T13:51:24Z

MySQL是流行的关系型数据库管理系统,广泛应用于WEB开发。Linux是开源操作系统,Shell脚本用于简化管理。Docker用于开发和运行应用,Tomcat是轻量级Web服务器。Jenkins是持续集成工具,Redis和memcached是高效的数据库和缓存系统。Kubernetes在云计算运维中至关重要,帮助管理容器化应用。

Crazy Time Live van Evolution Waar je dit populaire live dealerspel kunt spelen.45

运维派 运维派 · 2025-11-19T21:38:31Z

Stort udvalg af spilleautomater og live casino – er htt […]

Stort udvalg af spilleautomater og live casino – er httpsverdekaszino.orgda dit nye heldige sted med

运维派 运维派 · 2025-11-16T15:33:22Z

字节跳动的InfinityStar方法在视频生成方面超越了DiT,速度提升10倍,单GPU可在一分钟内生成5秒720p视频。其核心在于时空金字塔建模,结合静态与动态信息,提高了生成效率和质量。

何必DiT!字节首次拿着自回归,单GPU一分钟生成5秒720p视频 | NeurIPS’25 Oral

量子位 量子位 · 2025-11-14T05:43:26Z
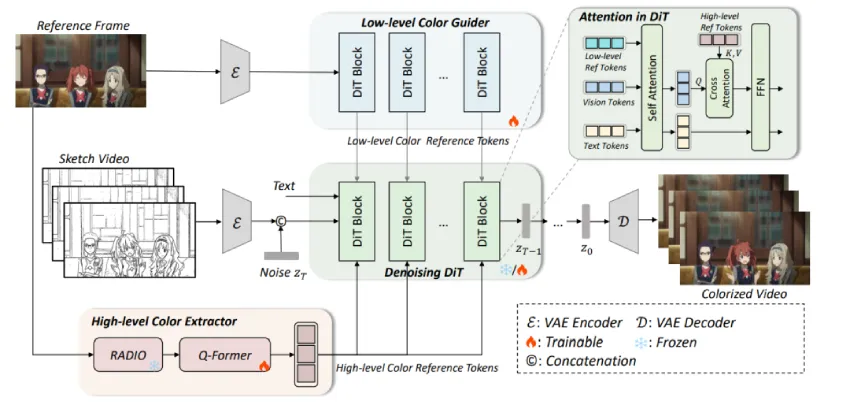
AnimeColor:基于DiT的动漫视频上色 | ACM MM 2025

本文提出了一种新型动画上色模型ColorAnime,基于视频扩散模型,能够根据参考图像自动将草图序列转化为高质量彩色动画。该模型通过高低层次颜色提取器实现颜色一致性和细粒度控制,克服了现有方法在大幅运动场景中的不足,实验结果表明其在颜色准确性和视频质量方面表现优异。

AnimeColor:基于DiT的动漫视频上色 | ACM MM 2025

实时互动网 实时互动网 · 2025-09-28T02:15:33Z

本文探讨了大型行为模型(LBM)在波士顿动力人形Atlas中的应用,强调其在复杂任务中的表现。LBM通过多任务数据集训练,提升了机器人在动态环境中的自主互动能力。研究表明,LBM在微调新任务时仅需少量数据,并且在应对环境变化时表现更为稳健。尽管取得了一定进展,仍面临评估标准化和数据收集等挑战。

LBM——大型行为模型助力波士顿人形Atlas完成多任务灵巧操作:CLIP编码图像与语义,之后DiT去噪扩散生成动作

结构之法 算法之道 结构之法 算法之道 · 2025-08-29T13:36:25Z

DiT模型受到质疑,网友认为其数学和形式上存在错误,甚至怀疑是否使用了Transformer。作者谢赛宁回应称,科学进步需要发现模型的不足,强调实证方法的重要性,并反驳质疑,指出Tread模型与DiT无关,且DiT在生成效果上仍具优势。

DiT突遭怒喷,谢赛宁淡定回应

量子位 量子位 · 2025-08-20T08:05:07Z

机器之心数据服务现已上线,提供高效稳定的数据获取服务,帮助用户轻松获取所需数据。

DiT在数学和形式上是错的?谢赛宁回应:不要在脑子里做科学

机器之心 机器之心 · 2025-08-20T04:54:49Z

机器之心数据服务现已上线,提供高效稳定的数据获取服务,帮助用户轻松获取所需数据。

告别Transformer!北大、北邮、华为开源纯卷积DiC:3x3卷积实现SOTA性能,比DiT快5倍!

机器之心 机器之心 · 2025-07-11T08:37:52Z

普林斯顿大学与Meta合作推出LinGen框架,通过MATE模块将视频生成复杂度降低至线性,显著提升生成效率。LinGen在视频质量上优于DiT,生成速度最高可加速15倍,且适应性强,能处理更长的token序列。

单GPU搞定高清长视频生成,效率×10!引入Mamba机制突破DiT瓶颈 | 普林斯顿&Meta

量子位 量子位 · 2025-06-18T08:23:59Z

机器之心数据服务现已上线,提供高效稳定的数据获取服务,简化数据爬取流程。

李飞飞团队新作:DiT不训练直接改架构,模型深度减半,质量还提高了

机器之心 机器之心 · 2025-06-10T09:16:16Z

机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。

智象未来x商汤大装置:全栈赋能全球首个开放使用视频生成DiT模型

机器之心 机器之心 · 2025-04-28T06:56:27Z

智象未来推出全球首个开放使用的DiT模型,依托商汤强大的AI基础设施,实现快速模型迭代。该模型高效、灵活、稳定,广泛应用于影视和教育领域,推动文生视频技术发展。

全栈AI基础设施支撑,跑出全球首个开放使用视频生成DiT模型

量子位 量子位 · 2025-04-28T03:15:07Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码