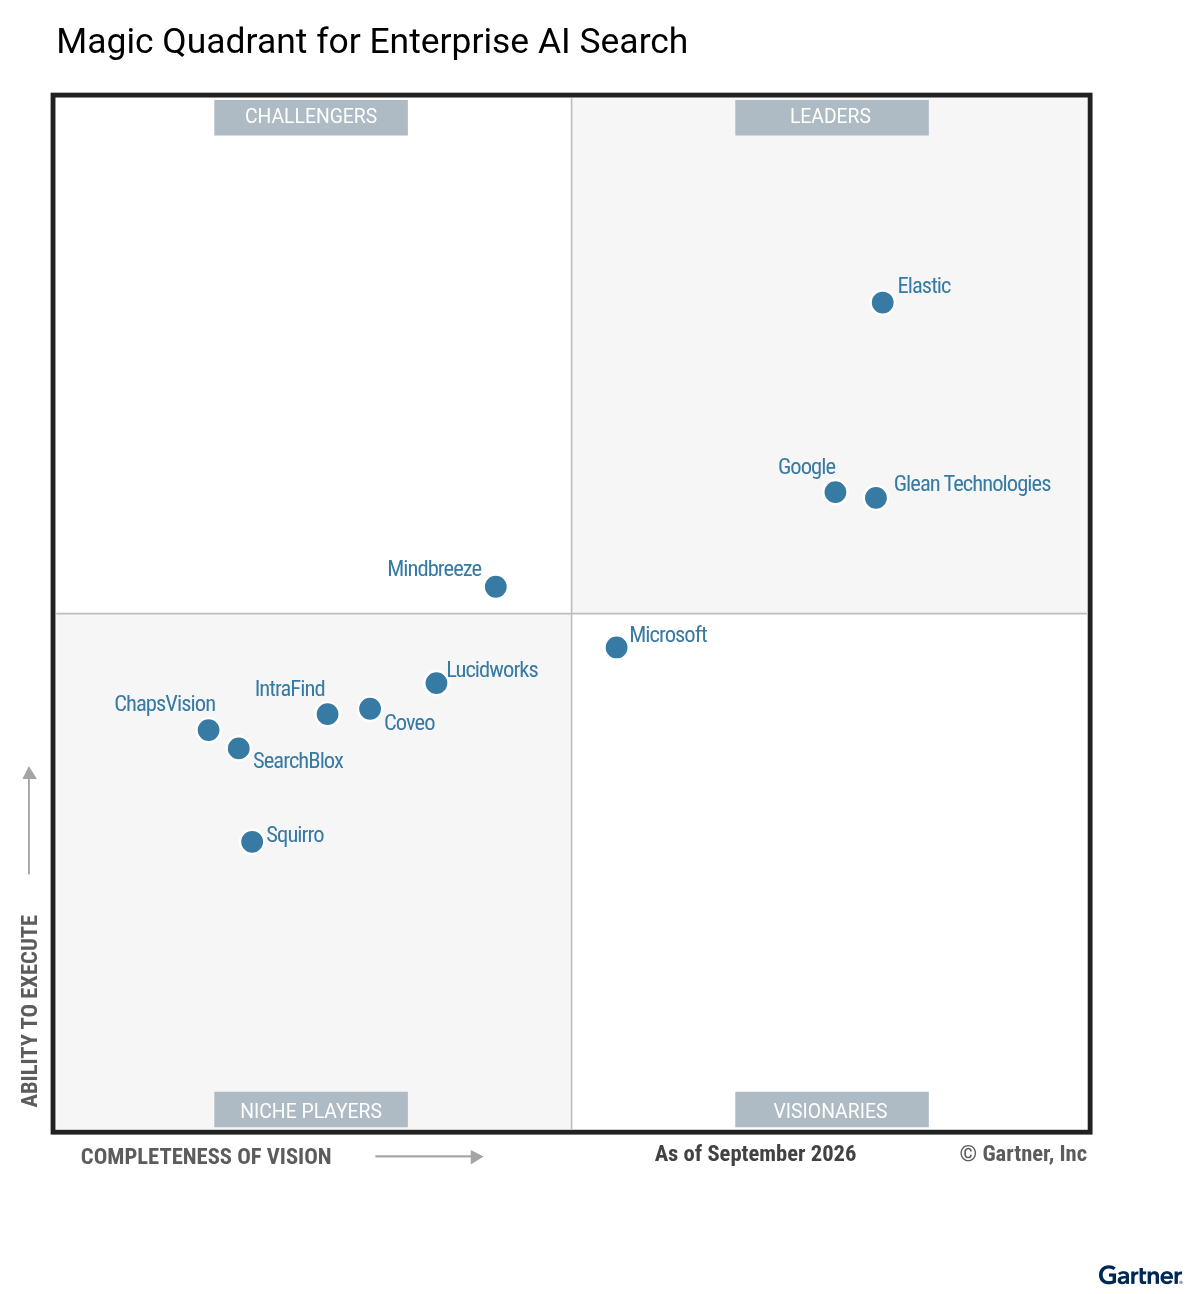
Elastic在2026年Gartner企业AI搜索魔力象限中被评为领导者,仅三家厂商入选,且在执行能力和愿景完整性上均居首位。在关键能力报告中,Elastic的AI自动化用例排名第一。其Elasticsearch平台融合全文、语义与混合搜索,为AI代理提供精准上下文,已服务超1.8万家企业,并持续投资向量搜索与AI检索。
本文介绍Elasticsearch的基本概念与指标:近实时搜索延迟约1秒;集群由多节点组成,统一进行索引和搜索;节点是集群中的服务器;索引是相同特性文档的集合;文档是最小索引单元,以JSON表示;分片用于突破单机存储限制,副本保障可用性;fielddata用于文本字段内存查询;doc values支持高效聚合;norms存储评分因子;召回率衡量查全,准确率衡量查准。
测试环境ES因索引分片过多、副本多且磁盘性能差,导致单机IO打满、查询超时。优化建议:改用SSD,分片减至2个,副本减为1,并引入Tair缓存,让ES仅处理复杂查询以减轻压力。
本文讲述Phorge搜索服务在接入真实Elasticsearch和Meilisearch后暴露的兼容性问题。因Elasticsearch版本升级移除mapping type,Gorge需按版本调整索引结构、写入路径和查询过滤,并修复include_in_all、not query等过时语法。Meilisearch则需声明id为可过滤属性。通过增加结构关系测试和真实后端联调,确保协议兼容。
Elastic{ON} 2026将于2026年9月至2027年3月巡回孟买、纽约等七城并举办线上活动。大会聚焦将数据转化为AI优势,设搜索、可观测性、安全三大专题,展示Elasticsearch为智能体提供上下文、AI SRE自主排障及SOC智能体检测等新功能,含主题演讲、工作坊与演示。
Elastic{ON} 2026全球巡演将于9月启动,覆盖孟买、纽约、阿姆斯特丹、旧金山、伦敦、新加坡等城市,持续至2027年3月。活动聚焦AI与数据价值,设有搜索、可观测性、安全三大主题,展示Elasticsearch在代理扩展、AI运维和SOC自动化方面的进展,并提供工作坊、演示和社交机会。
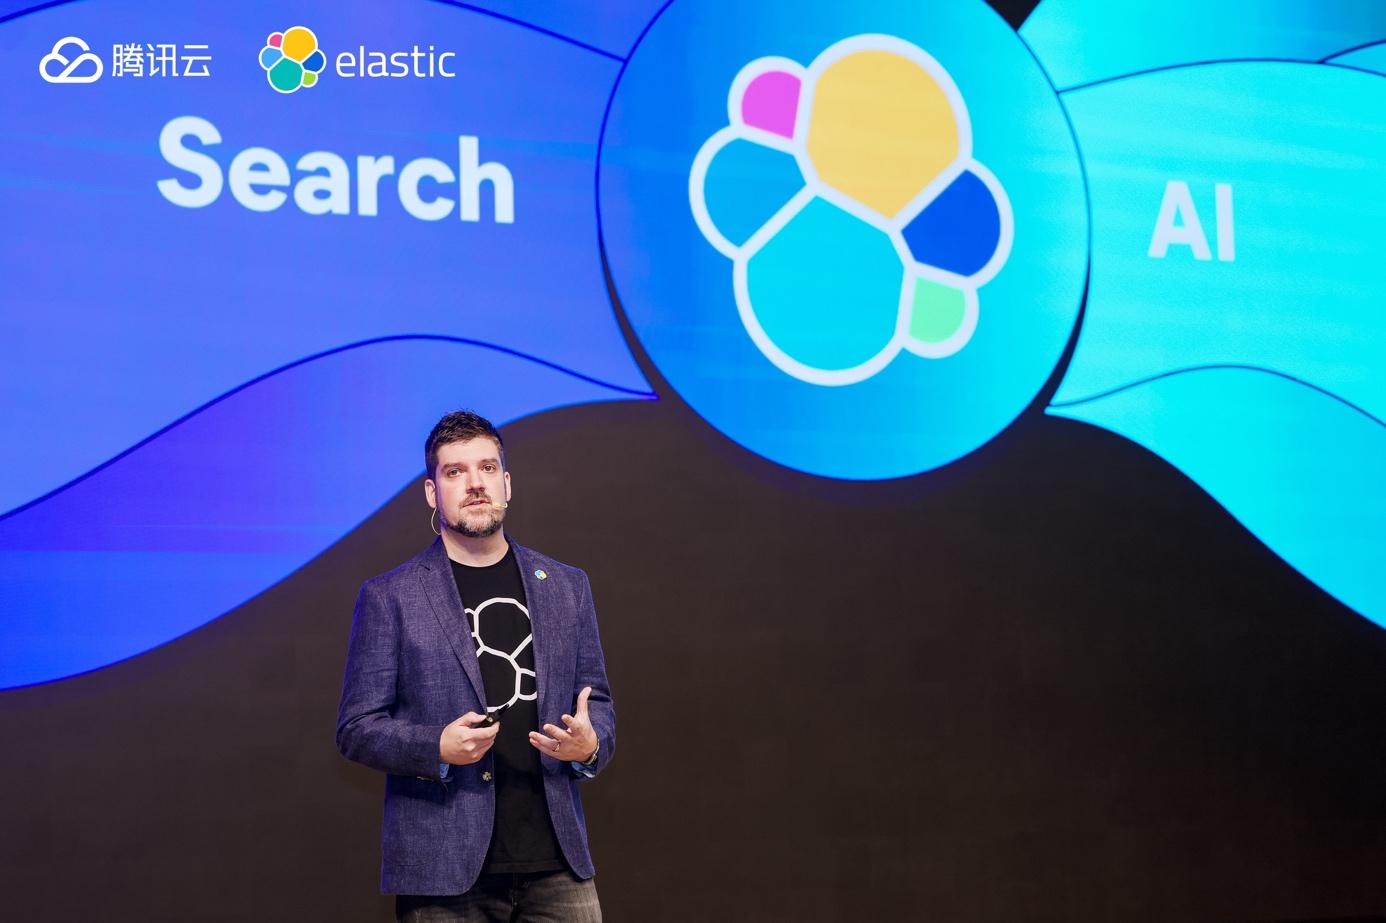
腾讯云与Elastic深化战略合作,联合推出腾讯云Elasticsearch服务企业版,强化AI搜索、模型集成与智能体连接。该版本性能提升最高5倍,混合搜索延迟降低60%,内存消耗减少超50%。已应用于腾讯ima和蔚来汽车,支持大规模数据处理与安全分析,助力企业构建AI时代搜索基础。
ECK 3.5 更新包括:动态命名空间管理(通过标签选择器实时增删,无需重启)、暂停编排(维护窗口期暂停规格变更)、全组件双向 TLS、StackConfigPolicy 改进(声明式角色和动态变量)、简化资源设置、降低内存占用等。这些功能提升 Kubernetes 上 Elasticsearch 运维的灵活性和安全性。
IDC研究显示,Elasticsearch平台为11家大型企业带来年均1340万美元收益,三年ROI达517%,投资回收期11个月。该平台将向量搜索、混合搜索与AI集成,使AI产品上市时间缩短40%,搜索相关性提升44%,开发效率提高27%,员工每年节省150小时,成为AI驱动业务增长的基础。
本文讨论了单节点复现脚本与命令记录,基于Lucene和Elasticsearch的官方文档与源码。建议在Linux或WSL2环境中运行Elasticsearch 8.x或Lucene示例工程,并提供了具体的实验步骤和版本号,以确保实验结果的准确性。
本文介绍了从自建Elasticsearch迁移到Amazon OpenSearch Service的实践,重点在查询兼容性验证与BBoss应用适配。实测结果显示,大部分查询无需改动,只有k-NN向量搜索需要重写。通过BBoss框架的多数据源能力,应用层改动降到最低,实现了平滑切换,确保了数据完整性与查询一致性。
本文介绍了从自建Elasticsearch迁移到Amazon OpenSearch Service的实践,重点在于向量索引的迁移与Amazon Bedrock集成。讨论了两条迁移路线:保留原有Embedding模型的搬运和更换模型的全量重建。详细阐述了如何在OpenSearch中集成Amazon Bedrock Titan V2,包括应用端调用和Neural Search两种方式,并评估了迁移后的向量搜索精度。
本文介绍了从自建Elasticsearch 8.17迁移到Amazon OpenSearch Service的实践,重点在数据迁移与同步。迁移过程中面临数据同步、查询兼容性和Embedding模型切换等挑战。推荐使用Migration Assistant进行零停机迁移,以确保数据的完整性和一致性。后续将探讨向量索引迁移及查询兼容性验证。
本文讨论了BM25算法在全文检索中的应用,分析了其公式、参数及与TF-IDF的区别。BM25通过饱和TF和长度归一解决了传统TF在长文档中的失效问题,并提及了Lucene和Elasticsearch的实现细节,强调了BM25在召回和可解释性方面的重要性。此外,文章探讨了BM25与学习排序的关系及其在实际应用中的工程边界。
本文讨论了Elasticsearch中的性能问题及解决方案,包括写入拒绝、搜索慢、内存高和结果不全等症状,分析了可能的原因并提供了决策树以帮助排查。强调了电路断路器和刷新频率对性能的影响,建议通过合理配置和监控来优化集群性能。
本文探讨了Elasticsearch和Lucene中DocValues的使用,强调其在排序和聚合中的重要性。DocValues以列式存储优化字段访问,适合高效的排序和聚合操作,而stored字段则用于获取原文。使用DocValues可以提高查询性能,避免对分析文本字段进行聚合的误区,并讨论了设计时的注意事项和未来的开放问题。
本文探讨了Elasticsearch、OpenSearch和Solr三种全文检索引擎的核心差异,重点在许可、社区和部署形态。Elasticsearch与OpenSearch共享Lucene内核,但在许可和插件生态上有所不同。Solr作为独立搜索服务器,主要服务于政企和Hadoop生态。选择发行版时应考虑许可和运维团队的需求,而非仅比较性能。
本文是「全文检索引擎」系列的第一篇,探讨了倒排索引的架构与实现,分析了Lucene与Elasticsearch的关系,阐述了文本如何处理成可搜索的词项,以及查询在倒排列表中的执行方式。文章还区分了不同类型的搜索引擎,强调了全文检索引擎在文本与查询处理中的复杂性和重要性。
本文讨论了Elasticsearch中动态映射导致的字段爆炸问题及其对聚合性能的影响。动态映射在遇到新键时会创建新字段,可能导致索引无法打开。建议使用有界模式(如dynamic: false)以避免字段数量过多,从而影响集群状态和性能。聚合操作主要依赖DocValues而非倒排索引,以确保高效的数据处理。
本文讨论了在Elasticsearch和Lucene中结合稀疏BM25与稠密kNN进行混合检索的策略,重点分析了两种索引的共存、查询策略及其对性能的影响。混合检索需同时利用BM25和kNN信号,以确保候选文档的一致性和可比性。文章还探讨了写入路径、代价模型及与专用向量引擎的边界问题,强调了统一Segment生命周期的重要性。
完成下面两步后,将自动完成登录并继续当前操作。