GLM-Legal发布!智谱把法律推理塞进AI,但它的成绩单有点难看! 10月12日,智谱推出GLM-Legal,一款专攻法律任务的AI代理模型,号称在Harvey LAB基准上拿到19.2%的全通过率,比自家基座提升12.5个百分点。 这个数字在同类模型里算拔尖,却同时暴露了法律AI最尴尬的真相:一个靠“推理”吃饭的模型,它的训练底座在两个月前刚因为“静默上传全部代码库”被企业公开追
作者提交的Omarchy插件被安全机器人发现漏洞,Codex以安全理由拒绝分析,而离线GLM 5.3 Flash用5分钟确认漏洞比issue所述更严重,给出完整修复方案和补丁,并自动完成安全攻防测试。作者认为离线GLM在漏洞修复上强于GPT,因GPT线上安全策略拒绝服务,并断言AI时代属于线下推理。
Anthropic红队指出GLM-5.3在高级网络攻防任务上能力接近Claude Mythos,但拒绝与安全护栏薄弱。作者认为,将AI Agent接入工单、CI、代码审查等系统时应收紧权限边界,避免宽权限账号;护栏不能只靠模型拒绝,需工具调用分级、敏感操作人工确认、环境隔离和日志审计。小团队应把AI当作会误判的自动化账号管理,不让其直接持有生产凭证或未经审批修改CI/CD配置。
GitHub热门开源项目Colibrì是一个纯C实现的分层推理框架,通过将MoE模型不常用的专家权重存放在SSD、常用部分缓存在RAM/VRAM,使低配设备也能运行超大模型。它支持GLM-5.2、Kimi K3等9个模型,最低16GB内存即可运行744B模型,无需GPU,并采用LRU缓存与专家预测提升速度。
GLM 5.3 FlashX 已在 AI Gateway 上线,这是 Z.ai 多模态编码模型的高速服务选项,推理速度约每秒 200 个 token,适合编码代理、工具循环和交互式应用。可通过 API 及编码代理使用 zai/glm-5.3-flashx,AI Gateway 提供统一 API、用量与成本追踪、重试和故障转移,且不收取平台费。
智谱GLM-5.3-Flash在超10万颗国产AI加速器上两周完成部署,吞吐提升3.2倍。GLM-5.3驱动的Infra Agent参与优化,定位精度与调度问题,将KV传输开销从30%降至1%以下。团队提出dense feedback机制,让AI理解性能变化原因。唐杰称递归自我改进的早期形态已现:模型优化系统,系统服务模型。
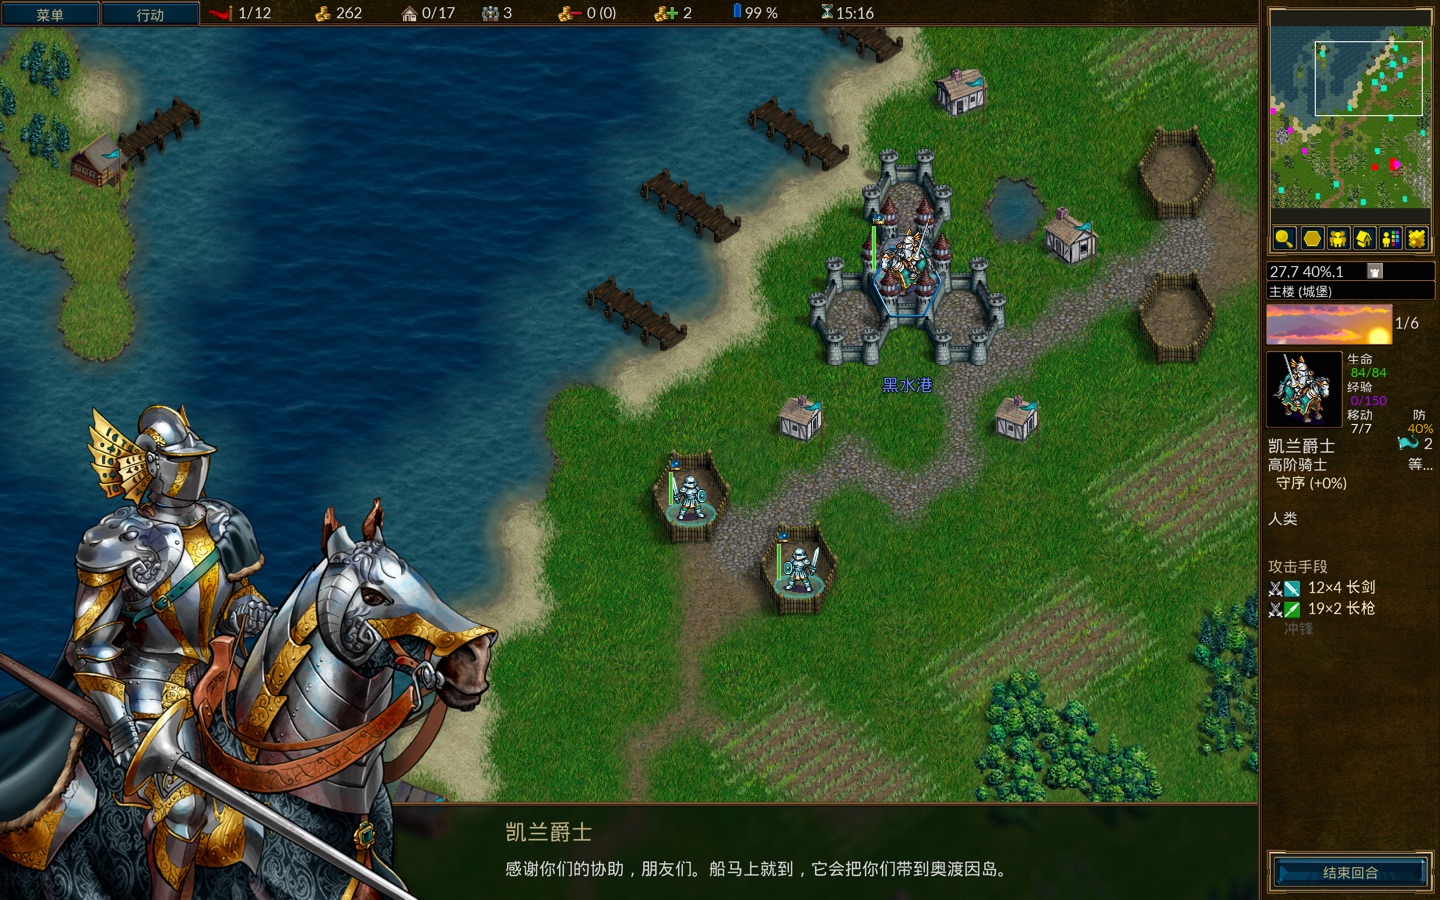
作者让DeepSeek、GLM等模型在沙箱中仅靠截屏和模拟键鼠操作玩开源战棋《韦诺之战》。DeepSeek前期受困于环境问题,后通过解析存档取得突破;GLM能精准点击并推进至第3关,但两关后仍遇挫。实验显示AI可涌现动态规划能力,却难以独立完成长期策略,需人类系统指导。
智谱上市不到九个月再融约393亿港元,约六成投入下一代GLM与“完全自训练”体系(递归式自我改进闭环,涵盖数据自产、环境自造、基础设施自我优化),并提升多模态与长程任务强化学习能力;其余用于业务拓展、战略投资、并购及补充运营资金。上市后累计净募约755亿港元,并透露拟赴科创板上市。
Mostik团队开发了一种“桥”技术,使大模型(如753B的GLM-5.2)能直接向小模型(如4B的Qwen-3.5)传递隐藏状态,无需文本输出,从而将小模型性能提升50%,准确率提高25%,推理成本降至二十分之一。该技术基于模型内部状态包含深层计算信息,团队由菲尔兹奖得主领导,正探索蒸馏和专项化应用。
本期播客回顾科技界重大动态:苹果CEO换帅,John Ternus接任;AI领域Fable 5.1发布,GLM-5.3-Flash以高性价比引发关注;英伟达拟129亿美元收购Hugging Face。此外,OpenAI与Broadcom合作研发芯片,苹果标注AI内容,小米发布玄戒芯片,李飞飞团队推出世界模型Atlas,宇树科技上市等。
GLM 5.3 Flash与DeepSeek V4 Flash在Hermes Agent实测对比:GLM跑分高但落地差,工具调用不稳、不守Agents.md规则;DeepSeek虽参数少、跑分低,但干活稳,被社区推荐为默认模型。文章指出评测与实战脱节,Agent场景更需“听话”模型,便宜非关键,能干活才是王道。
GLM-5.3在AI Gateway上通过DigitalOcean提供50%折扣,有效期至9月8日。使用促销名称zai/glm-5.3-promo可享优惠,但仅限DigitalOcean且结束后失效;标准名称zai/glm-5.3则持续可用,支持多提供商路由。模型支持1M上下文和128K输出,可在playground或编码代理中使用。
GLM-5.3-Flash是Z.AI推出的低成本模型,价格约为旗舰版GLM-5.3的1/16。测试显示两者在编码、逻辑和提取任务中均得满分,准确性无差异,但Flash在困难任务中消耗更多token和时间,其成本优势依赖当前定价,可能变化。建议Flash适合简单任务,复杂任务需权衡时间与成本。
智谱发布GLM-5.3模型,总参数743B,采用MoE架构,激活39B,支持1M窗口,强化编程、智能体及网络安全能力。模型权重免费开源可商用,但非MIT许可证,营收超100亿美元的大型MaaS服务商需先申请审查,个人和普通企业不受影响。
TensorSharp 是纯 .NET LLM 推理引擎,三天内接入 GLM-5.3-Flash 和 Qwen3.8-Flash-Next 新架构。它支持进程内推理,性能上 decode 速度翻倍,prefill 持平,并强调正确性验证和部署便捷性。对 .NET 团队,这标志着前沿模型架构跟进加速,值得纳入 PoC 评估。
中国AI实验室Z.ai发布旗舰模型GLM-5.3,开放权重但采用限制性许可证,要求年收入超100亿美元的公司托管前需安全审查。模型性能接近美国前沿实验室,但许可证比DeepSeek等更严格,此举或为商业化考虑,因Nvidia和Stripe正收购模型平台,开源模型可能成为带条款的分发渠道。
智谱GLM-5.3-Flash的token套餐性价比低,缓存命中率仅8成,实际用量远低于宣传。对比opencode go的15美元额度,智谱lite月费118元仅约4.3亿token,pro约25亿,max约60亿,相当于70元买538元pro套餐,性价比差。目前经济实惠的tokenplan仅gpt、opencode、commandcode可选,作者怀念DeepSeek涨价前的低价,现靠Muse Spark维持。
智谱发布并开源GLM-5.3-Flash多模态模型,性能超GLM-5.2,与Claude Opus 4.8持平。商汤大装置提供国产算力支持,通过异构混推技术提升服务性能3倍,成本与英伟达GPU相当,推动国产算力规模化商用,日均Token服务量达2.42万亿。
智谱发布开源原生多模态模型GLM-5.3-Flash,采用MoE架构,支持文本图像输入及百万Token上下文,性能与Claude Opus 4.8持平,API定价大幅降低。同时,Perplexity推出端侧AI智能体,明基发布专业显示器,Google推出语音转文本模型及视频生成模型,英伟达发布定制高带宽内存,微软Xbox推出光盘数字化功能。
阿里云下调Qwen3.8-Flash调用价格,输入降至0.8元/百万,输出降至2.7元/百万,调整后比智谱GLM-5.3-Flash原价便宜0.1元,但智谱当前限时5折,价格仍具优势。阿里云调价对标智谱原价,两周后或显优势。
完成下面两步后,将自动完成登录并继续当前操作。