

周末我决定教 DeepSeek Harness 玩游戏
内容提要
作者让DeepSeek、GLM等模型在沙箱中仅靠截屏和模拟键鼠操作玩开源战棋《韦诺之战》。DeepSeek前期受困于环境问题,后通过解析存档取得突破;GLM能精准点击并推进至第3关,但两关后仍遇挫。实验显示AI可涌现动态规划能力,却难以独立完成长期策略,需人类系统指导。
延伸解读
环境适配是AI操作游戏的第一道坎
文章显示,DeepSeek在游戏第一阶段完全无法推进,根源并非策略不足,而是DPI缩放、虚拟桌面隔离、窗口尺寸、SDL输入限制等环境问题。这些细节说明,让AI在非AI设计的软件中操作,首先需要解决底层交互的可靠性。读者可从中看到,AI落地不仅依赖模型能力,还高度依赖对运行环境的精细调试。
存档解析成为突破视觉误判的关键
DeepSeek通过解析游戏自动存档,获得了单位坐标、血量、移动力等硬数据,从而发现之前“点击无效”的结论是误判。这提示,当视觉反馈不可靠时,直接读取程序状态是更可信的验证方式。对AI应用而言,建立“动作→客观验证”的闭环,比盲目尝试更有效率,也能避免在假象中浪费大量轮次。
长期策略需要人类系统指导
GLM能精准操作并推进到第3关,但两关后仍遇挫;DeepSeek虽能大规模回溯,却始终未找到有效征募和培养单位的策略。文章指出,AI已初步具备动态规划能力,但缺乏人类成系统的指导时,难以独立解决长期策略问题。这提醒我们,当前AI在复杂任务中更适合作为执行者,而非完全自主的决策者。
模型间协作与差异值得关注
实验中,DeepSeek擅长静态分析和回溯,GLM在精准点击和操作手册总结上表现突出,而Kimi模型则因额度消耗过快未能深入。作者最终发现,GLM的复合能力对突破瓶颈至关重要。这说明不同模型各有长短,组合使用可能比单一模型更有效,但也要注意资源消耗和任务匹配度。
Q&A
DeepSeek Harness 玩《韦诺之战》的实验是怎么设置的?
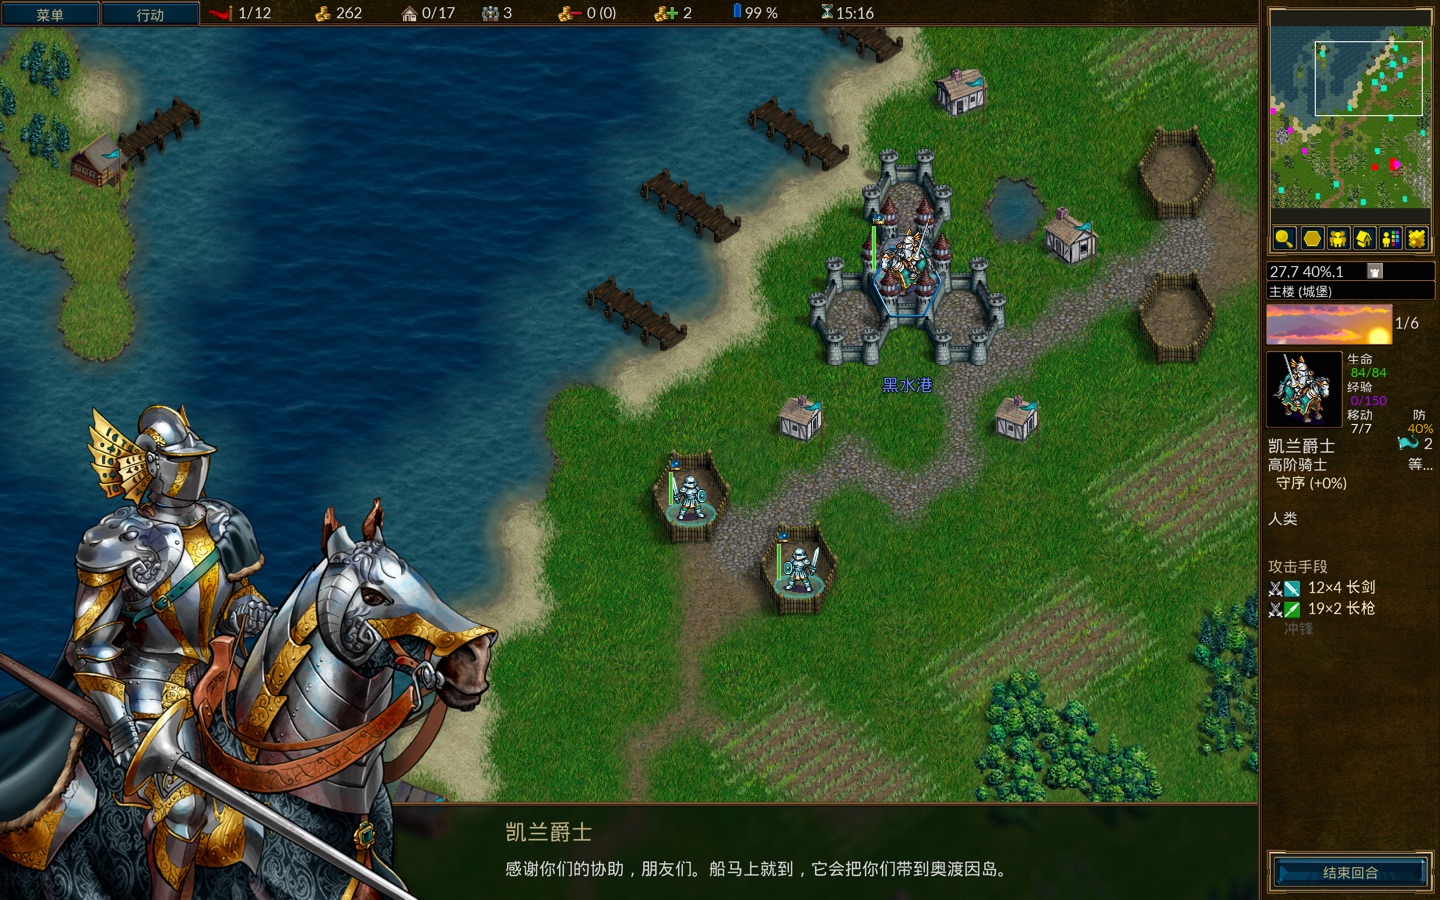
Agent 运行在 Windows 沙箱中,只能通过 PowerShell 截屏、移动光标、注入键鼠事件和读写文件来操作游戏,没有任何为 AI 设计的接口,必须像人类玩家一样自己学会玩。
DeepSeek 在实验第一阶段遇到了哪些主要困难?
第一阶段 14 轮游戏推进为零,遇到 DPI 缩放导致坐标偏移、虚拟桌面隔离使输入无效、游戏进程未响应造成冻结假象、窗口太矮裁掉按钮、点击边缘 UI 触发视野漂移、AI 回合耗时数分钟、SDL2 不吃组合键、无法验证操作是否生效等 8 个环境问题。
实验的转折点是什么?存档解析如何帮助 AI 突破?
转折点是发现游戏自动存档是 gzip 压缩的 WML 文本,可解析出关卡、金币、单位坐标、血量等硬数据。wes_state.ps1 成为唯一可信事实来源,建立了动作→验证闭环,纠正了之前“地图点击无效”的误判,并发现了 goto 跨回合行军机制。
GLM 在实验中表现如何?它比 DeepSeek 强在哪里?
GLM 通过看截图就能准确找到操作,实现了 DeepSeek 无法解决的精准点击,并进入真正的游戏策略思考。它突破了卡死 DeepSeek 的瓶颈,还给自己写了操作手册,但最终也卡在第 3 关,进度 2/23。
AI 在《韦诺之战》中为什么难以通关第 3 关?
第 3 关需要 25 回合内击杀兽人领袖,但龟守必败、逃跑必败,唯一窗口是速攻斩首,却需要协调 8 个单位精确点击,效率不足以支撑战术窗口。此外 AI 不重视占领村庄发展经济,也没有培养高级单位,导致长期策略失败。
实验最终得出了什么结论?
今年的 LLM 已初步具备动态规划能力,能自发涌现强化学习行为,但如果没有人类成系统的指导,仍不能有效解决长期策略问题。实验共 30 轮,进度 2/23 关,产出 13 份文档和 20+ 个 PowerShell 脚本。
