小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
硅谷AI现状:谁有算力谁是爹

硅谷AI算力争夺加剧。Anthropic向SpaceX购买算力,马斯克成为GPU中间商;谷歌因算力不足流失顶尖研究员Shazeer至OpenAI;初创公司被迫签高价长约或全球寻找算力,顶级VC亲自囤积GPU。H100租赁价一年涨近40%,算力正成为AI时代准入门槛,强化大公司优势。

硅谷AI现状:谁有算力谁是爹

量子位 量子位 · 2026-10-11T05:22:38Z
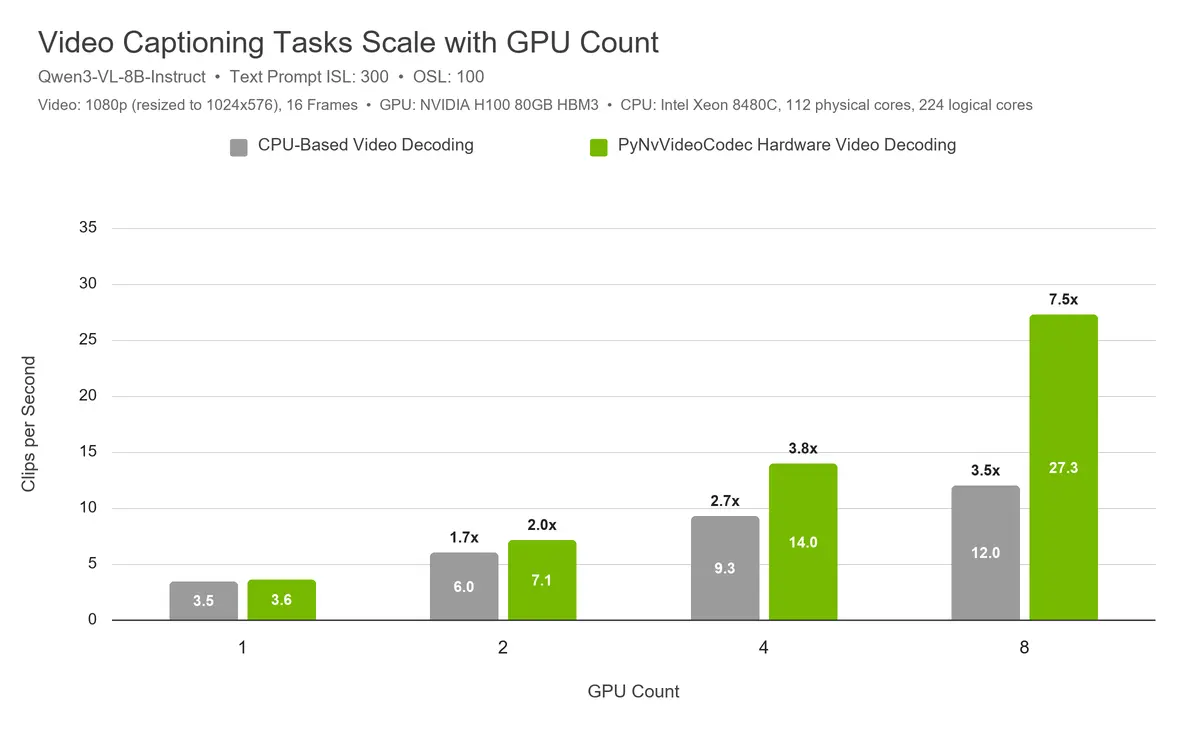
vLLM 新增支持 NVIDIA GPU 硬件视频解码,多 GPU 视频描述吞吐最高提升一倍以上

vLLM 通过集成 PyNvVideoCodec 正式支持 NVIDIA GPU 硬件视频解码(NVDEC),将视频解码从 CPU 迁移至 GPU,解决视频描述任务的 CPU 瓶颈。在 8 块 H100 配置下,吞吐量达 CPU 解码两倍以上;此前不足 4 卡即受制于 CPU,现瓶颈消除。该功能随标准 CUDA 版 vLLM 提供,需安装 PyNvVideoCodec==2.0.4,并建议先启动 CUDA MPS 守护进程。

vLLM 新增支持 NVIDIA GPU 硬件视频解码,多 GPU 视频描述吞吐最高提升一倍以上

实时互动网 实时互动网 · 2026-09-18T03:37:17Z
蛋白预测快2.9倍,科学AI最难的是让整条流水线不空转

NVIDIA推出BioNeMo推理运行时,通过内核选择、CUDA Graph和Ray流水线优化蛋白结构预测。在8张H100上,Boltz-2吞吐达每GPU小时5.85万残基,较公开实现提升2.9倍。文章强调科学AI吞吐应以成功结构数和完整流程时间衡量,需关注CPU预处理、写盘和失败率等瓶颈。

蛋白预测快2.9倍,科学AI最难的是让整条流水线不空转

Java for You Java for You · 2026-09-13T03:44:00Z
Cerebras晶圆级芯片90万核跑大模型 比H100快200倍

Cerebras推出的晶圆级芯片拥有90万个核心,速度比H100快200倍。每个核心仅有48KB内存,采用消息驱动编程,适合稀疏计算和图神经网络。尽管编程复杂,但在推理任务上表现出色,能显著降低成本,吸引大公司使用。

Cerebras晶圆级芯片90万核跑大模型 比H100快200倍

极道 极道 · 2026-07-08T11:06:00Z
七家中国AI芯片公司出货H100级产品完整清单

七家中国AI芯片公司已推出H100级产品,华为、阿里和百度为市场主导者,沐曦和摩尔线程等为新兴企业。华为昇腾占据49%市场份额,阿里平头哥和百度昆仑芯紧随其后。国产芯片逐渐取代英伟达,市场份额从95%降至55%。FlagOS软件栈促进不同芯片的兼容性,推动国产AI生态的发展。

七家中国AI芯片公司出货H100级产品完整清单

极道 极道 · 2026-06-25T05:48:00Z
一千台599美元Mac mini替代H100跑大模型:便宜十倍

一千台599美元的Mac mini可以替代昂贵的H100服务器,具有低成本和低功耗的优势。Mac mini的统一内存架构提升了AI模型的运行效率,适合本地部署。相比之下,云服务费用高昂,使用Mac mini搭建AI服务器简单易行,能有效节省成本。

一千台599美元Mac mini替代H100跑大模型:便宜十倍

极道 极道 · 2026-06-03T22:26:00Z
NVIDIA H100的CUDA编程

学习CUDA编程,掌握NVIDIA Hopper GPU的WGMMA管道和Cutlass优化,适用于大规模矩阵乘法和现代AI。课程包括多GPU扩展及训练万亿参数模型所需的NCCL原语,需具备C++和线性代数基础。

NVIDIA H100的CUDA编程

freeCodeCamp.org freeCodeCamp.org · 2026-04-09T22:44:17Z

A100和H100是英伟达的旗舰GPU,分别用于深度学习和高性能计算。A100基于Ampere架构,H100采用Hopper架构,性能显著提升。A800和H800是中国市场专供版,H20为新一代受限GPU。搭建算力中心需考虑算力需求、GPU选择、计算环境和软件配置。AI训练关注高带宽和精度,推理则重视低延迟和高吞吐量。

英伟达算力GPU主要型号及参数

安志合的学习博客 安志合的学习博客 · 2025-12-12T21:47:06Z
NVIDIA H100 GPU在CoreWeave的AI云平台上实现Graph500基准测试的破纪录表现

NVIDIA在Graph500基准测试中以每秒410万亿边的速度获胜,使用8192个H100 GPU处理2.2万亿顶点和35万亿边,性能是其他方案的两倍,推动高性能计算的发展。

NVIDIA H100 GPU在CoreWeave的AI云平台上实现Graph500基准测试的破纪录表现

NVIDIA Blog NVIDIA Blog · 2025-12-10T20:56:53Z

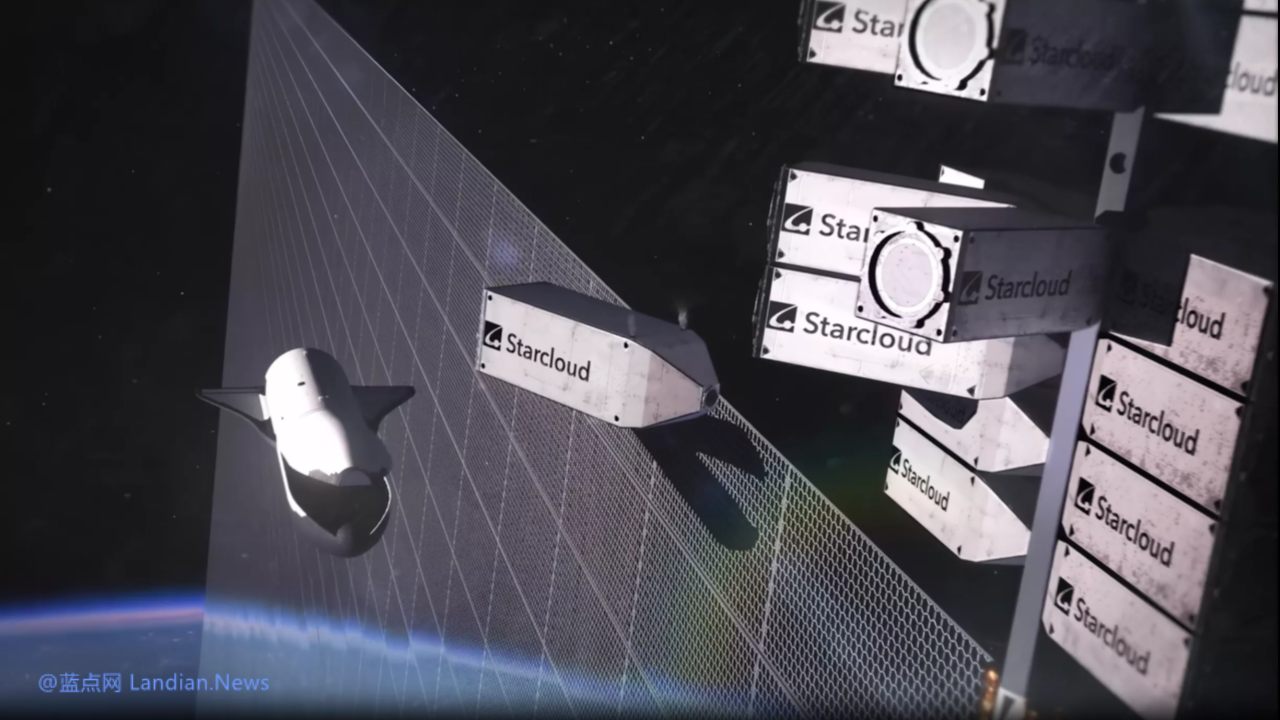
英伟达与谷歌在太空AI算力竞争中加速,英伟达的H100已由Starcloud卫星发射,谷歌计划在2027年发射TPU。同时,中国的之江实验室已发射12颗计算卫星,展现出强大的计算能力,太空AI竞赛愈发激烈。

AI算力大战打到太空!英伟达前脚H100入轨,谷歌TPU后脚上天,中国玩家笑而不语

量子位 量子位 · 2025-11-05T02:33:30Z
美国初创公司计划将英伟达H100加速器发射到太空 利用太阳能供电和宇宙低温提高效率

美国初创公司Starcloud计划于2025年发射搭载英伟达H100 GPU的Starcloud-1卫星,该卫星将利用太阳能供电并在太空中运行。尽管太空散热条件良好,但辐射散热效率低,故障维修困难,可能引发太空垃圾问题。

美国初创公司计划将英伟达H100加速器发射到太空 利用太阳能供电和宇宙低温提高效率

蓝点网 蓝点网 · 2025-10-24T02:45:30Z
在欧盟推出由NVIDIA HGX H100加速的GPU Droplets

NVIDIA HGX H100 GPU Droplets已在阿姆斯特丹数据中心上线,满足高性能计算需求。WindBorne Systems利用其进行实时预测模型训练,表现优于其他云服务。该服务易于使用,支持快速部署和安全合规,且价格合理。

在欧盟推出由NVIDIA HGX H100加速的GPU Droplets

The DigitalOcean Blog The DigitalOcean Blog · 2025-10-07T20:57:57Z
硅谷惊变:12万张H100的挽歌

2025年,Meta LLaMA项目开发者因中国团队DeepSeek的论文震惊,后者仅用2000张GPU便超越了Meta的12万张GPU模型。项目失败后,扎克伯格试图通过收购和高薪吸引人才,但内部斗争频繁,导致实验室混乱。

硅谷惊变:12万张H100的挽歌

宝玉的分享 宝玉的分享 · 2025-09-04T16:05:17Z
遥遥领先的华为升腾384超节点VS英伟达NVL72:FP16算力压H100却逊GB200,三倍功耗换自主可控值不值?

华为的升腾384超节点在算力上部分超越英伟达的NVL72,但在稳定性和兼容性方面仍存在不足。该设备采用自主架构,支持大模型训练,但光模块故障率高,可能导致训练不稳定。整体来看,升腾384为国内算力中心提供了新选择,推动自主可控的信创产业发展。

遥遥领先的华为升腾384超节点VS英伟达NVL72:FP16算力压H100却逊GB200,三倍功耗换自主可控值不值?

硕鼠的博客站 硕鼠的博客站 · 2025-07-29T00:57:08Z
马斯克重磅发布GROK4:史上最聪明AI大模型横空出世,强化学习碾压GPT-4与Claude,20万张H100显卡大力出奇迹,中美科技差距再度拉大,谁将主导AI未来?

GROK4是马斯克推出的最新AI大模型,具备强大的推理和生成能力,采用20万张显卡进行强化学习,显著提升科研效率。在“人类终极测试”中表现优异,超越其他模型。尽管日常任务处理能力一般,但在科研领域表现突出。未来将提供企业私有部署服务,市场竞争激烈。

马斯克重磅发布GROK4:史上最聪明AI大模型横空出世,强化学习碾压GPT-4与Claude,20万张H100显卡大力出奇迹,中美科技差距再度拉大,谁将主导AI未来?

硕鼠的博客站 硕鼠的博客站 · 2025-07-15T00:42:44Z

Tri Dao及其团队推出了QuACK内核库,完全用Python编写,利用CuTe-DSL,无需CUDA代码,在H100上实现33%-50%的加速,专注于内存密集型内核优化,提升GPU性能,受到业界关注。

无需CUDA代码给H100加速33%-50%,Flash Attention作者新作火了

量子位 量子位 · 2025-07-11T06:59:36Z

华为推出的CloudMatrix384架构旨在提升AI数据中心的算力效率,突破传统GPU集群的限制。该架构通过高带宽全对等互连和资源解耦,实现高效灵活的计算,支持动态资源调配,显著降低延迟并提升性能,为AI应用提供更优基础设施解决方案。

华为CloudMatrix重磅论文披露AI数据中心新范式,推理效率超 H100

量子位 量子位 · 2025-06-29T05:56:04Z

Meta发布Llama 4系列,包括Llama 4 Scout和Maverick,采用MoE架构,显著减少参数量,性能超越GPT-4.5。新模型支持百万上下文,具备多模态能力,运行成本低,标志着开源AI新时代。

LIama 4发布重夺开源第一!DeepSeek同等代码能力但参数减一半,一张H100就能跑,还有两万亿参数超大杯

量子位 量子位 · 2025-04-06T02:41:26Z
AMD的未来

AMD正在发送两台MI300X设备,显示其软件发展前景良好。与NVIDIA相比,AMD被低估,未来AI需求将推动其增长,MI300X有望超越H100。

AMD的未来

the singularity is nearer the singularity is nearer · 2025-03-08T08:00:00Z
新加坡”晶盾行动”打击GPU转运网络,DeepSeek的英伟达H100是怎么流入中国的?

新加坡近期实施“晶盾行动”,查获22个半导体贸易节点,拘留9名涉案人员,涉及伪造文件和走私英伟达芯片。新法案将加强对AI芯片的监管,要求严格验证终端用户,提升查验效率,可能影响全球GPU供应链,尤其是中国市场的芯片流入。

新加坡”晶盾行动”打击GPU转运网络,DeepSeek的英伟达H100是怎么流入中国的?

硕鼠的博客站 硕鼠的博客站 · 2025-03-03T00:50:16Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码