本文介绍在3台Ubuntu虚拟机(hadoop01、hadoop02、hadoop03)上搭建Hadoop 3.5.0全分布式集群,步骤包括安装虚拟机、配置主机名与固定IP、设置hosts映射、配置SSH无密码登录、下载安装Hadoop、配置PATH及workers、core-site.xml等5个文件、分发安装包、格式化NameNode并启动集群,最后运行MapReduce实例验证。
【版权声明】版权所有,请勿转载! 【相关文章推荐】《大数据软件安装和基础编程实践指南》,详细指导Virtual […]
本教程介绍在Ubuntu虚拟机上使用TRAE CN创建Java项目,编写MapReduce词频统计程序:以两个本地文本文件为输入并上传至HDFS,添加Hadoop 3.5.0相关JAR依赖,编译导出WordCount.jar并部署到Hadoop目录,最后提交作业统计单词出现次数,结果按单词排序输出到HDFS。
本文介绍在Ubuntu 24.04上安装配置HBase 2.6.7,前提是已安装Hadoop 3.5.0。安装步骤:下载解压HBase到/usr/local并重命名为hbase,赋予hadoop用户权限,配置PATH环境变量,用hbase version验证。伪分布式配置:编辑hbase-env.sh设置JAVA_HOME、HBASE_CLASSPATH和HBASE_MANAGES_ZK;编辑hbase-site.xml设置rootdir为HDFS路径、开启分布式模式并关闭stream capability检查。最后启动Hadoop与HBase,用jps验证进程,进入shell并停止。
厦门大学林子雨副教授推出Linux下大数据软件安装与编程教程,内容包括VMware安装Ubuntu、Hadoop单机与集群配置、HDFS与MapReduce编程,以及HBase、Milvus、Hive、Spark、Flink和Ollama数据智能体实践,配套《大数据技术原理与应用(第5版)》教材。
第28期大数据师资培训班将于2026年8月在泉州举行,旨在提升中国高校大数据课程的教学水平。培训内容包括课程知识体系、授课方法和实验环境搭建,帮助教师建立整体认识,促进大数据人才的培养。
本文总结了Hadoop 3.4.0至3.5.0对DataNode的优化,包括细粒度锁机制、性能提升、慢节点检测、动态重配置和监控增强。这些改进显著提高了HDFS的稳定性和可观测性,推荐在高并发和EC集群中进行升级。
本文详细比较了FileSystemRMStateStore、LeveldbRMStateStore和ZKRMStateStore,涵盖存储后端、架构类型、一致性模型、核心功能和HA支持等方面。三者各有优缺点,适用于不同场景,选择时需综合考虑基础设施和运维复杂度。
Hadoop 3.4.1相较于3.3.1版本,主要改进包括AWS SDK升级、ABFS增强、HDFS新特性及YARN改进,同时更新了安全性和依赖版本,移除了多个功能。升级时需注意依赖兼容性,特别是Protocol Buffers的重大变化。
优步工程团队改进了数据复制平台,日处理超过1PB数据,解决了快速增长的工作负载扩展挑战。HiveSync团队基于Hadoop的Distcp框架优化了多PB工作负载,提升了复制效率和可靠性,支持云迁移和数据湖模型。通过并行化任务和改进资源管理,HiveSync实现了300PB的增量复制,并计划将这些改进作为开源补丁贡献给社区。
现代人工智能依赖于传统基础设施,如Hadoop、Kafka和Elasticsearch等开源项目。这些项目虽然不是直接的AI应用,但为AI的发展提供了数据存储、处理和实时流转的基础支持。
ORC文件是一种为Hadoop设计的列式存储格式,适合大数据分析。使用Python的PyArrow库,可以高效读取、写入和处理ORC文件,支持压缩和索引,优化查询性能。
大数据技术通过采集、存储和分析海量数据,广泛应用于推荐系统、金融和医疗等领域。其特点包括数据量大、处理速度快、多样性、低价值密度和真实性。大数据技术起源于Google的GFS、MapReduce和BigTable,随后Hadoop和Spark等框架的出现推动了大数据生态的发展。
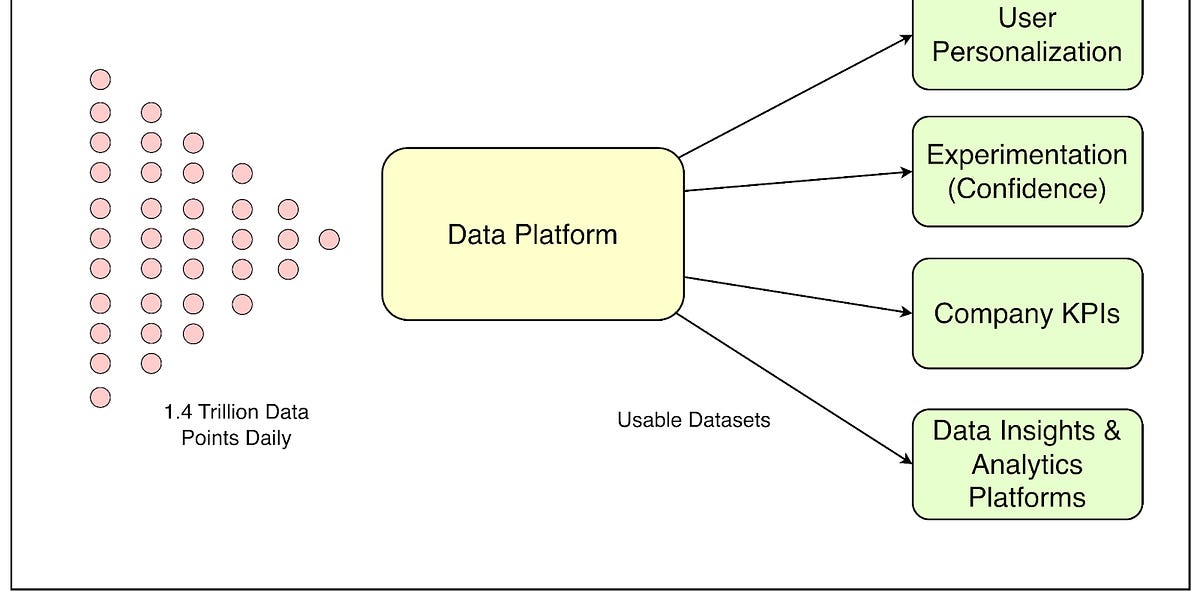
Spotify的数据平台从单一团队管理Hadoop集群演变为多产品团队,支持海量数据的收集、处理和管理,确保数据安全可靠,满足业务需求,促进产品实验与决策。
Pinterest推出了Hadoop控制中心(HCC),旨在自动化管理Hadoop集群的扩展和迁移,简化操作复杂性。HCC通过统一命令行接口实现实时调整,确保数据完整性和服务连续性,并计划增加自动修复和生命周期管理功能,以提升基础设施的自主性和弹性。
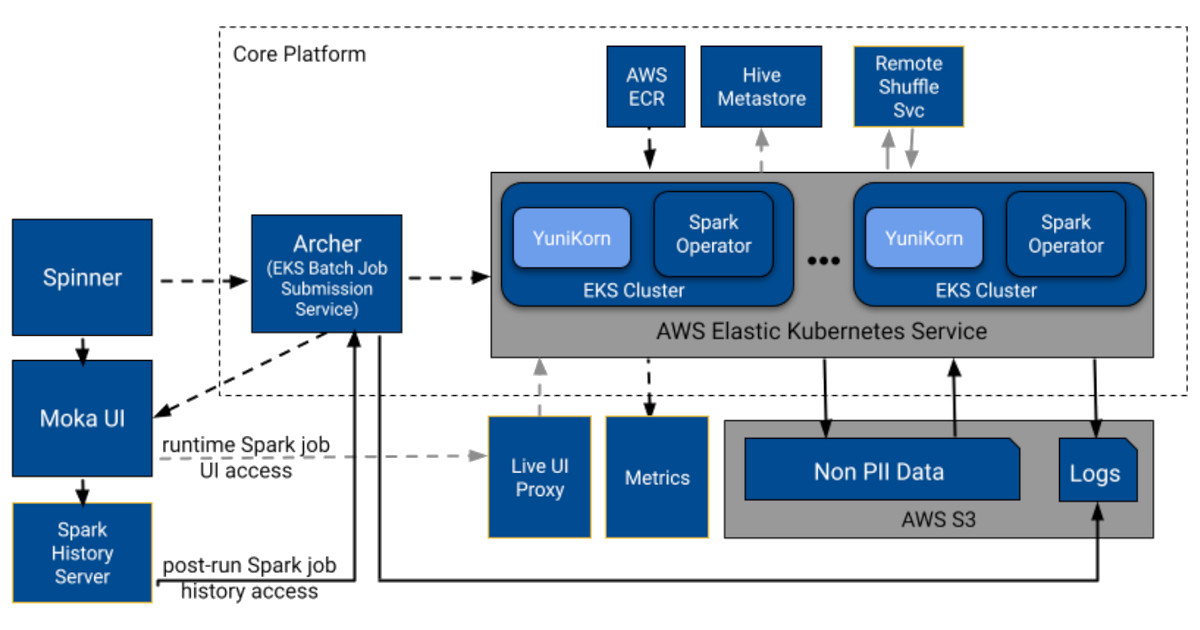
Pinterest将Hadoop数据平台替换为基于Kubernetes的Moka系统,运行Spark于AWS EKS。Moka支持容器化作业隔离和ARM实例,提升调度效率并降低基础设施成本。Pinterest还开发了新服务,使用Apache YuniKorn进行调度,迁移存储至S3,并整合Apache Celeborn以维持性能。Moka通过资源管理和动态优先级调度优化数据处理工作负载。
本文介绍了基于Spark和Python的B站数据处理与分析实验,包括环境搭建、Hadoop和Spark安装、数据采集及代码组织,强调了AI工具在编程中的应用。
Amazon EMR 是一个托管的大数据集群平台,支持 Apache Hadoop 和 Spark,简化数据分析管理。它提供灵活的定价和集群规模调整,确保数据安全,支持多种管理界面。用户可选择不同版本和节点类型,以优化性能和成本,并支持自动扩缩容,适应各种工作负载需求。
本文介绍了在Linux系统中安装Hadoop、HBase、Spark等大数据软件的步骤,并提供编程实践指南,内容与《大数据技术原理与应用(第4版,高职版)》教材相关。
大数据是推动创新和商业智能的重要资产,涉及无法用传统方法处理的大型数据集。其特点包括数据量大、生成速度快、格式多样、可信度高和价值显著。常用技术有Hadoop、Spark和Kafka,编程语言包括Python和Java。开发大数据应用需定义数据源、选择工具、进行数据预处理和分析,同时需关注数据质量、可扩展性和安全性挑战。
完成下面两步后,将自动完成登录并继续当前操作。