该页面为Percona博客文章列表,包含三篇内容:glibc变更破坏PostgreSQL集群的十种方式、用DBTrail与Percona Server实现MySQL秒级HTAP报表、在Percona Operator中执行PostgreSQL大版本升级。
该页面为Percona博客文章列表,包含三篇技术文章:OpenEverest MySQL集群的Galera健康检查与故障切换测试、基于DBTrail与Percona Server的MySQL HTAP快速报表方案,以及Percona Operator中PostgreSQL大版本升级实践。
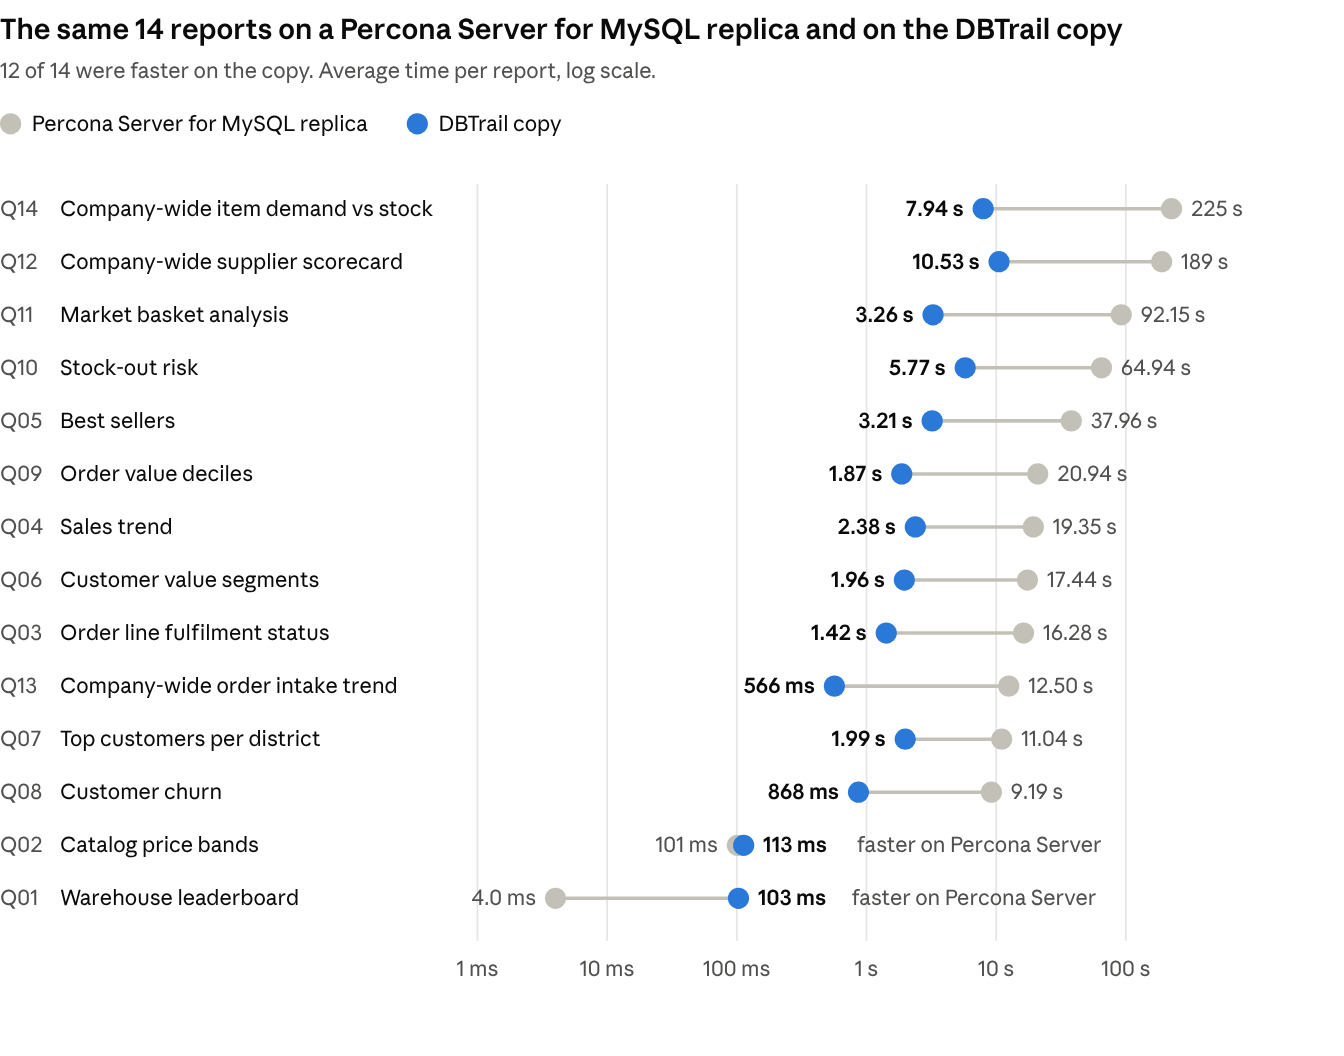
Percona博客文章列表汇总了2026年11月的多篇技术文章:Vadim Tkachenko介绍基于DBTrail与Percona Server for MySQL的开源HTAP方案,可在数秒内完成繁重的MySQL报表;Anil Joshi讲解在Percona Operator for PostgreSQL中执行PostgreSQL大版本升级;Ivan Groenewold对比MongoDB 9.0、8.0与8.3的初步性能表现。
本文介绍在Percona Operator for PostgreSQL中执行PostgreSQL大版本升级的实践,指出升级不仅是版本号变更,还涉及运行层面的注意事项;并提及MongoDB副本集内存不足时,采用分片之外的替代方案进行概念验证。
Awide Labs 开源了基于阿里 PolarDB 的 PostgreSQL 分支 Awide Polar,包含增强的 PolarFS 存储层和 Polar Proxy。它采用计算存储分离架构,主节点负责写入,只读副本共享同一数据文件,支持 HTAP。pgbench 读写测试中达到每秒超 15 万事务。主要改进包括:引擎内 WAL 流水线和 CSN MVCC 降低争用;PolarFS 用无锁队列和零拷贝 I/O,随机读写 IOPS 分别提升约 11 倍和 7 倍;代理实现一致性读;扩展 Patroni 高可用并移植 DataMax。
HTAP将事务处理与分析处理结合,使分析查询直接访问最新运营数据,无需ETL搬运。架构分为融合式(单引擎兼顾)和组合式(分离计算以隔离负载),核心挑战是平衡数据新鲜度与事务延迟。适用于实时风控、个性化等场景;若分析可容忍延迟,仍可保留独立OLAP系统。
OLTP处理高并发、低延迟的实时交易(如支付、订单),强调ACID一致性,多用行式存储和规范化模式。OLAP面向大规模历史数据分析,支持复杂查询与聚合,常用列式存储和星型模式。两者常并存,通过ETL、CDC、HTAP或LTAP连接。选择取决于写入一致性、历史扫描需求及数据新鲜度,混合架构适合两类需求并重的场景。
AlloyDB是Google基于PostgreSQL协议的企业级HTAP数据库,采用日志即数据库架构,将存储与计算分离。其列式存储引擎可大幅加速分析查询(如TPC-H Q6提速311倍),但VACUUM仍在计算节点运行。AlloyDB Omni是独立产品,仅含查询层功能。ScaNN向量索引体积小、构建快。适合GCP用户处理多TB数据或突发读取场景,但扩展兼容性和治理模式受限。
> 本文是写作规划,不是可发布正文。拆解对象:TiKV 7.x/8.x(Region / Multi-Raft / raftstore / MVCC key)为主线;PD 为调度与 TSO;TiFlash 以 Raft Learner 列存副本收束 HTAP;CockroachDB 作对照一篇,OceanBase 仅边…
本文介绍了TiDB集群的四个核心组件及其功能:TiDB负责SQL解析和请求路由,TiKV处理分布式事务和数据存储,PD管理元数据和调度,TiFlash提供列存分析副本。理解各组件的独立性和复杂性有助于排查性能问题。接下来将深入探讨TiKV的具体实现与机制。
TiKV 将 Percolator 的锁、数据和写入三列映射为 RocksDB 的 CF_LOCK、CF_DEFAULT 和 CF_WRITE。通过时间戳的位反转实现 Key 编码规则,确保查询时优先返回最新版本。TiKV 的 MVCC 时间戳由 PD 的 TSO 提供,确保跨 Region 的全局一致性,区别于 RocksDB 的单机快照机制。这三种 CF 共同维护同一逻辑数据,需联合管理。
TiKV 将集群数据视为全局有序的 Key-Value 大表,按 Key 切分为多个 Region。每个 Region 代表一个连续的 Key 区间,RegionEpoch 通过两个字段管理版本,确保请求有效性。每个 Region 由多个 Peer 组成 Raft 组,只有 Leader 处理读写请求。PD 负责均衡 Region 和 Leader 的分布,以提升容错能力和性能。
TiKV 采用 Multi-Raft 模型,每个 Region 独立维护 Raft 日志,支持高并发写入,解决了单 Raft 组的吞吐限制。跨 Region 事务的复杂度增加,需要额外协议保证原子性。TiKV 通过 raftstore 线程池管理状态机,优化性能,并引入 Hibernate Region 减少空闲状态开销,实现高效的分布式存储。
TiKV 的写请求经历四个阶段:propose、append、commit 和 apply。commit 阶段确保日志被多数副本持久化,但不代表数据已写入 RocksDB。apply 阶段负责实际写入。TiKV 通过异步设计提高性能,确保协议推进与状态机执行分离,优化写入效率。
TiKV 通过 Raft Snapshot 解决副本落后问题,允许副本直接从 Leader 同步,避免日志重放开销。日志 GC 定期清理不再需要的日志,确保副本正常追赶。TiKV 支持 Voter、Learner 和 Witness 三种副本形态,以提高系统容错能力和存储效率。
PD(Placement Driver)作为TiKV的调度中心,通过心跳机制收集集群状态,生成调度建议(Operator),并发送给Region Leader。调度过程异步,Leader可选择执行或跳过建议。PD使用Store心跳提供宏观视图,Region心跳提供精确位置。调度的基本单元是Operator,主要目标是负载均衡和副本管理,决策受限于放置规则和调度限制,以确保系统稳定性。
本文讨论了TiKV的动态分区策略,重点在于Region的分裂与合并机制。TiKV通过静态大小和key数量、负载(Load Base Split)两条管线判断何时分裂,分裂过程通过BatchSplit命令修改元数据,不涉及数据复制。合并需先对齐副本,经过PrepareMerge和CommitMerge两个阶段。PD的hot-region-scheduler与TiKV的Load Base Split相辅相成,解决热点问题。
本文讨论了TiDB中的时间戳分配服务TSO(Timestamp Oracle),其核心在于确保全局事务的严格顺序。TSO通过46位物理时间和18位逻辑计数器组合成64位时间戳,由PD leader负责分配,以确保单调性和故障恢复。通过批量请求机制,多个事务可以共享一次网络往返,从而降低延迟。
本文探讨了TiKV如何实现Percolator论文中的data/lock/write模型,分析了TiKV在编码、Prewrite/Commit过程中的调整,包括Rollback记录、短值优化和Lock类型写记录。TiKV将Prewrite的原子性单位从单行事务改为Region的Raft提交,并通过Async Commit和1PC优化减少延迟,满足在线事务的性能需求,展示了TiKV在生产环境中的应用与论文模型的差异。
TiKV 的悲观锁默认使用内存路径以减少加锁延迟,但在非计划的 Leader 切换时可能会丢失锁。锁的 TTL 动态调整,长事务依赖心跳续期。死锁检测采用集中式方案,Leader 切换时清空历史依赖,存在漏检风险。TiKV 的锁机制与传统数据库相似,需纠正对其“无锁”的误解。
完成下面两步后,将自动完成登录并继续当前操作。