
Fireworks于9月23日发布研究预览版Ember-1,基于Kimi K3构建,宣称用约少40%的token达到同等质量。实测三轮任务中,Ember-1准确率与Kimi K3几乎持平(15次中14次正确),推理token少23%,速度快3.4倍,Fireworks上总成本低24%。但Kimi K3可经其他供应商以更低价格调用,反而更便宜。
Fireworks 在 AI Gateway 上线研究预览模型 Ember-1,基于 Kimi K3,面向编程与智能体工作流。其生成 token 比 Kimi K3 少约 40%,质量相当,可降低输出成本与上下文负担。支持 100 万 token 上下文、文本图像输入、工具调用和隐式提示缓存,端点支持零数据保留与不训练提示,预览期两周。
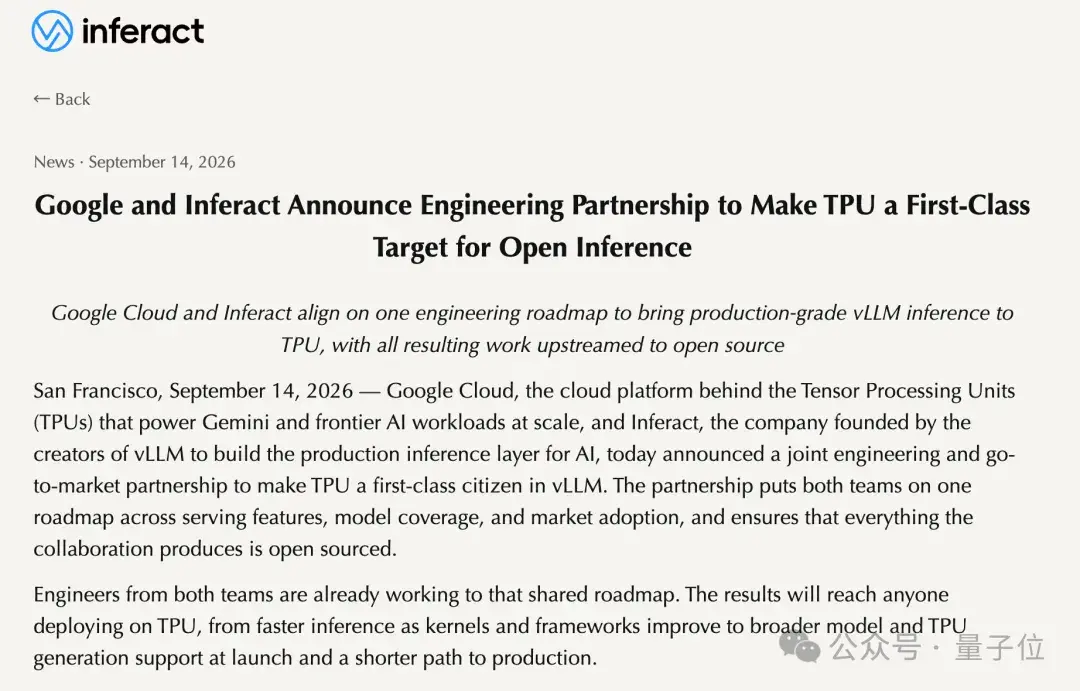
Inferact团队为谷歌TPU v7开发megakernel推理内核,将数百个小程序合并为一个大程序,消除调度间隙并实现跨层权重预取。16块TPU运行Kimi K3达每秒709 token,比GB200快57%,且精度无损。该团队源自vLLM,获a16z领投1.5亿美元融资,代码已开源。
浪潮信息在AICC2026发布元脑SD200 Ultra超节点AI服务器,基于本土AI芯片,单机可运行2.8万亿参数Kimi K3大模型,Token生成时延低至5.85毫秒,支持10万亿参数模型,推理性能提升3倍以上。同时发布元脑HC2000多元算力机组,同等投资下Token产能提升10倍。
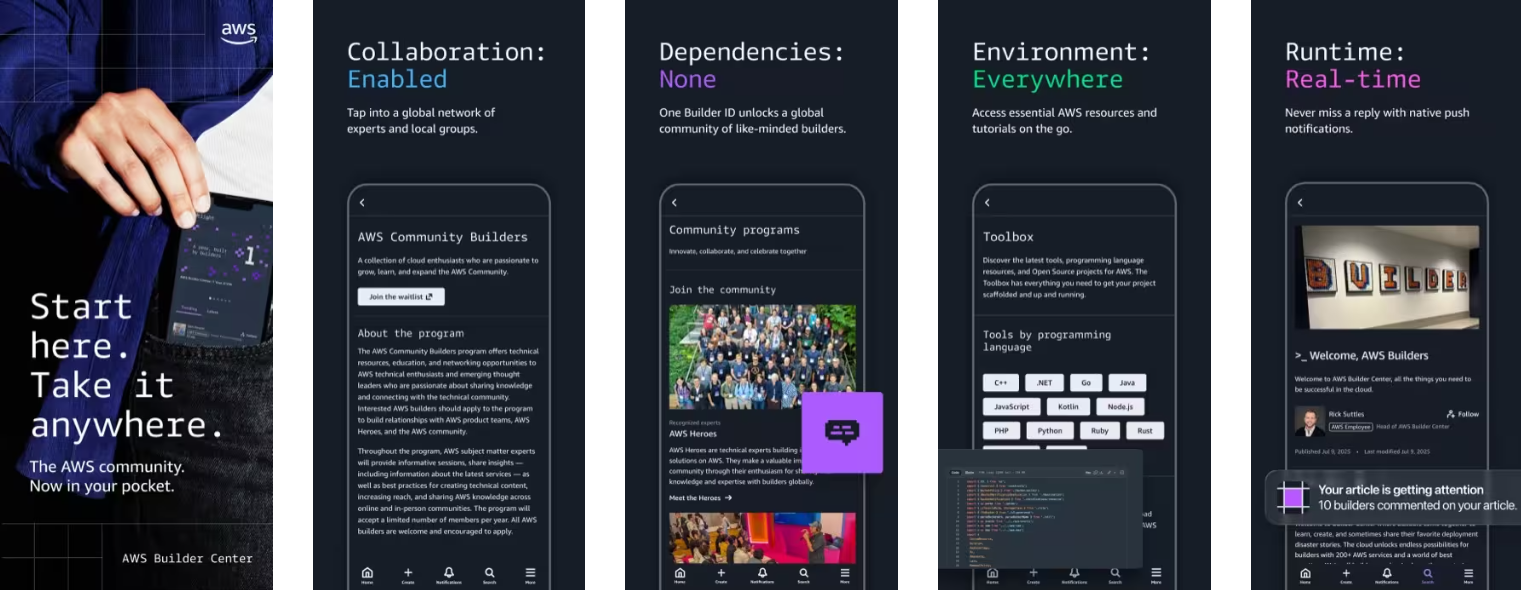
AWS发布Builder Center移动应用(iOS/Android),可浏览文章、课程与工作坊;Amazon Connect Talent正式发布,提供AI语音面试与评测;Amazon Corretto 27发布,支持至2027年4月;Kimi K3上线Bedrock;AWS推出T8i实例、Elastic Beanstalk集群模式及AgentCore新运行时,简化入门体验。
Kimi K3于9月18日上线Amazon Bedrock,2.8万亿参数模型可通过托管API调用,降低了部署门槛,但长上下文成本与治理门槛仍存。模型支持百万Token、视觉、工具调用及提示缓存;缓存适合复用稳定前缀,需监控命中率。开放权重不等于可自行运行,迁移需验证接口语义。建议先通过API验证,再决定自建,并以每成功任务成本评估。
Amazon Bedrock 上线 Moonshot AI 的 Kimi K3 开放权重模型,参数量 2.8 万亿,支持原生视觉与 100 万 Token 上下文,适用于长周期编程和知识工作。该模型是 Bedrock 首个支持显式提示词缓存的开放权重模型,可降低延迟和输入成本。数据在 AWS 边界内处理,不共享给模型提供商,并启用零数据留存和零运维访问。用户可通过控制台或 API 调用,支持全局和美国区域配置文件。
本文介绍Kimi K3模型在1M上下文强化学习与线上服务中的系统设计,核心是状态管理。KV块和KDA状态通过write-back策略在GPU与DRAM池间迁移,训练态让位NVMe,参考模型权重借梯度缓冲槽位流入GPU,沙箱支持pause/fork/snapshot,集群调度采用缓存亲和与预算准入,确保资源高效利用。
本文详解Kimi K3模型训练中的显存优化策略,通过账本形式分析权重、激活等内存占用,并介绍六项关键技术:均衡PP rank激活、统一激活管理器、MoE反向改写、AttnRes块复用、Pipeline ZeRO-2及P2P Muon,以显存换效率,实现2.8T参数的高效训练。
本文介绍Kimi K3模型预训练的并行系统设计,聚焦MoE层expert并行。核心是MoonEP方案:每个rank预留E/R个冗余expert槽位,确保任意router输出都能使各rank计算完全平衡,消除负载不均和动态shape问题。同时用感知负载的GEMM调度解决rank内偏斜,并将视觉编码器计算塞入流水线气泡,减少等待开销。
本文总结Kimi K3模型结构对训练与推理系统的影响。KDA采用三种执行形态(FlashKDA、设备内上下文并行、状态回滚)处理固定大小状态;上下文并行通过可结合前缀扫描分解,避免直接加和;Block AttnRes优化内存通信;Stable LatentMoE融合GEMM与token中心解码;混合架构前缀缓存解耦粒度,支持512-token边界复用;视觉编码器动态并行并填充流水线气泡。核心是将固定权重累加转为数据相关选择。
Kimi K3模型采用从零训练的MoonViT-V2视觉编码器,27层、patch14结构,支持高分辨率图像token化;MTP层预训练后微调为EAGLE-3投机解码draft模型;Per-Head Muon优化器按头正交化动量矩阵,提升训练稳定性。词表大小163840,采用稠密层设计,强调结构选择对系统设计的影响。
Kimi K3模型采用Stable LatentMoE作为FFN,基于NVIDIA LatentMoE改进,将输入压缩至半宽latent空间,增加RMSNorm稳定训练,用SiTU-GLU激活控制输出,并通过Quantile Balancing实现负载均衡。该模块占模型98%参数,每层激活16个专家,显著提升效率与性能。
本文介绍Kimi K3模型结构:采用3:1混合,每四层含一层Gated MLA(无位置编码、满秩sigmoid门),其余为KDA层。MLA低秩压缩KV至576维/token,KDA状态固定约232MB。3:1比例经实验选为质量与吞吐平衡点,1M上下文时KV cache约27.6GB,decode速度约为纯MLA的2.2倍。
本文介绍Kimi K3模型序列维度的chunkwise并行算法:将序列分块,块间递推状态、块内用矩阵乘并行计算。K3将每步log-decay加−5下界,使16-token对角tile也能用BF16矩阵乘,消除FP32逐位置对瓶颈。相比通用DPLR内核,KDA内核因结构简化速度快约一倍。训练和prefill用chunkwise形式,decode用递推形式。
本文介绍Kimi K3模型中KDA(Kimi Delta Attention)的递推形式,从线性注意力、DeltaNet到Gated DeltaNet演进而来。KDA通过逐通道衰减和擦除写入机制更新状态,每头128×128矩阵,不依赖上下文长度。它采用逐头RMSNorm和满秩sigmoid输出门,在合成任务中表现优于基线,并天然具备位置编码能力。
本文解析Kimi K3模型中的Attention Residuals(注意力残差)结构。该机制将残差连接视为深度方向上的RNN,通过可学习伪query对embedding及各层输出做softmax加权,替代固定求和。K3采用Block形式,将93层分为8块,块内普通求和,块间注意力聚合,共9个来源。相比普通残差,此设计提升多步推理能力,降低输出幅度增长,并支持高效两阶段推理。
Kimi K3是2.78T参数、104.2B激活的93层MoE模型,支持1M上下文及图像视频输入。其结构创新分三方面:序列用KDA与Gated MLA混合,深度引入Attention Residuals,宽度采用Stable LatentMoE,并配视觉编码器MoonViT-V2。相比K2,扩展效率提升约2.5倍。文章详解层排布、维度配置及前向流程,为后续技术解读奠定基础。
《Python潮流周刊》第166期发布,主题为“拆解Kimi K3的登顶之路”。本期精选12篇文章和12个开源项目,涵盖Django调查、依赖管理、OpenAI SDK迁移HTTPX2、Polars 2.0等,项目包括PDF翻译、多智能体协作、A股投研框架等。周刊实行付费订阅制,年费148元,旨在帮助读者精进Python技术。
Kimi K3采用Stable LatentMoE架构,拥有2.8万亿参数,但每个token仅激活约1040亿。其每层有896个专家,仅选16个处理。该设计通过压缩路由路径、RMSNorm稳定输出、SiTU-GLU限制激活值及分位数平衡路由,解决了大规模稀疏模型的训练稳定性和计算成本问题。
完成下面两步后,将自动完成登录并继续当前操作。