
谷歌TPU跑Kimi比英伟达GPU快57%!用的还是DeepSeek推理框架
内容提要
Inferact团队为谷歌TPU v7开发megakernel推理内核,将数百个小程序合并为一个大程序,消除调度间隙并实现跨层权重预取。16块TPU运行Kimi K3达每秒709 token,比GB200快57%,且精度无损。该团队源自vLLM,获a16z领投1.5亿美元融资,代码已开源。
延伸解读
软件优化如何逆转硬件劣势
测试中,TPU v7的HBM带宽为7380 GB/s,低于GB200的8000 GB/s,但TPU却实现了57%的推理速度领先。这表明在特定负载下,软件层对内存带宽的利用效率可能比峰值带宽更重要。Inferact通过megakernel将数百个内核合并,消除了调度间隙,并利用TPU的片上内存实现跨层预取,使带宽利用率接近理论峰值。这提醒读者,评估AI芯片时不能只看硬件规格,软件生态和优化程度同样关键。
Megakernel的技术突破与局限
Megakernel的核心是将整个模型前向传播塞进一个Pallas程序,一次调用完成,从而消除内核边界和调度开销。它利用TPU每个TensorCore的64 MiB VMEM,由软件精确控制数据搬运,实现计算与预取重叠。但当前方案是针对Kimi K3的92层MoE结构定制,换模型需重新适配。团队计划扩展支持更多架构。这说明该优化目前通用性有限,但展示了软硬协同设计的潜力。
推测解码的加速贡献
TPU达到的709 token/s中,DeepSeek提出的DSpark推测解码框架功不可没。它让小模型先猜一串候选token,大模型批量验证,平均每轮有6个token直接通过,单步解码耗时约8.5毫秒。关闭推测解码后,TPU在batch size为1时仍以249 token/s领先GB200的127 token/s。这表明加速既来自megakernel对底层效率的提升,也来自算法层的推测解码,两者结合放大了优势。
团队背景与开源影响
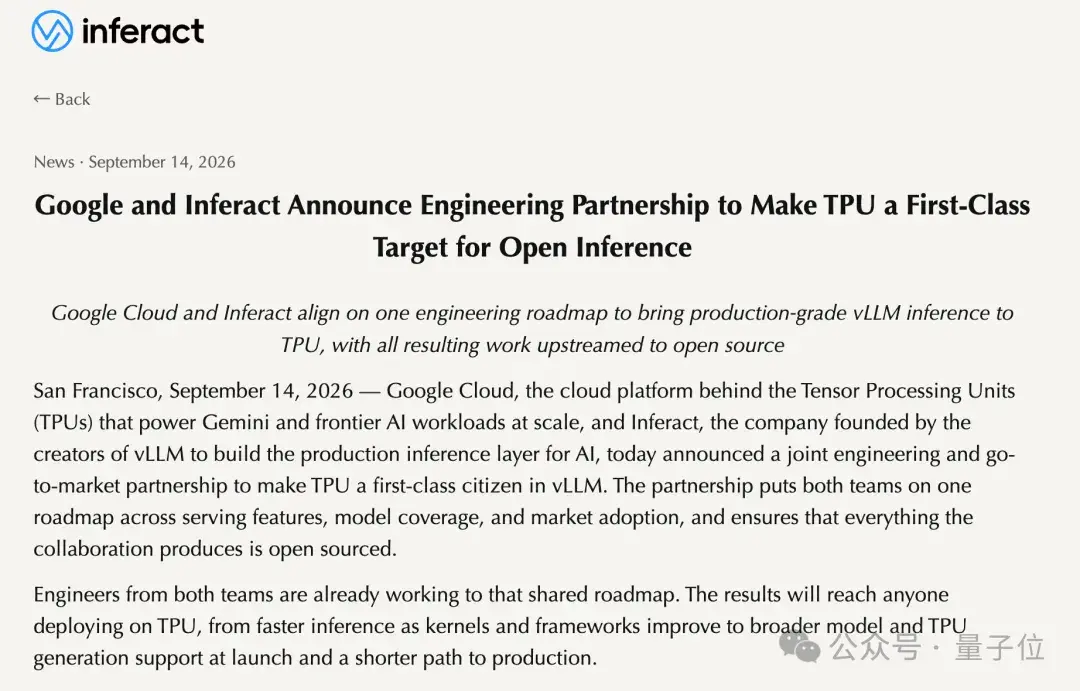
Inferact团队源自vLLM原班人马,CEO Simon Mo和联合创始人Woosuk Kwon均为vLLM核心开发者,Kwon提出的PagedAttention是vLLM的关键技术。公司今年获a16z领投的1.5亿美元种子轮,估值8亿美元。此次与Google Cloud合作开发的TPU megakernel代码已开源,旨在让TPU成为vLLM的一流支持对象。这有助于推动TPU在开源推理生态中的采用,并可能影响未来AI芯片竞争格局。
Q&A
Inferact是什么公司?团队背景如何?
Inferact是一家推理创业公司,创始团队来自vLLM原班人马,去年11月成立。CEO Simon Mo是vLLM原始维护者,联合创始人Woosuk Kwon是vLLM项目发起人,首席科学家游凯超曾获清华特等奖学金。公司今年完成1.5亿美元种子轮融资,估值8亿美元,由a16z和Lightspeed领投。
TPU跑Kimi K3比英伟达GB200快多少?具体测试数据如何?
在16块TPU v7 Ironwood对阵16块英伟达GB200的测试中,双方都跑Kimi K3并使用vLLM推理引擎,TPU达到每秒709个token,GB200为每秒452个,TPU快57%。关闭推测解码后,batch size为1时TPU每秒249 token,GB200为127;batch size为8时TPU为865,GB200为636。在Qwen模型上差距更大,4块TPU v7跑Qwen 3.8 27B达到每秒1515 token,GB200仅695。
megakernel是什么?它如何提升TPU推理效率?
megakernel是Inferact为TPU开发的推理内核,核心思路是将模型推理时原本要调度的几百个独立小程序合并成一个大程序,消除kernel切换时的带宽浪费。它把Kimi K3的92层MoE计算逻辑塞进一个Pallas程序,一次调用完成整个前向传播,并实现跨层权重预取,让计算和数据搬运同时进行,从而将内存带宽利用率逼到硬件理论峰值附近。
为什么TPU在推理速度上能超过HBM带宽更高的GB200?
虽然TPU v7的HBM带宽为7380 GB/s,低于GB200的8000 GB/s,但速度差距主要来自软件层。TPU的每个TensorCore带有64 MiB的VMEM片上内存,生命周期完全由软件管理,便于精确控制数据搬运和跨层预取。而GPU的片上内存分散在152个SM中,总量约38 MiB,由硬件自动调度,难以实现类似的跨层编排。Inferact通过手写megakernel充分利用了TPU的硬件特性。
DSpark推测解码框架在测试中起到了什么作用?
DSpark是DeepSeek提出的推理加速框架,原理是让一个小模型先快速猜出一串候选token,然后大模型批量验证,猜对的直接跳过,猜错的回退重来。在TPU上跑通后,acceptance length达到6,即每轮平均有6个token能直接通过验证,单步decode耗时约8.5毫秒。这为TPU的高吞吐量做出了贡献。
Inferact的megakernel方案目前有哪些局限性?未来计划如何?
目前megakernel是针对Kimi K3的模型结构做的定制优化,如果换一个模型架构还需要重新适配。Inferact在博客中提到,团队接下来会把megakernel的支持扩展到更多模型架构上。此外,该方案是Inferact与Google Cloud联合工程合作的一部分,目标让TPU成为vLLM的一流支持对象,优化成果会回馈开源社区。
