对比vLLM与TensorFold:TensorFold单流解码速度为vLLM的130%~180%,但Prefill性能仅为后者的1/3~1/2,显存占用更高,上下文长度更短(128GB下265K对900K)。低上下文、低Prefill需求宜选TensorFold;长上下文、高Prefill及多并发场景宜选vLLM。
vLLM-Omni流式TTS需区分首包延迟(TTFP)与端到端时间。官方在H200并发1下测得,异步分块加流式使TTFP从733ms降至64ms,但端到端升至941ms。优化应按场景选目标:互动产品保TTFP与连续播放,离线产品保RTF与成本,并关注分片大小、协议完整性与内容质量。
vLLM 推出硬件无关模型层,采用双轨架构:热门模型走硬件专用路径以提升性能,长尾模型和非主流加速器保留通用可编译路径。官方称在 H100 上三种模型吞吐差距不超过 3.4%。建议建立模型—硬件兼容矩阵,用真实流量验收正确性、吞吐、P99 和显存,并锁定提交版本。
vLLM 是加速大语言模型推理的框架,通过近乎零浪费的 KV 缓存解决内存管理瓶颈。本文提供离线推理教程,演示 Florence-2、Mllama、Whisper 三个多模态模型的隐式与显式提示用法,包含完整代码示例,并统计生成耗时与 RPS。
用户测试了专为Qwen优化的推理框架Ninfer,并与优化后的vLLM对比。在Qwen 3.8 27B、开启CUDA Graph下,vLLM的Decode和Prefill性能全面超越Ninfer,解码最高63.34 TPS,Prefill最高3230 TPS,TTFT低至0.15秒。多数场景vLLM更快,250K Prefill和TTFT领先达54.5%。优化后单流解码提升8.6%~14.5%,并发吞吐提升约15.6%。
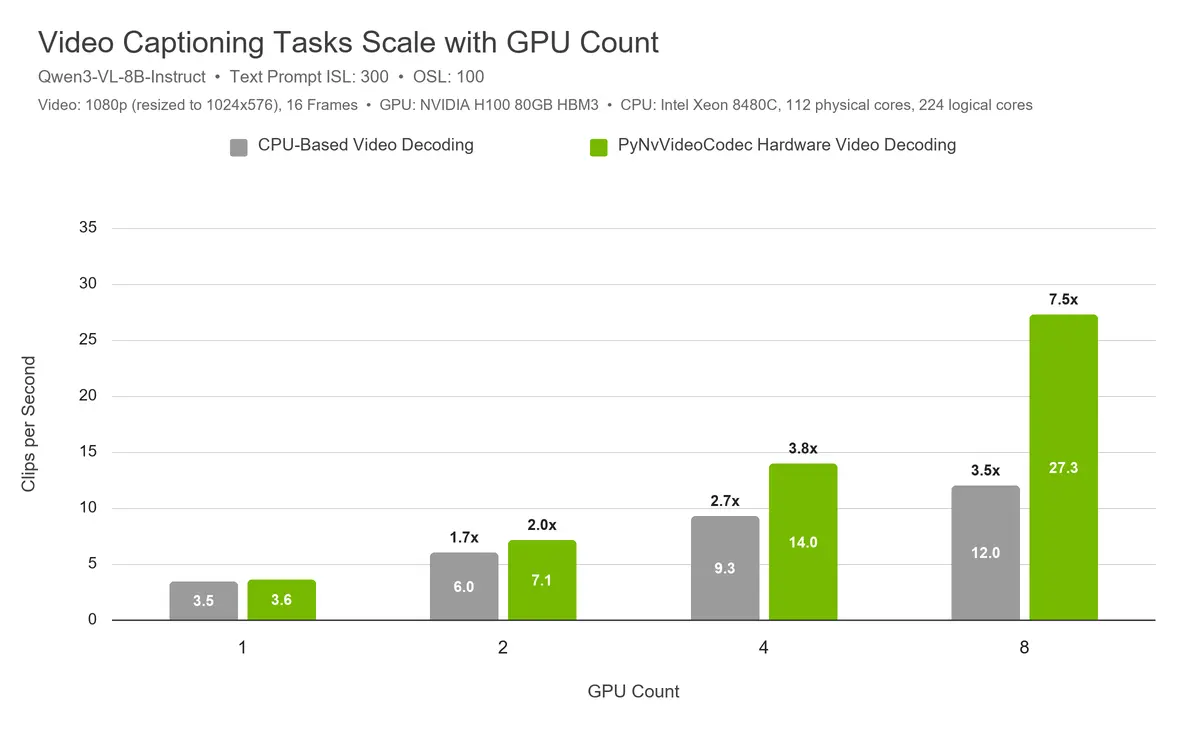
vLLM 通过集成 PyNvVideoCodec 正式支持 NVIDIA GPU 硬件视频解码(NVDEC),将视频解码从 CPU 迁移至 GPU,解决视频描述任务的 CPU 瓶颈。在 8 块 H100 配置下,吞吐量达 CPU 解码两倍以上;此前不足 4 卡即受制于 CPU,现瓶颈消除。该功能随标准 CUDA 版 vLLM 提供,需安装 PyNvVideoCodec==2.0.4,并建议先启动 CUDA MPS 守护进程。
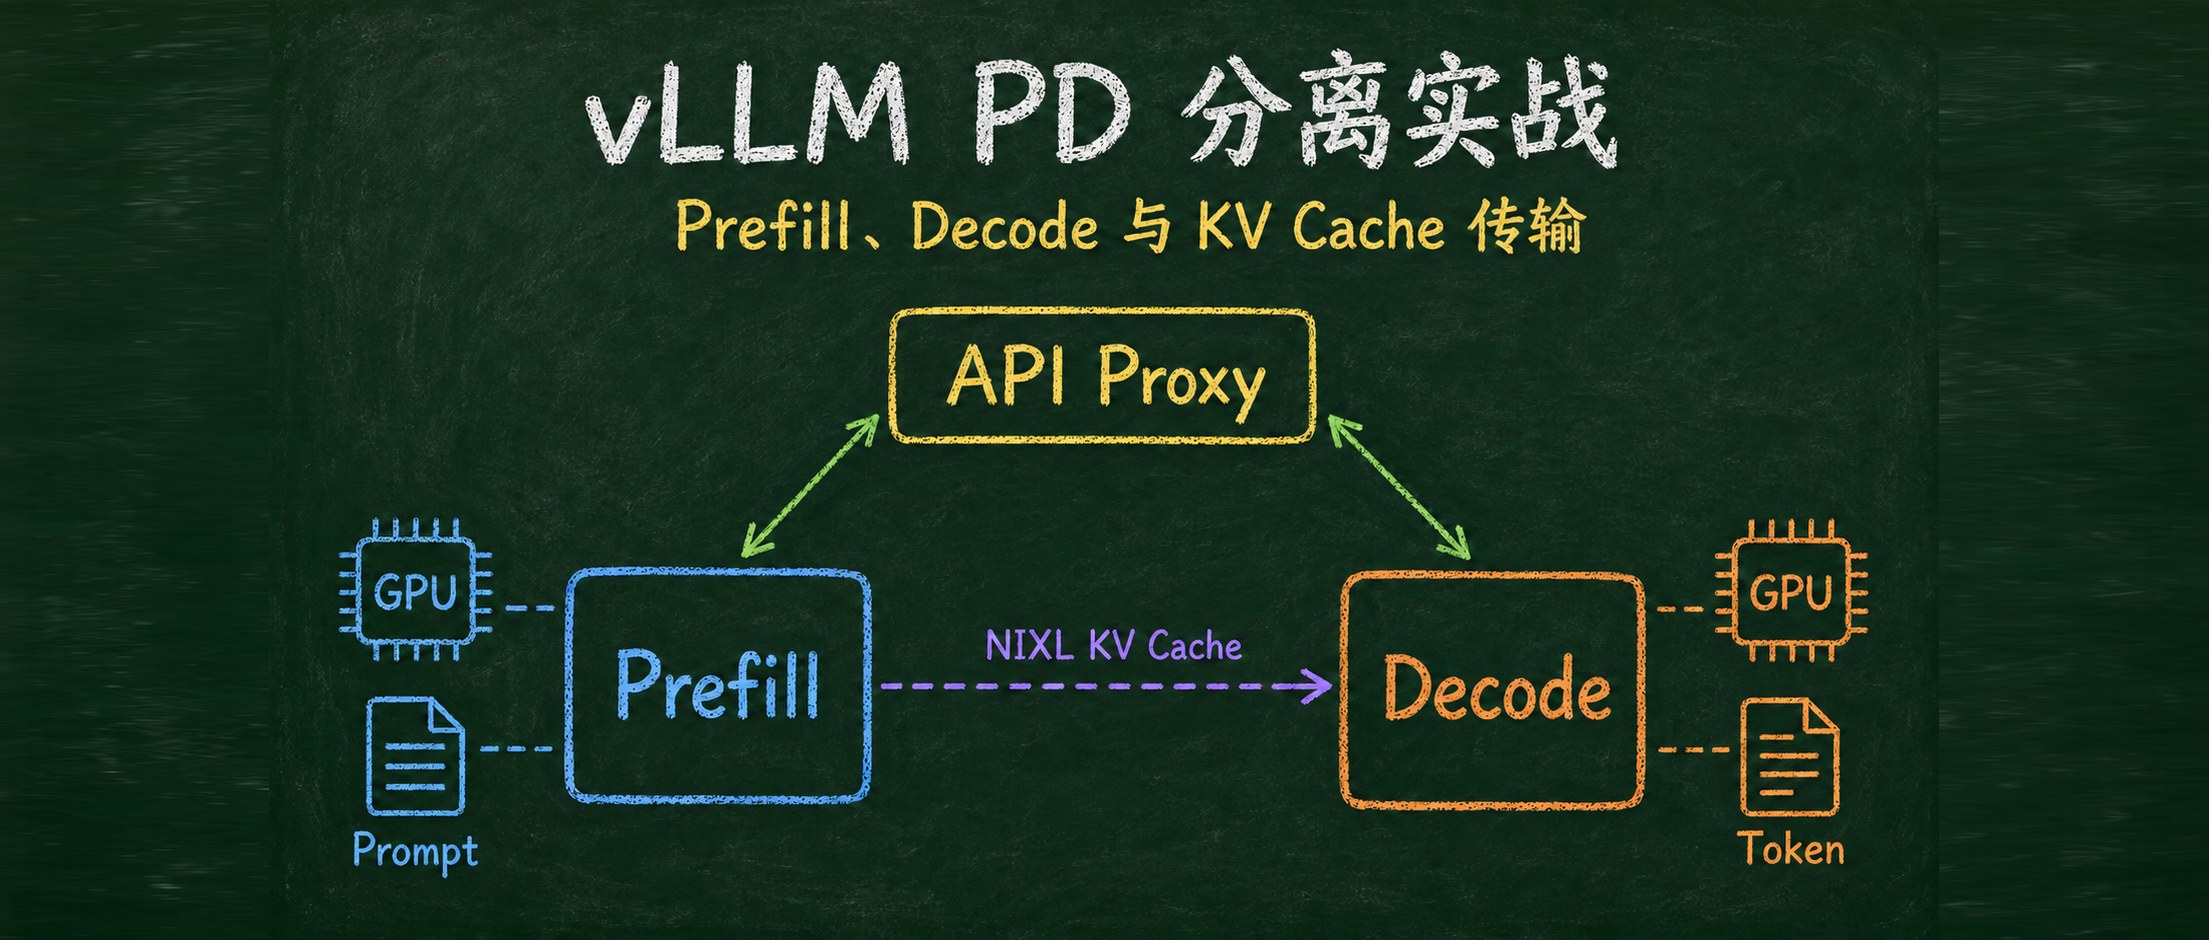
本文介绍如何用 vLLM、NixlConnector 和 toy Proxy 搭建单容器 PD 分离 Demo:Proxy 将请求改写为 max_tokens=1 发给 Prefill,Prefill 计算 Prompt 并生成 KV Cache,返回临时 Token 和传输元数据;Proxy 丢弃 Token,携带 kv_transfer_params 转发给 Decode;Decode 通过 NIXL 从 Prefill 拉取 KV Cache 并继续生成,结果经 Proxy 返回客户端。日志中 Num successful transfers=1 可确认传输成功。
vLLM 是加速大语言模型推理的框架,实现KV缓存零浪费。文章提供Helm图表部署配置及EAGLE投机解码示例,通过离线推理脚本展示如何用vLLM加载模型、设置采样参数并计算平均接受token长度,以优化推理性能。
vLLM的并行限制源于注意力头数需被TP大小整除,而非固定1/2/4/8卡;llama.cpp采用层切分,通信量小,卡数影响不大,关键在互联类型。TensorSharp引擎同时支持层切分和张量并行,3卡跑744B模型性能超llama.cpp,但TP对互联敏感,2卡仅提升1.4倍。核心结论:层切分对卡数免疫,TP对互联敏感。
vLLM部署Qwen 3.8 27B时,默认参数限制了图片和视频输入,导致报错。通过删除`--limit-mm-per-prompt.image 2`和`--limit-mm-per-prompt.video 0`并重启Docker,问题得到解决,模型恢复正常。
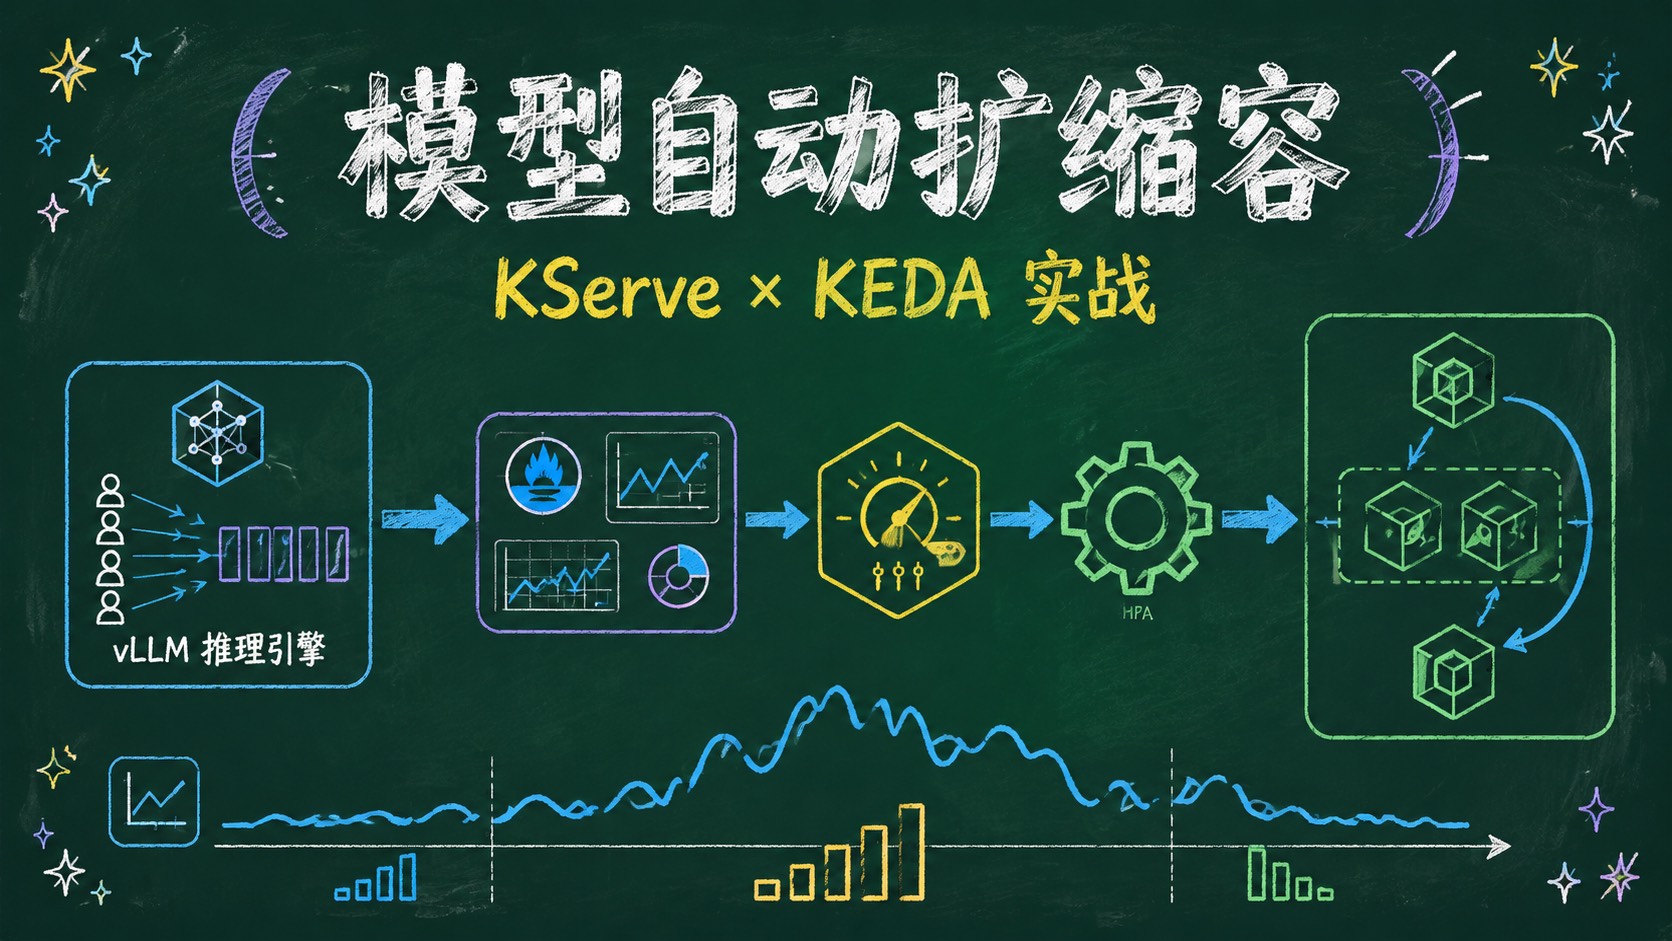
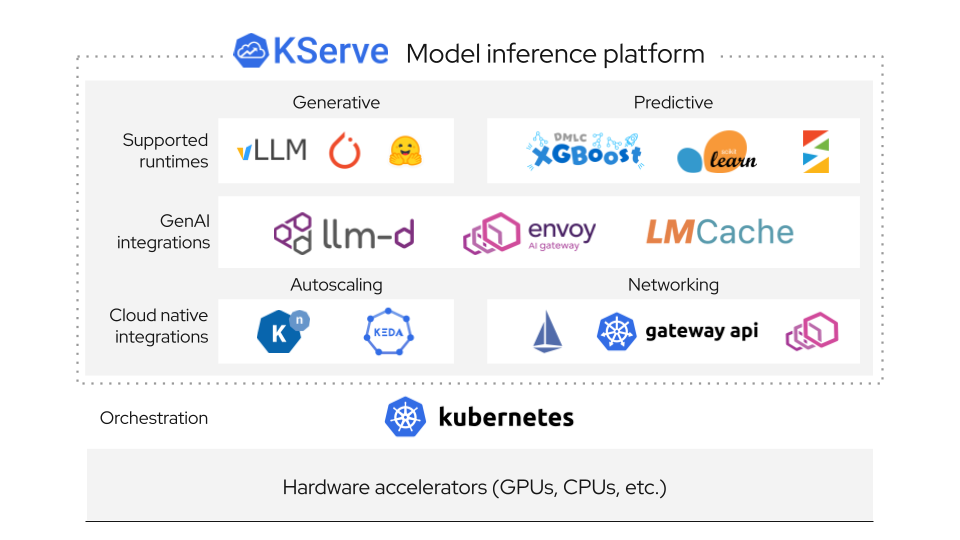
本文介绍如何为KServe模型服务接入KEDA,实现基于vLLM指标的自动扩缩容。通过安装KEDA和Prometheus,配置InferenceService和ServiceMonitor,利用vLLM暴露的请求指标,KEDA查询Prometheus数据并驱动HPA调整副本数。实测验证了服务从1个副本扩至2个再缩回1个的完整流程,有效平衡突发请求与资源利用率。
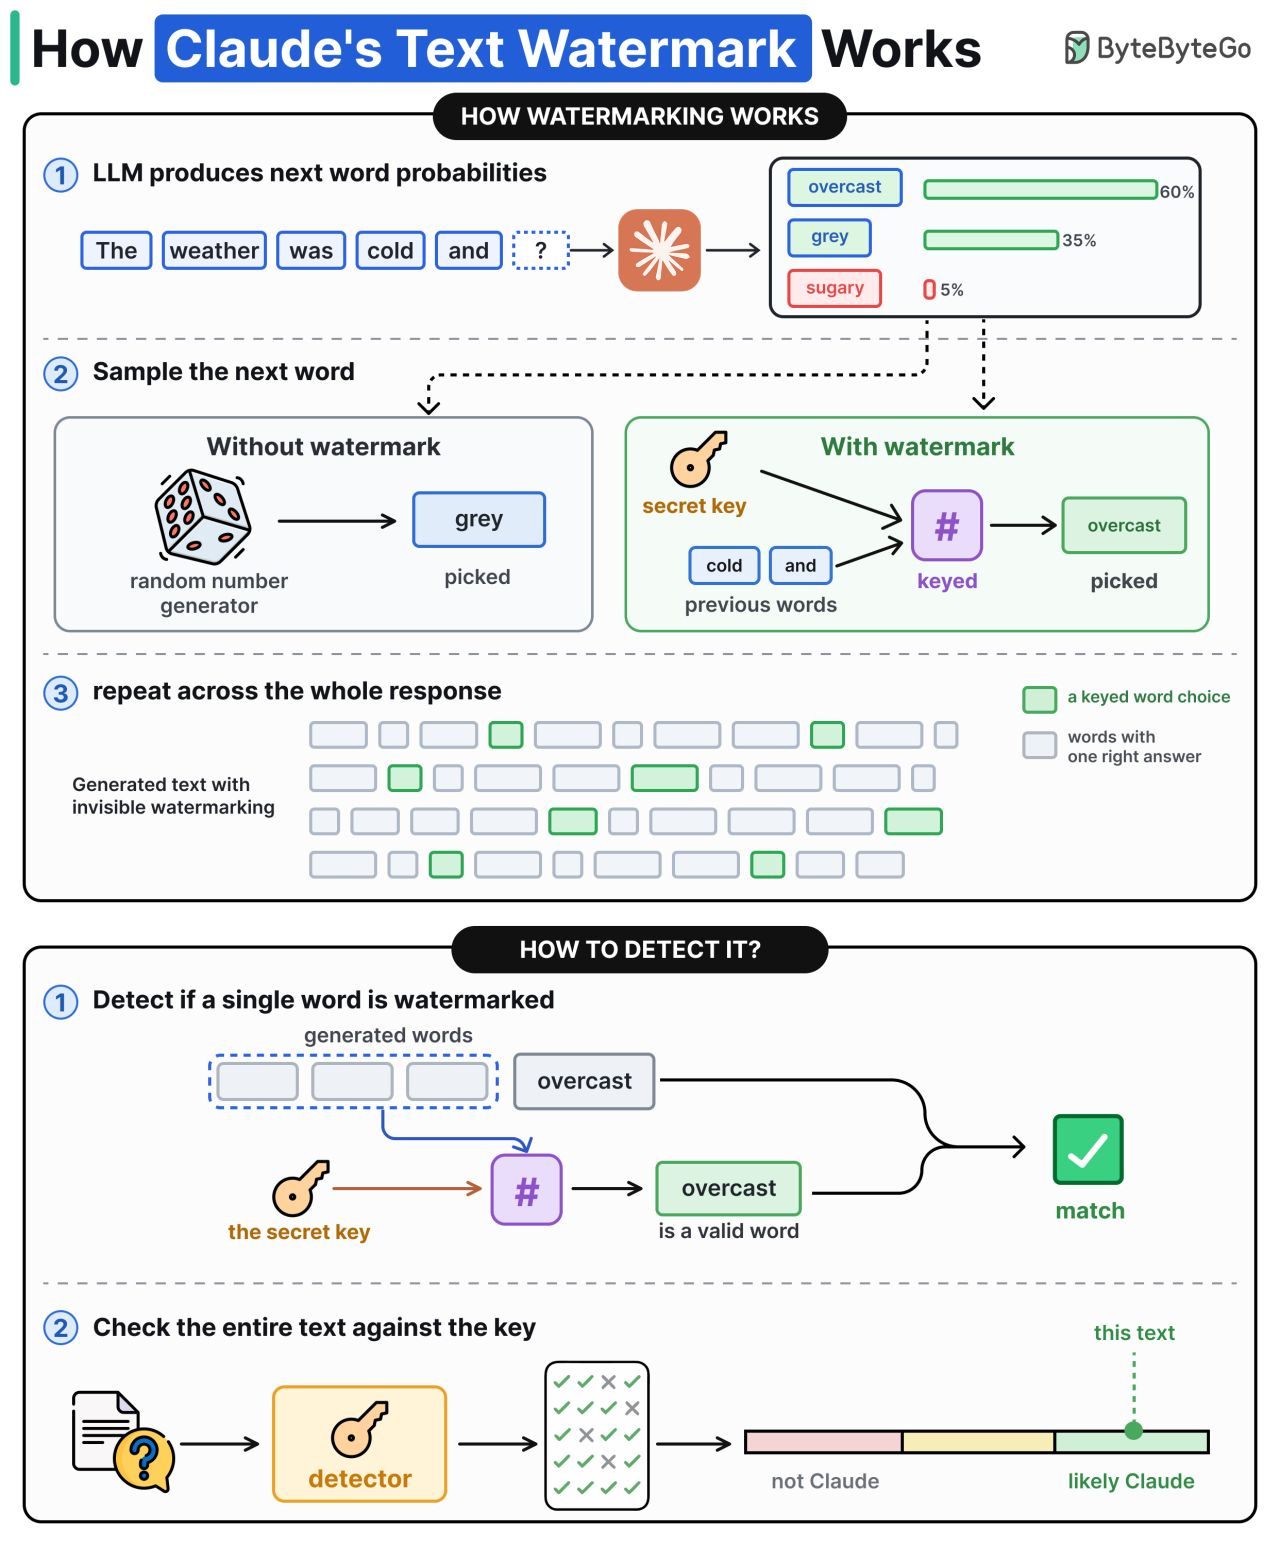
本文对比了三种开源模型推理引擎:Ollama适合本地开发,vLLM适合高并发服务,SGLang适合多轮对话和智能体场景。此外,简述了Claude文本水印技术原理、Git常用命令、Kafka与RabbitMQ的区别,以及12个热门Agent技能仓库。
本文介绍vLLM框架及其Helm图表部署方法,并展示一个使用Ray Data进行多节点分布式离线批处理推理的Python示例。示例通过LLMPredictor类调用Llama-2模型,配置采样参数、张量并行和实例数,从S3读取文本数据,批量生成文本并输出结果。
本教程介绍如何使用vLLM扩展AI代理的LLM推理。文章解释了LLM推理的预填充和解码阶段,以及AI代理工作负载为何难以服务。vLLM通过连续批处理、PagedAttention和前缀缓存优化并发推理。教程演示了在本地安装vLLM、启动服务器,并通过OpenAI兼容API连接AI代理的步骤,最后讨论了这些优化技术的重要性及适用场景。
自托管推理服务器的选择取决于工作负载类型,而非仅看吞吐量或显卡。单模型方案(如vLLM、SGLang)性能最优,但多模型运维成本高;多模型方案(如LocalAI、SIE)省心但单模型性能有妥协。实际生产常需混合使用:vLLM或SGLang处理大模型,SIE管理小模型集群,TEI负责嵌入与重排,Ollama适合开发原型。
vLLM 是加速大语言模型推理的框架,通过高效KV缓存管理减少内存浪费。文章提供Helm图表部署配置,并演示解耦预填充示例:启动预填充和解码两个实例,通过代理服务器传输KV缓存,实现请求处理,包含安装依赖、启动服务及测试请求的完整流程。
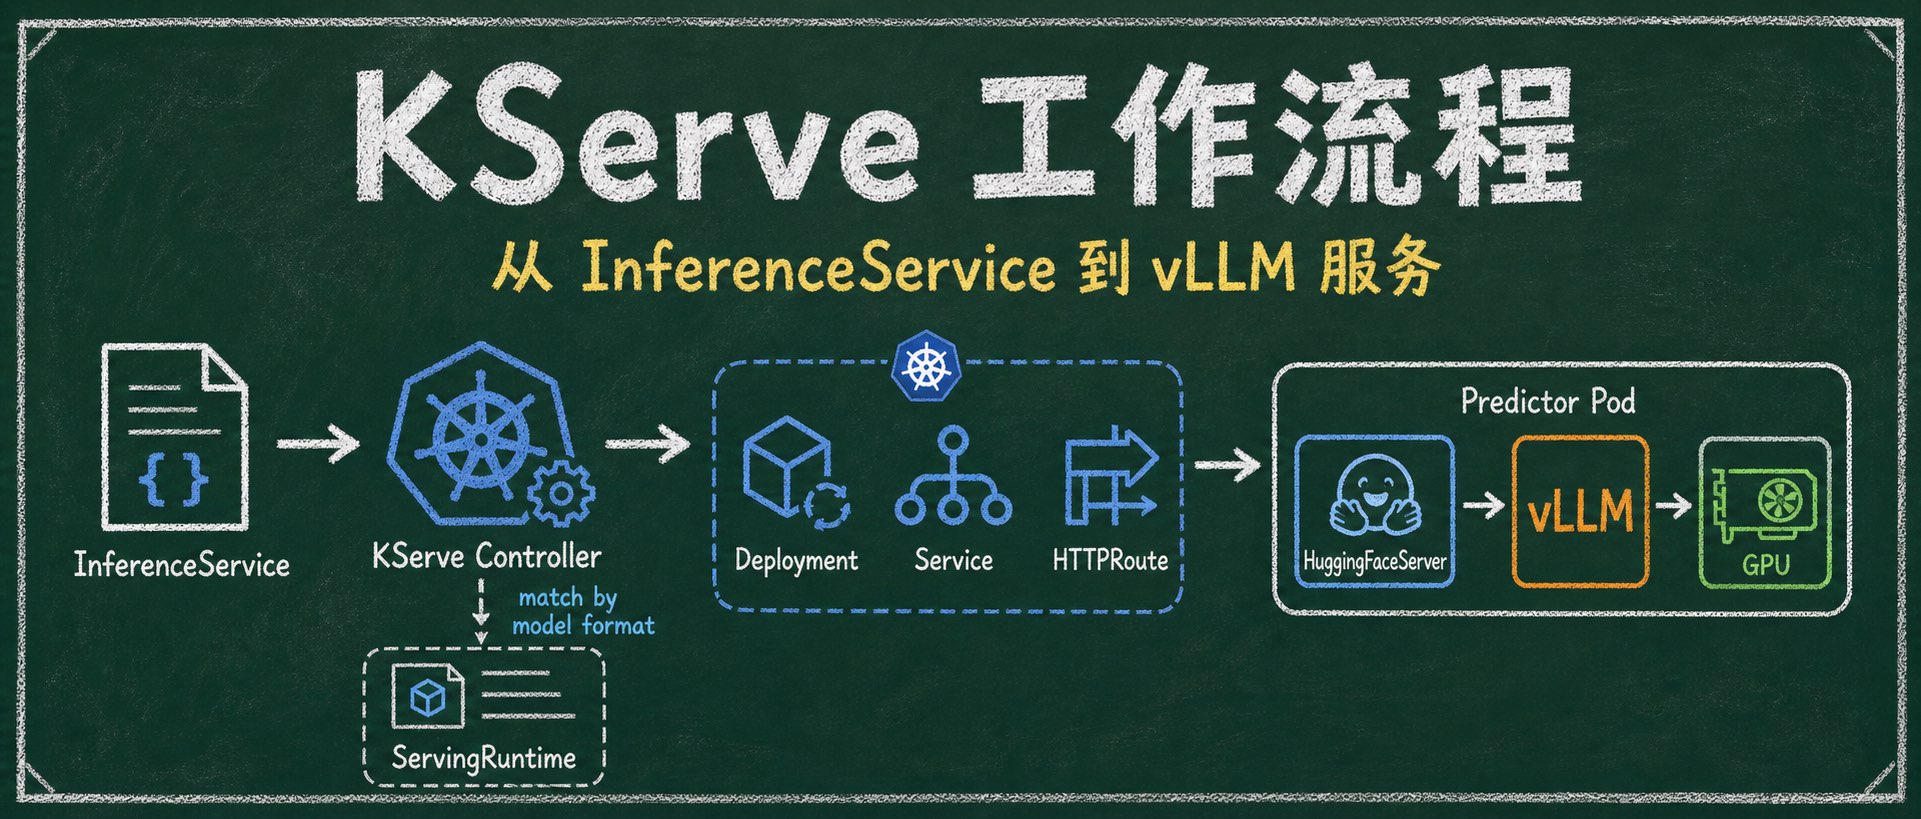
KServe是基于Kubernetes的AI推理平台,分为控制面和数据面。用户提交InferenceService后,Webhook校验配置,Controller根据modelFormat匹配ServingRuntime,合并配置创建Deployment、Service和HTTPRoute。Pod启动时注入PVC存储,HuggingFaceServer自动选择vLLM作为推理后端,加载模型并执行推理。请求经Envoy Proxy转发至Predictor Pod,由vLLM在GPU上完成推理。
vLLM是加速大语言模型推理的框架,实现KV缓存内存零浪费。本文提供Helm图表部署配置,并展示使用OpenAI入口点兼容Cohere SDK的Rerank API示例,通过vLLM服务BAAI/bge-reranker-base模型,演示v1和v2客户端调用重排序功能。
KServe是Kubernetes上的AI推理平台,用于管理模型服务。本文介绍从零安装KServe Standard模式和Envoy Gateway,通过PVC部署Qwen2.5-0.5B-Instruct模型。步骤包括安装cert-manager、Envoy Gateway、创建Gateway、安装KServe,然后下载模型、创建PV/PVC和InferenceService,最后通过OpenAI兼容接口请求API。KServe将模型地址、Runtime、GPU资源和访问入口统一收敛到InferenceService中,简化推理服务管理。
本文介绍了在Kubernetes环境中自托管大型语言模型(LLM)的设置,使用vLLM作为推理引擎,LINSTOR提供持久存储。自托管可降低成本、提高控制力,并满足数据合规要求。通过创建持久卷声明和密钥,部署vLLM推理服务器,确保模型权重缓存以加快重启速度,支持高并发请求,适合混合AI应用。
完成下面两步后,将自动完成登录并继续当前操作。