小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
DeepSeek-V4.1 模型结构(1):序列维度(上),CED

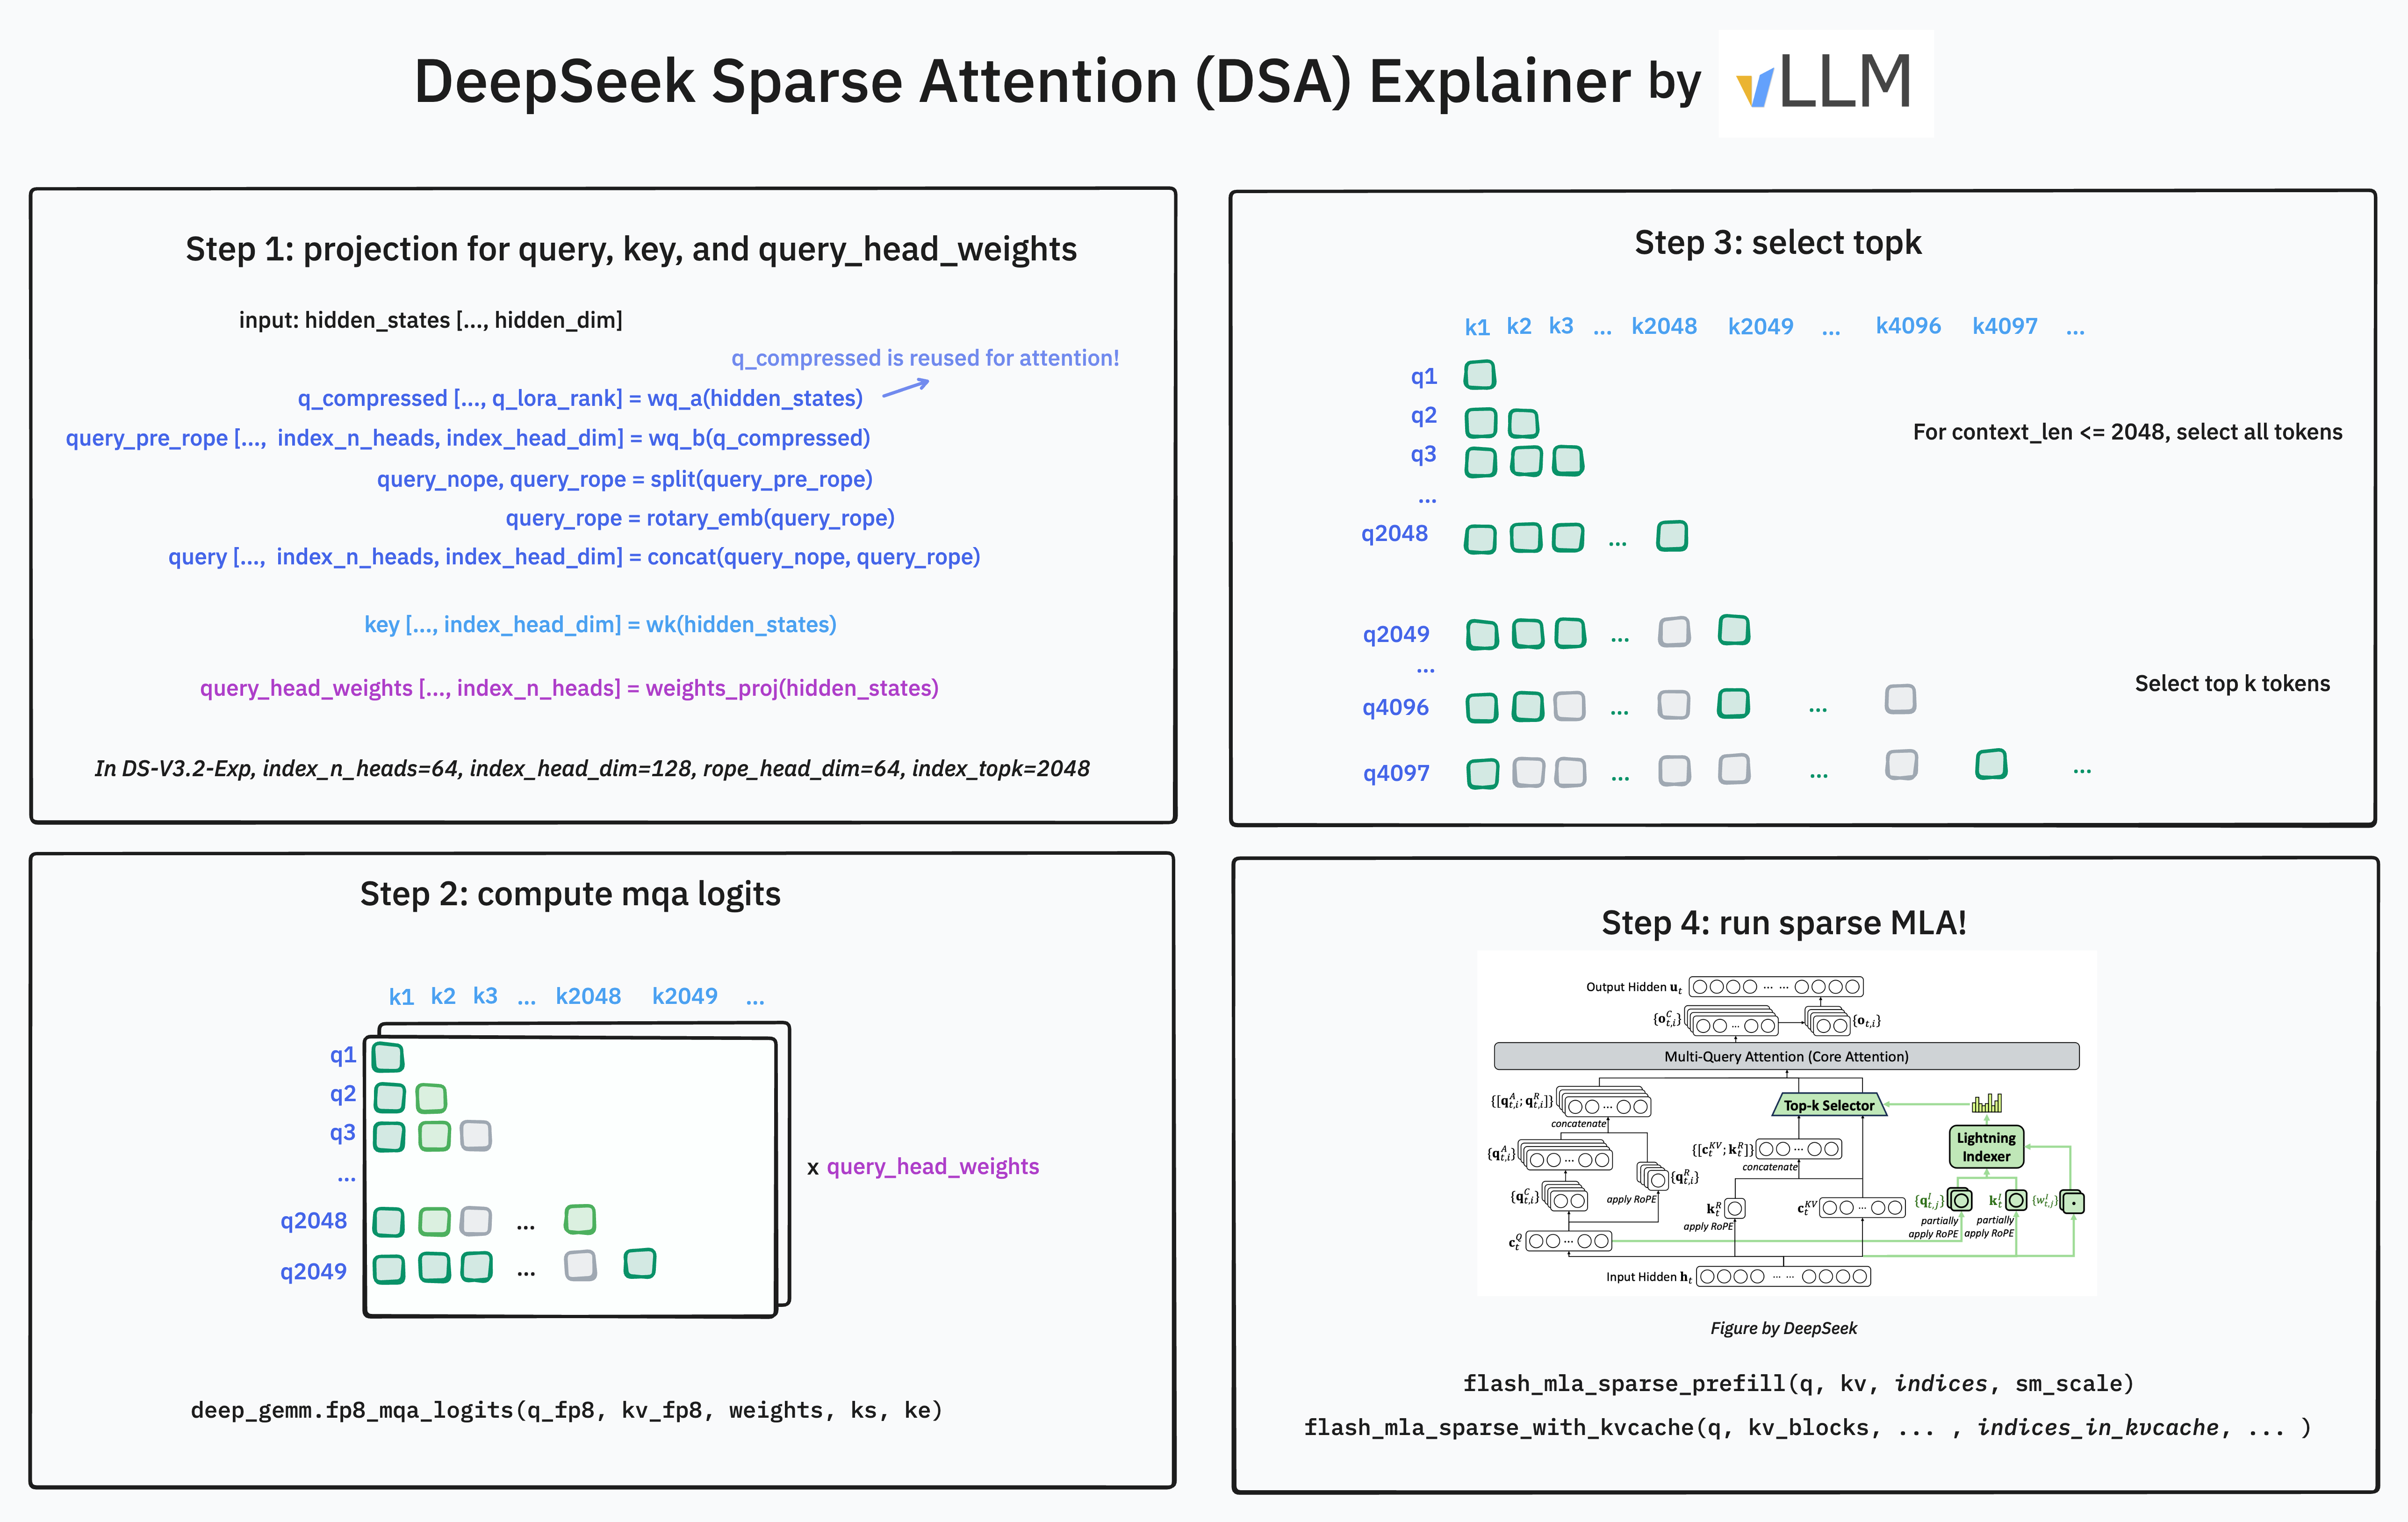
DeepSeek-V4.1 借鉴 YOCO,提出 CED 结构:decoder 的全局 KV 由 encoder 末态投影得到;prompt 中多数 token 只计算前 20 层,激活参数约 8B,而 decode 阶段使用全部 40 层,约 16B。为补充 decoder 滑窗 KV,采用 Decoder SWA Bounded Replay,仅回放最后 128 个 token,属于近似重建,但开销远低于精确重建。

DeepSeek-V4.1 模型结构(1):序列维度(上),CED

Java不加糖's Blog Java不加糖's Blog · 2026-10-02T12:10:00Z
HSTU在Dynamo-Triton中的AOTI与KV缓存验收方法

NVIDIA公布HSTU推荐部署流程,采用PyTorch AOTI编译、FlexKV缓存与Dynamo-Triton服务,八层模型满命中时延迟最高改善5.93倍,但收益取决于用户历史前缀复用率,50%命中时加速不足2倍。建议先验证输出一致性,再测试各命中率下的延迟、缓存失效与显存淘汰,并将推荐质量纳入验收,按每千次请求节省的GPU毫秒决策。

HSTU在Dynamo-Triton中的AOTI与KV缓存验收方法

Java for You Java for You · 2026-10-01T02:26:37Z
忆联与英特尔联合发布高性能KV Cache G3.5方案

2026英特尔技术创新与产业生态大会在苏州举行,忆联作为英特尔中国区首家国产SSD战略合作伙伴,联合发布面向Agentic AI时代的高性能KV Cache G3.5方案。该方案以至强6处理器为核心,基于UH812a企业级SSD构建分层KV Cache架构,将扩展容量从单卡HBM几十GB提升至系统级。忆联还展出UH713a、UH812c/UH832c、UM301a等企业级SSD产品。

忆联与英特尔联合发布高性能KV Cache G3.5方案

全球TMT-美通国际 全球TMT-美通国际 · 2026-09-24T08:05:56Z
100万Token不等于模型全记住:从KV Cache看懂长上下文成本

文章澄清上下文窗口与KV Cache的区别:前者是单次请求的容量上限,后者是自回归解码中缓存历史Key/Value、以空间换时间的计算账本。DeepSeek V4.1 Flash将全局KV Cache降至每Token约890字节,但整机显存还需计入权重、并发等。长上下文不等于召回准,也不等于长期记忆,部署需实测峰值显存与延迟。

100万Token不等于模型全记住:从KV Cache看懂长上下文成本

Java for You Java for You · 2026-09-16T01:14:43Z

提出KV Cache动态调节技术:部署时根据用户输入上下文动态调整显存占用,不再用--gpu-memory-utilization固定分配。按公式2GiB+tokens×87KiB计算,再按256MiB对齐。改动后Qwen 3.8 27B在512K与900K上下文下显存差距约30GB,可省出显存并行跑其他模型。

动态 KV Cache 技术分享

Andy Stewart Andy Stewart · 2026-09-15T16:00:00Z
DeepSeek-V4 模型结构(1):序列维度(上),从 MLA 到压缩 KV

本文介绍DeepSeek-V4的注意力机制,从MHA到CSA/HCA的演进,重点分析压缩KV缓存的方法。V4将每4或128个token压缩为一条512维KV向量,采用重叠窗口和逐通道softmax加权,K与V共享单头,配合分组输出投影降低参数。相比前代,V4首次压缩缓存条目数,以支持1M上下文的高效推理。

DeepSeek-V4 模型结构(1):序列维度(上),从 MLA 到压缩 KV

Java不加糖's Blog Java不加糖's Blog · 2026-09-05T18:20:00Z

本文介绍了TiDB集群的四个核心组件及其功能:TiDB负责SQL解析和请求路由,TiKV处理分布式事务和数据存储,PD管理元数据和调度,TiFlash提供列存分析副本。理解各组件的独立性和复杂性有助于排查性能问题。接下来将深入探讨TiKV的具体实现与机制。

【TiKV / HTAP 内核】HTAP / 分布式 KV 全景:TiDB–TiKV–PD–TiFlash 四件套

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-07-16T00:00:00Z

本文探讨了缓存架构中不同内存键值存储(KV)的特点及适用场景,包括进程内 HashMap、Memcached、Redis 和嵌入式 RocksDB。强调选择合适的缓存策略的重要性,指出 Redis 是内存数据结构服务器,支持多种数据类型和持久化,而 Memcached 则是纯分布式缓存。此外,文章提到学术界对 Redis 的定位争论。

【Redis / 缓存内核】缓存服务器全景:HashMap · Memcached · Redis · 嵌入 KV

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-07-13T00:00:00Z
KV缓存分析器

文章讨论了KV缓存分析器的功能,包括自定义追踪、缓存块大小设置和缓存驱逐策略(FIFO、LRU或最佳)。用户可以在浏览器中计算缓存命中率和缓存大小,并提供反馈或报告问题。

KV缓存分析器

Home | KVCache.ai Home | KVCache.ai · 2026-05-28T00:00:00Z
EpiCache:用于长对话问答的情节KV缓存管理

EpiCache是一种KV缓存管理框架,专为长对话问答设计,旨在优化在固定内存预算下的缓存增长。通过块状预填充和情节相关的KV压缩,EpiCache提高了准确性,减少了延迟和内存使用,支持高效的多轮交互。

EpiCache:用于长对话问答的情节KV缓存管理

Apple Machine Learning Research Apple Machine Learning Research · 2026-05-19T00:00:00Z
理解 KV Cache:Attention、P/D 分离与 vLLM 的页式显存管理

本文探讨了大语言模型中KV Cache的产生与管理及其在推理过程中的重要性。KV Cache通过缓存历史K/V向量,优化生成过程并减少计算复杂度。Prefill阶段处理所有输入,而Decode阶段逐步生成输出,二者需分离以提升性能。vLLM采用页式内存管理,解决内存碎片问题,提升存储效率,确保高效的推理系统。

理解 KV Cache:Attention、P/D 分离与 vLLM 的页式显存管理

Steins;Lab Steins;Lab · 2026-05-06T16:28:41Z
使用TurboQuant的高效KV压缩

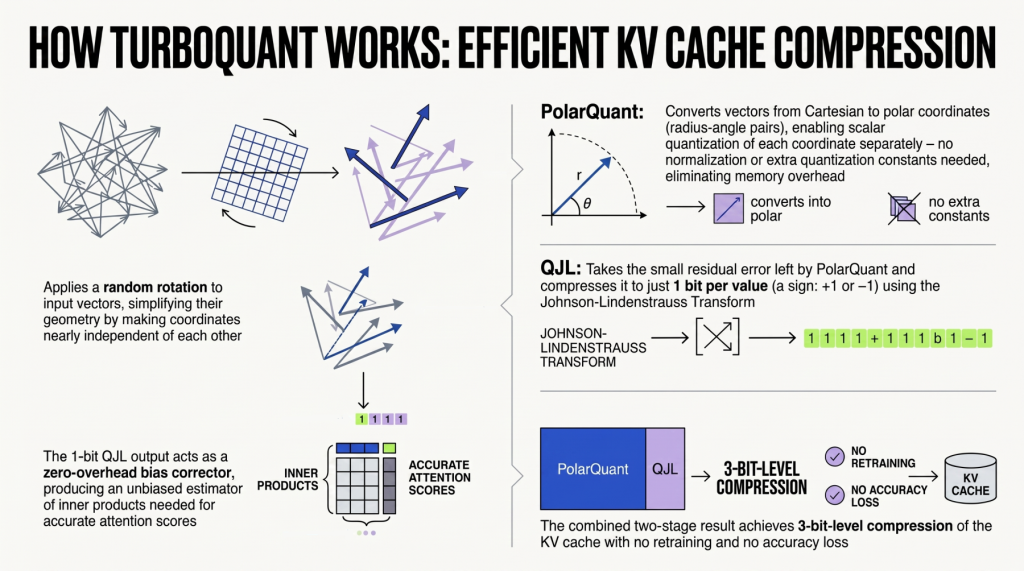
TurboQuant是谷歌推出的一种新算法套件,旨在高效压缩大型语言模型和向量搜索引擎,且不损失准确性。它采用两阶段压缩过程:PolarQuant和QJL,显著降低缓存内存消耗至3位。PolarQuant通过极坐标系统简化数据几何,消除内存开销,而QJL去除潜在偏差,确保高精度的注意力分数。TurboQuant提供了高效的KV缓存压缩解决方案。

使用TurboQuant的高效KV压缩

MachineLearningMastery.com MachineLearningMastery.com · 2026-04-30T12:00:11Z

本文介绍了如何使用Cloudflare Worker和KV为静态博客添加浏览量计数功能。作者选择Cloudflare Worker,因其免费额度充足且易于部署。通过简单的前后端代码,作者实现了文章和整站的浏览量统计,并解决了初始值展示问题,提升了博客的互动性。

用 Cloudflare Worker + KV 给静态博客加一个浏览量计数

碎碎念 碎碎念 · 2026-04-19T15:00:00Z

本文对比了etcd、TiKV和FoundationDB三种分布式键值存储系统。etcd适合小规模元数据存储,提供Watch和Lease机制;TiKV支持PB级数据水平扩展和分布式事务;FoundationDB提供严格可串行化事务和确定性模拟测试。选型需根据数据量、事务需求和一致性要求决定。

【分布式系统百科】分布式 KV 存储对比:etcd、TiKV 与 FoundationDB

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-04-13T00:00:00Z
Rockraft:基于 OpenRaft 与 RocksDB 的强一致 KV 存储框架

Redis协议已成为key-value存储的标准。为实现强一致性,作者创建了coredb项目,采用Raft算法和RocksDB。Rockraft框架解耦核心逻辑,支持开发者构建强一致性存储系统,使用Rust开发,具备高性能和安全性,支持条件事务,持续进化中。

Rockraft:基于 OpenRaft 与 RocksDB 的强一致 KV 存储框架

codedump的网络日志 codedump的网络日志 · 2026-04-12T01:59:41Z
Fast-WAM——训练时保留视频联合训练(虽同时生成但动作token不看视频token),在推理时则移除显式的未来视频生成,直接在单次前向中,依托得到的潜在世界表征KV Cache预测动作

研究者探讨了世界模型代理(WAM)在测试阶段是否需要显式未来想象,提出了Fast-WAM架构,训练时保留视频共训练,推理时跳过未来预测。结果显示,视频预测主要在训练阶段提升模型性能,而非在推理阶段生成未来观测。

Fast-WAM——训练时保留视频联合训练(虽同时生成但动作token不看视频token),在推理时则移除显式的未来视频生成,直接在单次前向中,依托得到的潜在世界表征KV Cache预测动作

结构之法 算法之道 结构之法 算法之道 · 2026-03-31T15:57:16Z
从提示到预测:理解大型语言模型中的预填充、解码和KV缓存

本文介绍了大型语言模型(LLM)推理的两个阶段:预填充和解码。预填充阶段通过并行处理整个提示,计算并存储每个令牌的键(K)和值(V)。解码阶段逐个生成令牌,使用新令牌的查询(Q)与缓存的键和值进行计算,从而提高解码效率,特别是在处理长提示和生成响应时。

从提示到预测:理解大型语言模型中的预填充、解码和KV缓存

MachineLearningMastery.com MachineLearningMastery.com · 2026-03-30T20:47:02Z
谷歌新论文把内存股价干崩了!KV cache压缩6倍,网友:硅谷成真了 profile-avatar

谷歌的新算法TurboQuant将AI推理中的KV缓存压缩了6倍,且无损精度,导致美光和西部数据股价大跌。该算法通过极坐标量化和量化JL变换,显著降低内存需求并提升速度,可能会改变AI的内存使用方式。

谷歌新论文把内存股价干崩了!KV cache压缩6倍,网友:硅谷成真了 profile-avatar

量子位 量子位 · 2026-03-26T03:03:26Z
LLMs中的KV缓存:开发者指南

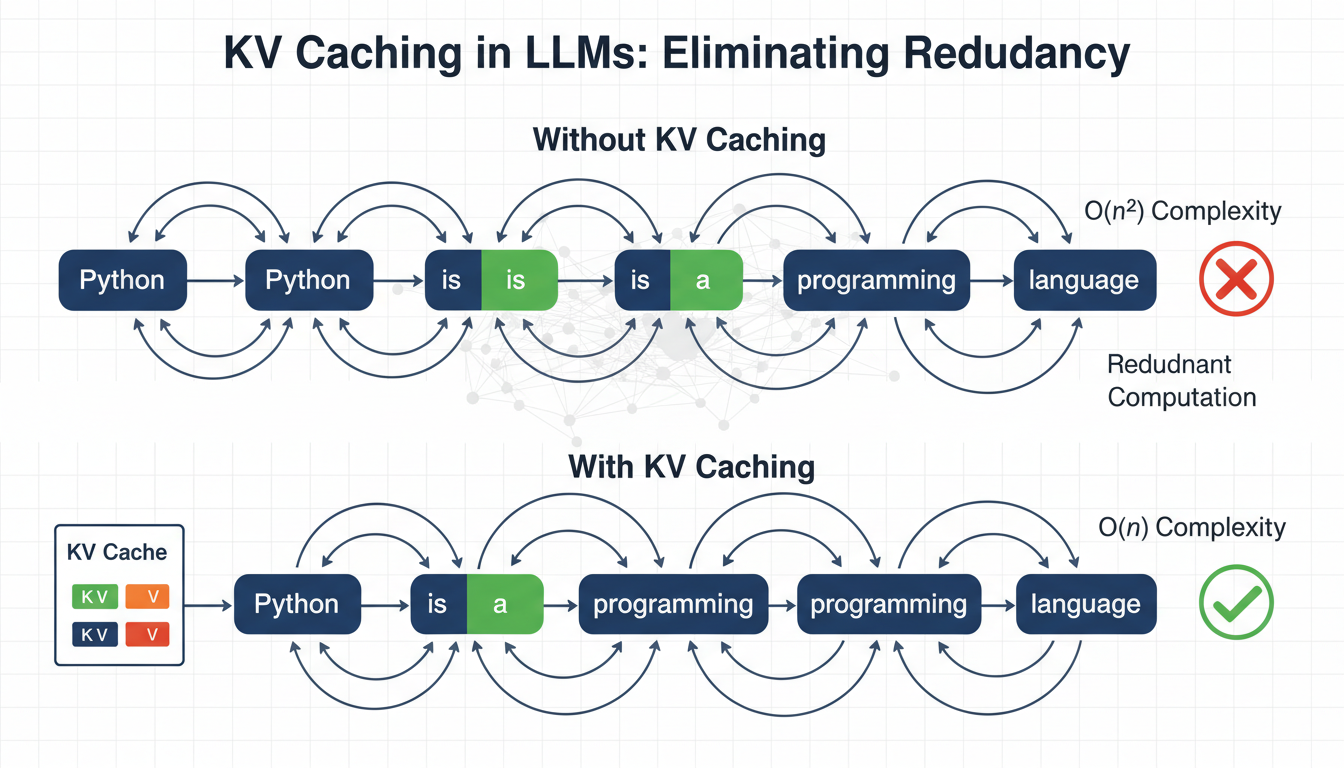
本文介绍了自回归变换器推理中键值(KV)缓存的作用,如何通过缓存已计算的键和值来消除冗余计算,从而显著提高生成速度,推理速度提升可达3-5倍。尽管内存使用增加,但在实际应用中,这种提升是值得的。理解KV缓存为进一步优化推理提供了基础。

LLMs中的KV缓存:开发者指南

MachineLearningMastery.com MachineLearningMastery.com · 2026-02-26T14:43:49Z
vLLM新KV卸载连接器内部揭秘:智能内存传输以最大化推理吞吐量

vLLM 0.11.0引入KV缓存卸载功能,将缓存转移至CPU内存(DRAM),提升推理吞吐量。通过缓存KV值,降低计算需求,改善请求延迟和每节点吞吐量。新API支持异步加载和存储KV数据,优化GPU与CPU间的数据传输,显著提升性能。

vLLM新KV卸载连接器内部揭秘:智能内存传输以最大化推理吞吐量

vLLM Blog vLLM Blog · 2026-01-08T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。
1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码